rss expert Log in

Anyone can read here. Sign in to reply, save and follow.

Everything

Pablo Murad pablomurad.com

Caso Revolut

A Revolut entregou informações pessoais de clientes a alguém que se apresentou como uma autoridade governamental. A solicitação era falsa, mas o endereço usado pertencia a um domínio oficial. A empresa reconheceu o episódio à imprensa em setembro de 2026. Entre os dados potencialmente divulgados estavam documentos de identidade e históricos de transações.

O que me incomoda neste caso é a distância entre duas promessas que costumamos tratar como se fossem a mesma coisa: proteger meu dinheiro e proteger minha vida privada. Uma conta pode continuar funcionando, sem nenhum saldo roubado, enquanto informações que identificam seu dono já estão nas mãos de outra pessoa.

Tenho visto essa notícia circular pela IndieWeb. Faz sentido que desperte atenção entre pessoas preocupadas com autonomia digital, mas a indignação não dispensa cuidado com os fatos. Não há confirmação de venda de dados, de exposição de todos os clientes ou de uma invasão aos sistemas da Revolut. O episódio conhecido é uma divulgação indevida por meio de um processo que deveria atender solicitações legítimas.

O que aconteceu e o que ainda não sabemos

Avisos enviados a clientes começaram a circular publicamente em setembro. O investigador ZachXBT divulgou o caso em seu canal, apontando para uma publicação de Mark Karpelès, que se identificou como afetado. Em 12 de setembro, o International Cyber Digest reuniu as informações que motivaram esta leitura.

Segundo o aviso compartilhado, a solicitação veio de uma conta não autorizada dentro da infraestrutura de um domínio governamental legítimo. A mensagem trazia credenciais válidas de autenticação do domínio. A Revolut atendeu ao pedido e posteriormente verificou com a agência que ele não era legítimo.

Um porta-voz confirmou ao The Block que uma terceira parte usou um endereço em domínio governamental para apresentar pedidos fraudulentos. A empresa informou ter bloqueado o remetente e comunicado o episódio à agência, à polícia e aos reguladores. Disse que um número limitado de clientes foi afetado e que seus sistemas e os recursos dos clientes não foram comprometidos.

Essa última garantia é uma declaração da Revolut. Não equivale a uma auditoria independente publicada.

Até a consulta de 14 de setembro de 2026, as fontes examinadas não identificavam a agência, o número exato de clientes nem a data em que os arquivos foram enviados. Também não explicavam como o terceiro conseguiu utilizar aquela conta. São lacunas relevantes: sem essas informações, não conseguimos avaliar completamente a duração da exposição, sua extensão ou se outras instituições receberam pedidos semelhantes.

ZachXBT sugeriu que o ataque parecia direcionado a usuários com patrimônio elevado. É uma avaliação do investigador, não uma seleção de vítimas confirmada pela empresa. Tampouco há base, nesses relatos, para afirmar que todo cliente que comprou Bitcoin pela Revolut foi atingido.

Por que um email legítimo pode carregar uma fraude

Um email autenticado não comprova a autoridade de quem pede os dados.

Um email autenticado não comprova a autoridade de quem pede os dados. Gravura externa de Gerrit Halfmann, Pixelarticons, licença MIT.

Quando pensamos em phishing, imaginamos um domínio parecido com o verdadeiro, uma letra trocada ou um remetente claramente estranho. Aqui, o problema descrito é diferente: a mensagem utilizava o domínio real de uma autoridade.

Isso ajuda a entender como uma mensagem pode passar por verificações técnicas e continuar sendo perigosa. A autenticação de email procura responder perguntas sobre o envio e o domínio. Ela não decide se a pessoa que apertou o botão tinha autorização para pedir meu passaporte.

SPF verifica se um servidor está autorizado a enviar mensagens para determinado domínio usado no transporte do email. DKIM permite conferir uma assinatura vinculada a um domínio e a integridade das partes assinadas. DMARC utiliza o alinhamento entre o domínio visível do remetente e resultados de SPF ou DKIM para aplicar a política publicada pelo domínio. São mecanismos úteis contra falsificação de remetentes, mas não substituem a validação de uma solicitação.

O RFC 9989, publicado em maio de 2026, deixa esse limite claro: autenticar o uso de um domínio não autentica a parte individual do endereço nem garante a qualidade ou a legitimidade do conteúdo. No caso Revolut, os avisos falam em autenticação válida do domínio, mas não publicam os cabeçalhos da mensagem. Portanto, não dá para afirmar que SPF, DKIM e DMARC passaram todos, individualmente.

Uma comparação simples: reconhecer que uma ligação saiu do telefone de uma repartição não prova que quem está falando pode requisitar os documentos de um cidadão. Ainda é preciso verificar quem pede, a finalidade e a autorização para aquele pedido específico.

Eu esperaria que informações tão sensíveis exigissem essa segunda verificação antes do envio. O relato público mostra que a fraude foi descoberta depois; não fornece detalhes suficientes para reconstruir cada controle interno ou dizer exatamente qual pessoa falhou.

O que os arquivos podem revelar

Documentos e registros de contato podem facilitar tentativas de personificação.

Documentos e registros de contato podem facilitar tentativas de personificação. Gravura externa de Gerrit Halfmann, Pixelarticons, licença MIT.

O aviso divulgado lista dados de identificação e contato, como nome, nascimento, ocupação, endereço, telefone e email. Também menciona cópias de documentos, selfie de verificação e registros financeiros: extratos, IBAN, informações da conta, saques e histórico de transações, incluindo Bitcoin. A lista descreve categorias potencialmente compartilhadas; não prova que todas foram enviadas para cada cliente.

Cada categoria tem uma utilidade diferente para um criminoso. Um endereço permite localizar alguém. Um extrato ajuda a criar uma abordagem convincente. Uma cópia de documento pode ser usada em tentativas de personificação. Reunidas, essas informações oferecem contexto para golpes que parecem conhecer a vida da vítima.

Imagine receber uma mensagem que menciona uma transferência real, seu nome completo e os últimos dados de um documento. Ela pode parecer uma continuação legítima de um atendimento. O detalhe verdadeiro funciona como argumento de confiança, mesmo quando o pedido seguinte é fraudulento.

Esse é um risco plausível da exposição, não a confirmação de um golpe já cometido contra os clientes deste episódio.

Há ainda uma distinção sobre a selfie. O aviso exclui a telemetria biométrica facial, mas inclui a imagem de verificação entre os dados potencialmente enviados. Uma foto do rosto e um modelo biométrico derivado dela são coisas diferentes. A ausência do segundo não torna a primeira irrelevante nem demonstra que será possível usá-la para vencer qualquer verificação de identidade.

Na definição explicada pelo regulador britânico ICO, uma violação de dados pessoais também pode envolver divulgação ou acesso não autorizado. Não é necessário que alguém tenha instalado malware ou invadido um banco de dados. A informação enviada ao destinatário errado já merece investigação e avaliação de impacto.

Por que o histórico de Bitcoin importa

Bitcoin não oferece anonimato automático. As transações registradas na blockchain são públicas, e os endereços não trazem, por si só, o nome civil de seus usuários. A privacidade depende em parte da dificuldade de estabelecer essas associações.

Um serviço financeiro pode conhecer a pessoa por trás de operações que, vistas isoladamente na rede, aparecem como movimentações entre endereços. Quando registros internos relacionam uma identidade a saques ou transferências, eles podem ajudar a conectar atividade financeira a uma pessoa identificável.

O alcance dessa associação depende do conteúdo efetivamente divulgado. Nem toda operação feita dentro de um aplicativo corresponde a uma transação individual na blockchain, e um registro de conta não revela automaticamente todas as carteiras de seu dono. Seria exagerado dizer que o incidente tornou público todo o patrimônio de cada afetado.

Mesmo assim, a combinação merece atenção. Saber quem é alguém, onde mora e quais movimentações realizou pode ser mais perigoso do que conhecer apenas uma dessas informações. Não há, nas fontes consultadas, confirmação de violência ou extorsão decorrente deste caso. Tratar essas possibilidades como acontecimentos seria acrescentar medo sem evidência.

A coleta de documentos também cria uma obrigação de cuidado

KYC é a sigla de Know Your Customer, expressão usada para os procedimentos de identificação de clientes. Instituições financeiras precisam cumprir exigências de prevenção à lavagem de dinheiro e outros deveres regulatórios. A própria Revolut explica que pode solicitar documentos para verificar pessoas e operações.

Isso contextualiza a coleta. Não justifica a entrega a um impostor.

Tenho dificuldade com a ideia de que acumular mais informações seja, por si só, sinônimo de segurança. Para o cliente, entregar documentos pode ser uma condição de acesso ao serviço. Para a instituição, cada cópia mantida aumenta o material que precisa ser protegido e controlado, inclusive nos processos administrativos de divulgação.

A discussão útil não se encerra em dizer que todo KYC é inútil ou que qualquer crítica ignora a lei. É possível reconhecer a obrigação de identificar clientes e exigir limites para a coleta, acesso restrito, retenção justificada e verificação rigorosa de destinatários. A finalidade declarada não elimina os riscos do armazenamento.

Também não dá para presumir que encerrar a conta apague imediatamente esse acervo. Na página de suporte do Reino Unido, a Revolut informa que certos dados precisam ser mantidos por pelo menos seis anos e podem permanecer por mais tempo por motivos legais. Prazos e regras variam conforme a entidade e a jurisdição. Quem deseja sair precisa verificar a política aplicável à própria conta, não uma regra encontrada para outro país.

O direito de pedir exclusão tampouco significa que todo dado terá de ser apagado sem exceção. Uma solicitação concreta pode perguntar quais categorias permanecem, por quanto tempo e com qual fundamento.

A fraude não começou com a Revolut

Em novembro de 2024, o FBI alertou sobre o uso de emails governamentais comprometidos para apresentar falsas solicitações emergenciais de dados a empresas. Esse tipo de pedido procura explorar procedimentos destinados a situações urgentes.

O antecedente ajuda a entender o risco de confiar apenas na aparência institucional de um remetente. Não prova que a solicitação à Revolut era emergencial. As fontes públicas examinadas não estabelecem esse detalhe, e não devemos importar para este incidente tudo o que sabemos sobre ataques parecidos.

A orientação geral do FBI sobre fraudes por email inclui verificar pedidos por um canal independente. Aplicada a dados pessoais, a recomendação faz sentido: confirmar a autoridade por um contato previamente conhecido, em vez de usar o telefone ou o link fornecido na própria mensagem suspeita. Essa é uma recomendação de controle, não uma descrição do procedimento que a Revolut adotava.

Outros cuidados seriam limitar os dados à finalidade comprovada e registrar quem autorizou a divulgação. A pergunta importante para uma instituição não é somente se o email chegou de um domínio verdadeiro. É se aquela pessoa pode receber aqueles arquivos naquela situação.

O que isso tem a ver com a IndieWeb

A IndieWeb parte da vontade de ter mais controle sobre a própria presença digital. Manter um site próprio, publicar fora de plataformas fechadas e reduzir dependências não resolve todos os problemas de privacidade, mas torna algumas decisões menos dependentes de empresas.

Vejo uma ligação direta com o desconforto causado por este caso. Podemos escolher o que publicamos em um blog e ainda depender de terceiros para guardar documentos, movimentações e informações pessoais que não queremos tornar públicas. Ter domínio próprio não nos dá controle sobre o processo de divulgação de dados de um banco.

Essa limitação não invalida a autonomia digital. Ela ajuda a enxergá-la sem fantasia. O controle varia conforme o contexto, e há relações em que o usuário não consegue simplesmente hospedar sua própria alternativa. Por isso, reduzir dados desnecessários e cobrar responsabilidade institucional continua importante mesmo para quem já saiu das grandes redes sociais.

Também prefiro que a circulação independente de notícias preserve a diferença entre evidência e opinião. Um post indignado pode apontar uma falha real e exagerar sua extensão na mesma frase. Compartilhar a origem, conferir a resposta posterior da empresa e corrigir uma manchete imprecisa fazem parte do cuidado com a informação.

Como agir sem cair em um segundo golpe

Proteção da conta e proteção de dados pessoais exigem cuidados diferentes.

Proteção da conta e proteção de dados pessoais exigem cuidados diferentes. Gravura externa de Gerrit Halfmann, Pixelarticons, licença MIT.

Quem recebeu um aviso deve primeiro confirmar sua autenticidade pelo aplicativo ou por um canal oficial acessado diretamente. Uma notícia de exposição cria uma oportunidade para mensagens falsas de suporte, promessas de remoção de dados e pedidos de nova verificação.

Vale guardar o aviso e solicitar esclarecimentos sobre a própria situação: quais dados foram divulgados, quando ocorreu o envio e quais medidas de proteção estão disponíveis. O contato com o encarregado de proteção de dados pode ajudar a formalizar essas perguntas. A Revolut publica o endereço dpo@revolut.com em suas páginas de privacidade.

Reforçar a proteção da conta e do email continua sendo prudente. Mas mudar uma senha não recolhe um documento já enviado. São problemas diferentes, que exigem respostas diferentes.

Eu teria atenção especial a mensagens que demonstram conhecer transações verdadeiras e em seguida pedem códigos, acesso remoto ou transferências para uma suposta conta segura. Não enviar novas cópias de documentos por contatos improvisados é uma precaução importante. Havendo tentativa de fraude ou ameaça, preserve as evidências e procure os canais oficiais adequados ao seu país.

Quem não recebeu uma notificação não deve concluir, apenas pela notícia, que seus dados foram enviados. Também não precisa aceitar tranquilizações vagas. Pode acompanhar as atualizações e pedir informação individual pelos canais da instituição.

A segurança precisa incluir o destino dos dados

O dinheiro continuar na conta é relevante. Para mim, porém, isso não encerra uma resposta sobre privacidade. Quero saber também quem recebeu meus documentos e o que foi feito para impedir uma divulgação indevida.

O caso Revolut expõe um problema de confiança em solicitações aparentemente oficiais. Sistemas de autenticação ajudam a verificar domínios; decisões sobre autoridade, finalidade e acesso precisam de outros controles. Até que a investigação esclareça os detalhes, essa é a conclusão sustentada pelos relatos públicos, sem transformar hipóteses em fatos.

Uma instituição que exige conhecer seu cliente precisa ser igualmente cuidadosa ao decidir quem pode conhecer os dados dele.

Fontes

Apuração consultada em 14 de setembro de 2026. Os relatos descrevem uma investigação em andamento.

International Cyber Digest · Relato que motivou o artigo

The Block · Confirmação da Revolut e alcance ainda não divulgado

ZachXBT · Alerta público e referência ao aviso compartilhado

IETF · RFC 9989 e limites da autenticação DMARC

FBI e CISA · Alerta de 2024 sobre falsas solicitações emergenciais

FBI · Verificação independente em fraudes por email

ICO · Definição de violação de dados pessoais

Bitcoin.org · Transparência das transações e privacidade

Revolut · Identificação de clientes e restrições regulatórias

Revolut Reino Unido · Retenção e solicitação de exclusão

Revolut · Informações e canais de privacidade

IndieWeb · Autonomia e controle da presença digital

Pixelarticons · Imagens externas de Gerrit Halfmann com licença MIT

Read more

Pablo Murad pablomurad.com

O Claude certo

Claude Shannon entre bits e monociclos

Claude Shannon ajudou a construir as bases do mundo digital e ainda encontrou tempo para fazer malabarismo num monociclo pelos corredores de um laboratório. Eu gosto desse detalhe porque ele estraga uma imagem muito conveniente: a de que gente brilhante precisa passar a vida fazendo cara de reunião importante.

O sujeito estudou como transmitir informação, como máquinas poderiam jogar xadrez e como um ratinho mecânico poderia aprender um caminho. Também construiu uma caixa que se desligava quando alguém a ligava. Uma máquina com uma política de atendimento admiravelmente clara. Hoje, muita gente encontra seu primeiro nome numa janela de conversa: Claude, o assistente da Anthropic. Existe uma ligação com Shannon nessa escolha, segundo relatos sobre a empresa. Mas a história do homem é muito melhor que a curiosidade de batismo. Para entendê-la, vale voltar a um tempo em que um computador podia ocupar uma sala e ainda assim não conseguir abrir quarenta abas para fingir que estava trabalhando.

O menino que usou a cerca como rede

Claude Elwood Shannon nasceu em Petoskey, Michigan, em 30 de abril de 1916, e cresceu em Gaylord. Gostava de desmontar objetos, construir rádios e experimentar com eletricidade. Fez até um sistema de telégrafo usando cercas de arame das fazendas. A infraestrutura era rural. A vontade de mandar sinal para longe, nem tanto.

Em 1936, saiu da Universidade de Michigan com formação em matemática e engenharia elétrica. No MIT, trabalhou com o analisador diferencial, uma enorme máquina analógica que resolvia problemas matemáticos com mecanismos físicos. Engrenagens e circuitos conviviam naquele equipamento, e Shannon precisava entender os dois.

Foi olhando para os relés, interruptores controlados eletricamente, que ele ligou duas coisas que costumavam viver em departamentos separados: circuitos e a álgebra de George Boole. Verdadeiro ou falso. Aberto ou fechado. Uma relação que parece óbvia depois que alguém a demonstra e nada óbvia antes disso.

Sua tese de mestrado, escrita em 1937, mostrou como usar lógica booleana para analisar e simplificar circuitos de comutação. Pense em duas chaves em série: a corrente só passa se as duas permitirem. Isso corresponde a um E lógico. Em paralelo, basta uma das alternativas permitir a passagem: um OU. Era possível raciocinar sobre o circuito antes de montá-lo.

Você encontra essa lógica quando escreve uma condição em código. Shannon não inventou sozinho o computador nem os números binários. Ele estabeleceu uma ponte fundamental entre a lógica e a construção de circuitos digitais. Em 1940, concluiu no MIT o mestrado em engenharia elétrica e o doutorado em matemática, este com uma pesquisa sobre genética teórica.

Sim, genética. O currículo dele tinha dificuldade para permanecer numa única pasta.

Bell Labs e o problema de fazer a mensagem chegar

Shannon entrou em Bell Labs em 1941. O laboratório, ligado ao sistema telefônico americano, tinha um problema muito concreto: fazer sinais chegarem ao destino com qualidade e eficiência. Não adiantava transmitir uma mensagem depressa se ela chegasse parecendo um liquidificador lendo um contrato.

Ali havia uma combinação rara de problemas industriais, recursos e pesquisa fundamental. O transistor surgiu em Bell Labs em 1947. Décadas depois, o Unix também nasceria naquele ambiente. Shannon fazia parte desse ecossistema, não de uma história em que um homem acorda inspirado e inventa toda a modernidade antes do café.

Durante a Segunda Guerra Mundial, trabalhou com sistemas de controle de tiro e criptografia. Também conheceu Alan Turing em Bell Labs. A aproximação entre os dois envolvia o interesse por máquinas e comunicação, mas seria errado transformar esse encontro numa parceria responsável por tudo o que hoje chamamos de inteligência artificial.

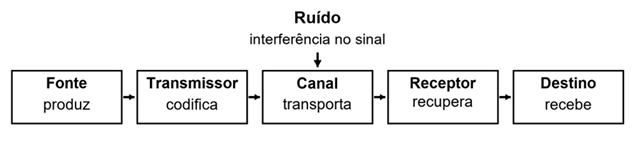
Em 1948, Shannon publicou A Mathematical Theory of Communication no Bell System Technical Journal. Sua pergunta central era como reproduzir, num ponto, uma mensagem escolhida em outro. Telefonia, texto e imagens podiam ser estudados dentro de um mesmo modelo: uma fonte produz a mensagem, um transmissor a transforma em sinal, um canal a transporta e um receptor tenta recuperá-la. No caminho, entra o ruído.

O ruído é a parte que não foi convidada. Como numa conversa em que você pergunta a hora e recebe junto uma motocicleta sem escapamento.

O modelo de comunicação de Shannon, em versão simplificada. O ruído interfere no sinal, não avalia se a mensagem é verdadeira. Diagrama original.

Em 1949, Communication Theory of Secrecy Systems levou esse raciocínio para a criptografia. Shannon formalizou o sigilo perfeito: observar a mensagem cifrada não deve revelar informação sobre qual mensagem original foi enviada. A teoria explica condições de segurança do uso de uma chave verdadeiramente aleatória, de comprimento adequado e não reutilizada. Isso não transforma qualquer senha comprida em magia. A matemática é bem menos impressionável que um formulário de cadastro.

Bits sem dor de cabeça

Um bit é um dígito binário, 0 ou 1. Também é uma unidade para medir informação. Um sistema com duas posições distinguíveis pode armazenar um bit. Com duas dessas unidades, temos quatro combinações possíveis: 00, 01, 10 e 11.

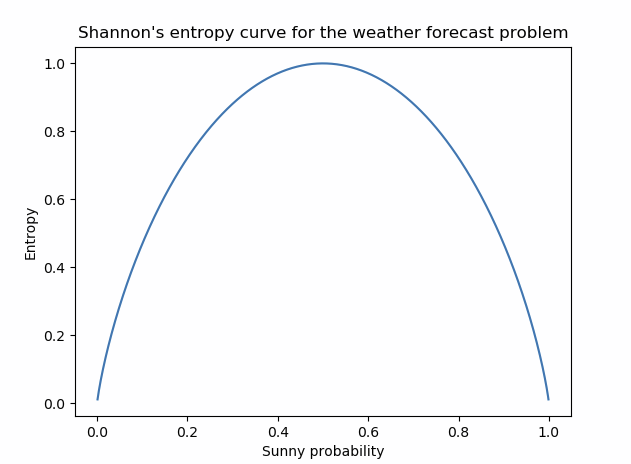
Um cuidado histórico: a palavra bit foi sugerida por John Tukey, como Shannon reconhece no próprio artigo. Dar ao homenageado o crédito dos colegas seria uma maneira bastante ruim de homenageá-lo. O trabalho de Shannon tornou precisa a relação entre informação, incerteza e capacidade de transmissão. Uma escolha entre duas possibilidades igualmente prováveis corresponde a um bit de informação. Quando certas possibilidades são mais frequentes, essa distribuição importa. A entropia mede a incerteza média da fonte, não o valor emocional ou a inteligência de uma mensagem.

Se uma máquina sempre responde a mesma coisa, sua resposta é previsível. Se pode produzir muitas alternativas com probabilidades parecidas, há mais incerteza. Nos dois casos, o conteúdo pode ser sensato ou completamente idiota. Entropia não é um diploma.

Essa distinção é deliciosa e necessária: informação, nesse sentido matemático, não é sinônimo de significado ou verdade. Uma mentira pode ser transmitida com absoluta fidelidade. O canal fez seu trabalho. O problema está em quem abriu a boca.

Shannon mostrou também que um canal tem uma capacidade limitada. Dentro das hipóteses do modelo, é possível transmitir abaixo dessa capacidade com probabilidade de erro tão pequena quanto se queira, usando codificação adequada e blocos suficientemente longos. Isso não promete internet sem falhas, velocidade infinita nem resposta instantânea. Confiabilidade tem condições e custos.

Há duas ideias úteis aqui. Para economizar espaço, aproveitamos padrões e reduzimos redundância: compressão. Para resistir ao ruído, acrescentamos redundância organizada que ajuda a detectar ou corrigir erros. Parece contraditório, mas são objetivos diferentes. É como encurtar uma encomenda e ainda assim protegê-la para a viagem. Shannon demonstrou limites e possibilidades. Construir códigos práticos e equipamentos capazes de explorá-los exigiu décadas de trabalho de muita gente. É por isso que sua teoria aparece nas bases da comunicação digital sem que ele tenha inventado o Wi-Fi, o streaming ou o vídeo que seu tio acabou de encaminhar.

Um rato antes do chatbot

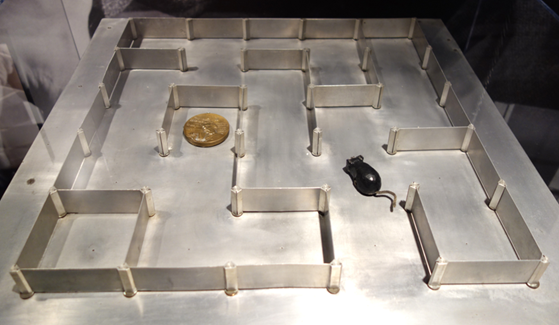
Em 1950, Shannon criou Theseus, um camundongo magnético que explorava um labirinto e encontrava um objetivo. Depois da tentativa e erro, o sistema guardava informações sobre o percurso e podia repetir o caminho aprendido.

Labirinto de Theseus no MIT Museum. O sistema de relés controlava o camundongo e armazenava informações sobre o percurso. Foto de Daderot, 2013, CC0.

O detalhe importante está debaixo da mesa: o controle e a memória ficavam num conjunto de relés escondido pelo labirinto. O ratinho não carregava um cérebro autônomo na cabeça. O mecanismo podia parecer mágico para quem olhava de cima, mas a explicação estava no aparato inteiro.

Era um experimento inicial de aprendizado de máquina. Chamar Theseus de primeiro chatbot seria absurdo. Chamar de demonstração de que uma máquina podia ajustar seu comportamento com base na experiência faz muito mais sentido. Ele não escrevia e-mail, mas também não inventava uma reunião que ninguém marcou.

Betty Shannon merece entrar nessa história pelo trabalho que fez. Mary Elizabeth Moore era analista numérica em Bell Labs e se casou com Claude em 1949. Colaborou com cálculos e projetos; segundo o relato familiar republicado pela IEEE Information Theory Society, fez grande parte do cabeamento de Theseus. A biografia fica mais interessante quando a colaboradora deixa de aparecer apenas como esposa do gênio.

No mesmo ano de 1950, Shannon publicou Programming a Computer for Playing Chess. Tratou a escolha de jogadas como um problema de busca e avaliação. O xadrez oferecia regras claras, mas um número enorme de alternativas. Para uma máquina, experimentar tudo indiscriminadamente não era uma estratégia muito promissora.

Ele foi também um dos quatro autores da proposta de 1955 para o encontro de verão de Dartmouth, realizado em 1956, junto com John McCarthy, Marvin Minsky e Nathaniel Rochester. O encontro virou um marco da organização da inteligência artificial como campo de pesquisa. Portanto, a ligação de Shannon com IA não depende de uma empresa moderna ter gostado do nome dele.

Afinal por que o Claude se chama Claude

O Claude da Anthropic foi apresentado publicamente em 14 de março de 2023. A ligação do nome com Shannon aparece em relatos sobre a cultura interna da companhia. Numa reportagem publicada em fevereiro de 2026, o New Yorker descreve a escolha como uma referência parcial a ele e também como preferência por um nome amistoso.

Cabe uma ressalva pequena: o anúncio oficial da Anthropic não explica a origem do nome. A homenagem é relatada na reportagem, não numa declaração direta dos fundadores ali apresentada. Eu prefiro essa precisão a tratar uma história repetida como se viesse com certidão registrada em cartório.

Há uma ligação intelectual mais interessante. No artigo de 1948, Shannon construiu exemplos de texto que se aproximavam do inglês conforme incorporavam frequências e relações entre letras ou palavras. Em 1951, estudou a previsão da próxima letra a partir do texto anterior para estimar a entropia da língua. O contexto tornava certas continuações mais previsíveis.

Isso lembra uma ideia importante nos modelos de linguagem atuais: aprender regularidades para prever continuações. Mas os sistemas da Anthropic usam redes neurais treinadas em grande escala e técnicas desenvolvidas muito depois. Os experimentos de Shannon não eram um Claude pequeno esperando uma placa de vídeo melhor.

A homenagem aproxima os nomes. A história da ciência aproxima algumas perguntas. Nenhuma das duas coisas autoriza dizer que Shannon criou o assistente ou que a teoria da informação, sozinha, explica tudo o que ele faz.

A oficina tinha menos juízo que o laboratório

Shannon voltou ao MIT como professor visitante em 1956, assumiu uma cátedra em 1958 e se tornou professor emérito em 1978. A carreira acadêmica continuou, assim como o gosto por dispositivos que dificilmente sobreviveriam a uma reunião de orçamento.

Construiu um W. C. Fields mecânico que fazia malabarismo, criou frisbees impulsionados por foguetes e trabalhou numa máquina capaz de resolver o cubo de Rubik. A documentação do MIT também registra seus passeios de monociclo com três bolas em movimento. Fazer isso sem cair já seria currículo suficiente para mim. Ele ainda tinha a teoria da informação.

A curiosidade também andava sobre uma roda. Gravura original em pixel art, gerada com IA.

A famosa máquina inútil talvez seja seu objeto mais engraçado. A ideia foi de Marvin Minsky, como o próprio Minsky contou: ligar o interruptor fazia uma mão sair da caixa, desligá-lo e se recolher. Shannon construiu uma versão. Pronto. O equipamento inteiro existia para recusar educadamente a própria existência.

Eu respeito uma máquina que informa seu desinteresse sem abrir um chamado.

Com Edward Thorp, Shannon desenvolveu em 1960 e 1961 um computador vestível para estimar o setor em que uma bola de roleta cairia. Havia comandos acionados pelos dedos dos pés e sinais sonoros no ouvido. Era previsão baseada no movimento físico, não uma garantia sobre um número exato.

A dupla testou o aparelho e foi a Las Vegas em 1961. Só que os fios frágeis do fone atrapalharam o uso continuado. Esse final me parece muito honesto: você reúne matemática brilhante, engenharia inventiva e um cassino inteiro, e a parte que estraga a festa é o cabo.

A curiosidade ficou

Shannon recebeu, entre outras distinções, a Medalha Nacional de Ciência dos Estados Unidos em 1966 e o Prêmio Kyoto em 1985. Morreu em 24 de fevereiro de 2001, aos 84 anos, após conviver com Alzheimer. Nesse ponto, as piadas podem descansar.

O que me chama atenção nessa vida é a liberdade de levar uma pergunta a sério sem exigir que ela tenha aparência respeitável. Um circuito, uma língua e um malabarista ofereciam problemas diferentes, e Shannon queria entender como funcionavam. Nós ainda usamos essa vontade de entender quando comprimimos um arquivo, recuperamos uma mensagem ou investigamos o comportamento de uma máquina. A parte do monociclo continua opcional. Felizmente.

Linha do tempo

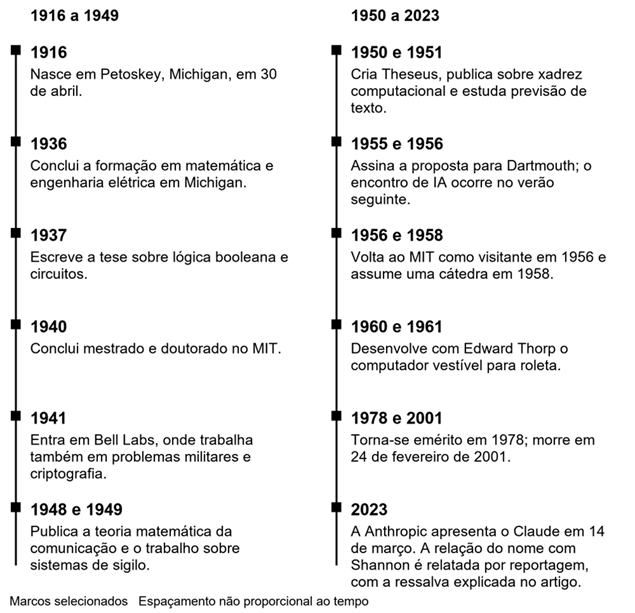
Leia a coluna esquerda e depois a direita. A criação de Theseus é de 1950; a identificação do objeto fotografado traz a data de 1952.

E é isso, se você leu até aqui, meus parabéns.

Até a próxima!

Read more

Pablo Murad pablomurad.com

Hospedagem privada na web aberta

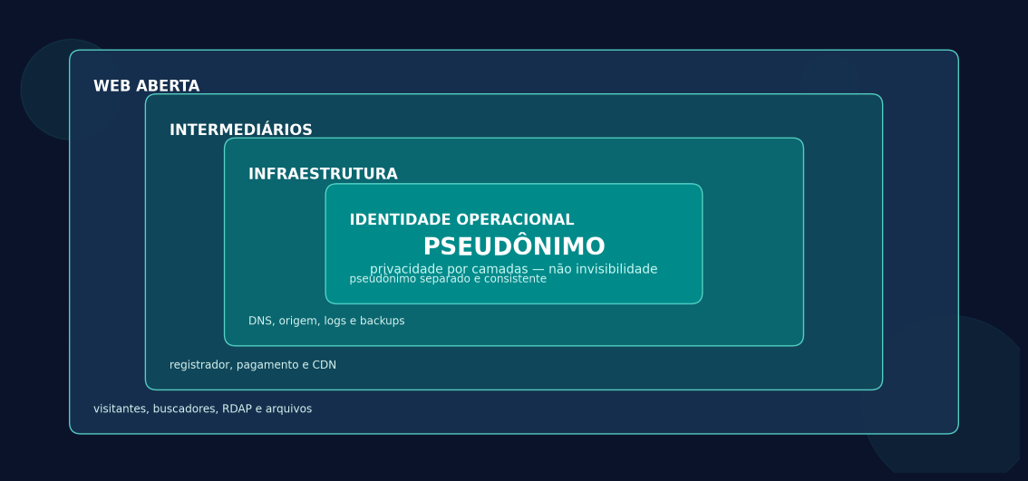
Figura 1 — A identidade pública é apenas a camada central; intermediários e infraestrutura ainda observam partes diferentes da operação.

O que um WHOIS “sem nada” realmente significa

Desde 28 de janeiro de 2025, o RDAP é a fonte definitiva para dados de registro de domínios genéricos, substituindo o WHOIS. Um resultado público com campos “REDACTED” ou quase vazios normalmente significa que a publicação foi limitada; não significa que os dados deixaram de existir.

A política da ICANN em vigor desde 21 de agosto de 2025 permite ou exige redação de dados pessoais em certas situações, mas também prevê processos de solicitação de divulgação e retenção. A própria política diz que registradores podem processar informações adicionais, inclusive dados de pagamento, e devem considerar pedidos de divulgação devidamente formulados.

REGRA DE OURO

Privacidade pública responde “o que um curioso encontra?”. Anonimato contra provedores responde “quem pode ligar a conta a mim?”. São problemas diferentes. Este guia otimiza o primeiro e reduz — sem eliminar — o segundo.

Modelo de ameaça

Antes de comprar qualquer serviço, defina contra quem você está se protegendo. A EFF recomenda começar por ativos, adversários, impacto, probabilidade, custo aceitável e aliados. A pergunta “quero que ninguém saiba” precisa virar uma lista verificável.

Adversário

O que ele usa

Meta realista

Proteção esperada

Visitante curioso

RDAP, DNS, cabeçalhos e conteúdo

Ocultar nome, endereço e origem

Alta

Pesquisador OSINT / doxxer

Histórico DNS, commits, metadados, nomes de usuário

Evitar correlações acidentais

Média a alta, se houver disciplina

Registrador, host, CDN e pagamento

Cadastro, acesso, faturamento e logs

Minimizar dados e pontos de confiança

Baixa a média

Autoridade com processo legal

Pedidos de divulgação, apreensão e cooperação

Nenhuma promessa de invisibilidade

Fora do objetivo deste guia

Passo 1 — Crie uma identidade operacional separada

O maior vazamento raramente é criptográfico. É a reutilização: o mesmo nome de usuário, avatar, e-mail de recuperação, chave SSH, conta de Git, estilo de biografia ou horário de publicação que você já usa com seu nome real.

·         Escolha um pseudônimo e nomes de usuário que nunca tenham aparecido nas suas contas pessoais.

·         Crie um e-mail inicial independente do domínio; assim, a recuperação não depende de um domínio que pode expirar ou ser suspenso.

·         Use uma senha única e longa, guardada em um gerenciador, e ative TOTP ou chave física. Evite SMS quando houver alternativa.

·         Mantenha um perfil de navegador ou sistema separado. Para painéis web, use Tor Browser quando o serviço permitir; nunca entre em contas pessoais na mesma sessão.

·         Não invente dados onde o contrato exigir dados corretos. Prefira um serviço legítimo de privacidade/proxy ou um modelo fiduciário que publique os dados dele por contrato.

·         Documente a separação: e-mail, contas, chaves, método de recuperação, data de renovação e quais empresas conhecem cada dado.

O Tor Browser reduz a exposição do IP, mas não garante anonimato perfeito. Ele protege apenas aplicativos corretamente configurados para usar Tor; preencher um formulário com nome, telefone ou e-mail pessoal entrega a identidade ao serviço de qualquer maneira.

Passo 2 — Escolha a estratégia de domínio

Há três modelos comuns. A diferença decisiva não é estética: é quem aparece como titular e quem conserva poder jurídico e operacional sobre o domínio.

Modelo

O que aparece no RDAP

Quem controla o domínio

Trade-off

Registrador com redação

Campos pessoais redigidos; alguns dados técnicos permanecem

Você é o titular

Bom equilíbrio; registrador ainda conhece seus dados

Serviço privacy/proxy

Dados do serviço ou contato intermediado

Você mantém direitos conforme contrato

Leia regras de revelação, transferência e abuso

Modelo fiduciário / trustee

O intermediário figura como titular

O intermediário é o registrante formal

Escudo público mais forte; maior risco de dependência e disputa

Checklist antes de registrar

·         A extensão escolhida permite privacidade? Políticas variam por TLD e podem mudar.

·         A privacidade está incluída ou é opcional? O país/estado continua público?

·         Existe um canal de e-mail intermediado sem revelar seu endereço real?

·         Quem é o registrante formal? Como funciona transferência, desbloqueio e código de autorização?

·         Em que casos o serviço pede identificação, suspende o domínio ou divulga dados?

·         Como você recupera a conta sem telefone pessoal? O contrato exige informações corretas?

Leitura crítica de serviços de privacidade

Os exemplos abaixo não são endossos. Eles mostram por que a página de vendas deve ser lida ao lado dos Termos e da Política de Privacidade.

Serviço

O que oferece publicamente

O que o contrato/política revela

Njalla

Domínio, VPS, DNS e uma camada de privacidade.

O serviço figura como registrante formal por padrão; exige e-mail ou XMPP atualizado. Isso reduz exposição pública, mas transfere dependência jurídica ao intermediário.

1984 Hosting

VPS na Islândia, privacidade de domínio quando o TLD permite e pagamentos em Bitcoin/Monero.

A política informa coleta de IP, nome, faturamento e contato; logs de acesso podem ser retidos e dados podem ser divulgados quando houver obrigação legal.

OrangeWebsite

Hospedagem na Islândia e discurso de minimização de dados.

A política diz coletar o mínimo, mas lista nome, endereço, telefone, e-mail, histórico e forma de pagamento entre os dados possíveis.

Cloudflare

Reverse proxy e Tunnel capazes de ocultar o IP da origem do público.

É um intermediário de infraestrutura, não um serviço de anonimato. A conta e o tráfego passam a depender de mais um ponto de confiança.

SINAL DE ALERTA

Se a página inicial promete “no logs”, mas a política permite registrar IP, faturamento, suporte ou acesso à rede, trate a política como a descrição mais importante. “Privacidade” quase sempre significa minimização e limites de divulgação — não ausência total de registros.

Passo 3 — Trate o pagamento como um identificador

Cartão, PayPal, transferência e lojas de aplicativos criam registros no processador de pagamento, mesmo quando o host não guarda o número do cartão. Criptomoeda também não é sinônimo de anonimato. O próprio Bitcoin.org lembra que transações são públicas, rastreáveis e permanentes, e que endereços podem ser ligados a identidades quando usados para comprar serviços.

·         Use apenas meios de pagamento legais e compatíveis com os termos do fornecedor.

·         Decida se sua ameaça é exposição pública ou correlação pelo fornecedor. Para a primeira, um pagamento comum pode ser aceitável; para a segunda, ele é um elo forte.

·         Não reutilize endereços de recebimento publicados no site para pagar infraestrutura.

·         Guarde comprovantes e datas de renovação de forma criptografada: perder o domínio por falta de pagamento é mais provável do que uma quebra criptográfica.

Passo 4 — Prefira um site estático e uma origem silenciosa

Quanto menos componentes públicos, menor a superfície de ataque e menor a quantidade de dados operacionais. Para um blog, uma pilha enxuta atende a quase tudo sem banco de dados, painel administrativo aberto ou plugins de terceiros.

PILHA DE REFERÊNCIA

Pelican (Python) para gerar HTML estático • Nginx ligado apenas a 127.0.0.1 • VPS de um fornecedor cuja política você leu • Cloudflare Tunnel ou reverse proxy equivalente • DNS separado • backup local criptografado. O visitante recebe um site normal da surface web; a origem não precisa aceitar conexões web da internet.

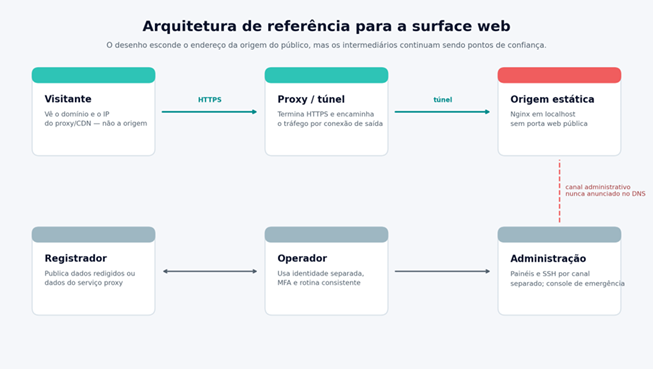
Figura 2 — Arquitetura sugerida: publicação pública por proxy/túnel e administração por um canal separado.

Em registros DNS marcados como “proxied”, a Cloudflare responde com um IP anycast em vez do IP da origem. Com Tunnel, o agente no servidor cria conexões somente de saída; a origem pode bloquear tráfego de entrada. Isso esconde o endereço da origem do público, mas a Cloudflare continua sabendo qual conta e qual origem estão conectadas.

Passo 5 — Configure o servidor em uma ordem segura

Use Debian estável ou outra distribuição com atualizações previsíveis. A sequência importa: primeiro garanta acesso de recuperação pelo console do fornecedor; depois crie e teste uma conta sem privilégios permanentes; só então feche portas.

1. Atualize e crie um usuário administrativo

sudo apt update
sudo apt full-upgrade
sudo apt install nginx unattended-upgrades ufw
sudo adduser publisher
sudo usermod -aG sudo publisher

Copie uma chave SSH nova — não reutilizada em projetos pessoais — para o usuário publisher. Abra uma segunda sessão e confirme que a chave funciona antes de tocar na configuração do SSH.

2. Desative login direto de root e senhas

Crie /etc/ssh/sshd_config.d/99-site.conf com o conteúdo abaixo. Substitua publisher se usar outro nome.

PermitRootLogin no
PasswordAuthentication no
KbdInteractiveAuthentication no
AllowUsers publisher

Valide a sintaxe antes de recarregar:

sudo sshd -t && sudo systemctl reload ssh

3. Sirva o site apenas em localhost

Gere o site localmente e envie apenas a pasta de saída. Um bloco mínimo do Nginx pode ouvir em 127.0.0.1:8080:

server {
    listen 127.0.0.1:8080;
    server_name _;
    root /srv/private-site/output;
    index index.html;

    location / { try_files $uri $uri/ =404; }
    add_header X-Content-Type-Options nosniff always;
    add_header Referrer-Policy no-referrer always;
    add_header Permissions-Policy "camera=(), microphone=(), geolocation=()" always;
    add_header Content-Security-Policy "default-src 'self'; img-src 'self' data:; style-src 'self' 'unsafe-inline'" always;
}

4. Conecte o túnel e feche a entrada

Instale o agente do túnel pelo repositório e pela documentação atual do fornecedor; publique o hostname para http://127.0.0.1:8080. Teste o domínio por uma rede externa. Depois, com o console de emergência confirmado, aplique política de firewall que negue entrada e permita saída. Se também transportar SSH pelo túnel, proteja-o com autenticação forte e uma política separada.

EVITE SE TRANCAR PARA FORA

Não ative “deny incoming” até confirmar: console web do provedor, login por chave em uma segunda sessão, túnel operacional e um caminho de recuperação. Fechar a porta 22 sem alternativa testada transforma uma melhoria de privacidade em indisponibilidade.

Passo 6 — Não revele a origem antes do proxy

·         Configure o proxy/túnel antes de criar qualquer A ou AAAA público apontando para o VPS. Bancos de DNS histórico podem preservar erros por anos.

·         Não crie subdomínios óbvios como origin., direct., cpanel. ou server. apontando diretamente para a máquina.

·         Não rode e-mail no mesmo IP. MX, SPF, DKIM e mensagens enviadas podem criar uma trilha independente até a infraestrutura.

·         Não use o IP da origem em monitores, status pages, repositórios, capturas de tela ou relatórios públicos.

·         Mantenha o serviço web ligado a localhost quando usar túnel. Se usar apenas reverse proxy, limite a origem aos endereços do proxy e autentique a conexão.

·         Não use o mesmo VPS, conta de nuvem, chave SSH ou snapshot de um projeto ligado ao seu nome real.

Passo 7 — Limpe código, imagens e hábitos

Uma foto sem nome no arquivo ainda pode conter GPS, modelo da câmera, software, horário e miniaturas. Um repositório pode publicar o e-mail real em cada commit. Um identificador de analytics reutilizado pode ligar dois sites que nunca se mencionam.

Git

Ative “Keep my email addresses private” no GitHub e copie o endereço noreply fornecido pela plataforma. Configure-o apenas no repositório pseudônimo e audite todo o histórico antes do primeiro push público:

git config user.name "Seu pseudônimo"
git config user.email "ENDERECO_NOREPLY_FORNECIDO_PELO_GITHUB"
git log --all --format='%an <%ae>' | sort -u

A documentação do GitHub alerta que mudar a configuração afeta commits futuros; commits antigos continuam com o e-mail anterior. Se houver histórico comprometido, recrie o repositório antes de publicá-lo em vez de confiar apenas na nova configuração.

Imagens e documentos

Inspecione antes, remova metadados para uma cópia nova e inspecione novamente. O ExifTool avisa que remover “tudo” não é garantia absoluta para todo formato; reexportar ou reencodar pode ser necessário.

exiftool -a -G1 -s imagem-original.jpg
exiftool -all= -o imagem-publica.jpg imagem-original.jpg
exiftool -a -G1 -s imagem-publica.jpg

Conteúdo e front-end

·         Hospede fontes, CSS, JavaScript e imagens no próprio domínio. Recursos externos expõem seus leitores e criam dependências.

·         Evite comentários de terceiros, pixels de marketing e IDs de analytics que você já usa em sites pessoais.

·         Remova source maps, arquivos .env, backups, diretórios de build, nomes de usuário locais e caminhos absolutos.

·         Não publique fotos inéditas do seu ambiente, recibos, telas com fuso horário, notificações ou detalhes de rotina.

·         Assuma que vocabulário, horários e temas podem permitir análise estilométrica. Não existe ferramenta simples que torne um autor irreconhecível.

Passo 8 — Lembre que HTTPS também deixa registros públicos

HTTPS é obrigatório para proteger leitores, mas certificados públicos entram em logs de Certificate Transparency consultáveis por qualquer pessoa. Isso pode revelar domínios e subdomínios presentes no certificado, mesmo quando o servidor de origem permanece oculto.

·         Use nomes de subdomínio neutros; não coloque nomes pessoais, ambientes internos ou fornecedores no hostname.

·         Considere um certificado wildcard obtido por DNS-01 quando muitos subdomínios internos não devem aparecer individualmente. O domínio-base continuará público.

·         Ative DNSSEC quando o registrador e o DNS autoritativo oferecerem suporte e você souber como recuperar uma troca de chaves malfeita.

·         Reveja MX e TXT: registros de verificação, SPF e ferramentas SaaS podem revelar serviços e contas relacionados.

Passo 9 — Faça uma auditoria como um estranho

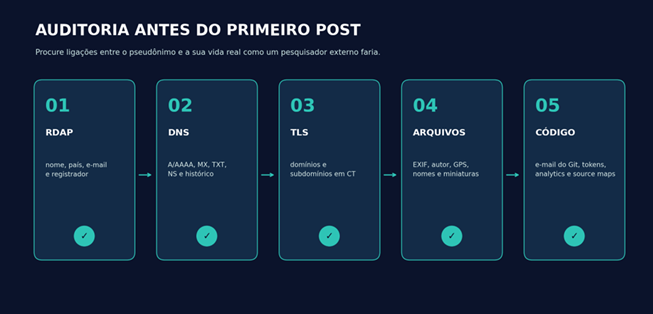
Figura 3 — Auditoria mínima antes de publicar: registro, DNS, certificados, arquivos e código.

Consultas locais

dig +short A exemplo.net
dig +short AAAA exemplo.net
dig +short MX exemplo.net
dig +short TXT exemplo.net
dig +short NS exemplo.net
curl -sSIk https://exemplo.net

Verificações externas

·         Abra o ICANN Lookup/RDAP e confirme exatamente quais campos estão públicos.

·         Pesquise o domínio e cada subdomínio em logs de certificados e em serviços de histórico DNS.

·         Pesquise o pseudônimo, e-mail, frases exatas do texto, favicon e nomes de arquivo em mecanismos de busca.

·         Abra o site em um navegador limpo e em outra rede; examine requisições externas no painel Network das ferramentas do desenvolvedor.

·         Baixe cada imagem e documento do site e execute uma inspeção de metadados na cópia publicada, não apenas no arquivo-fonte.

·         Peça a uma pessoa de confiança para repetir a investigação sem saber sua arquitetura. O que você conhece sobre si mesmo distorce a auditoria.

Passo 10 — Mantenha a separação depois do lançamento

Pseudonimato é uma rotina, não uma compra. Um único login em conta pessoal, commit antigo, renovação por um método identificável ou resposta de suporte assinada com seu nome pode ligar anos de trabalho.

·         Ative atualizações de segurança e verifique mensalmente o sistema, Nginx, gerador estático e agente do túnel.

·         Mantenha dois backups criptografados em locais diferentes e teste a restauração pelo menos a cada trimestre.

·         Registre renovações de domínio e VPS com antecedência; use lembretes fora do e-mail do próprio domínio.

·         Revise sessões ativas, tokens de API, chaves SSH e métodos de recuperação. Revogue o que não é usado.

·         Audite RDAP, DNS, Certificate Transparency e o histórico Git a cada mudança de fornecedor ou arquitetura.

·         Tenha um plano de incidente: tirar o site do ar, revogar tokens, trocar chaves, preservar evidências e comunicar leitores sem improviso.

O que não fazer

Atalho tentador

Por que falha

Cadastrar dados falsos

Pode violar contrato, impedir recuperação e causar suspensão. Use mecanismos legítimos de redação/proxy.

Confiar apenas no WHOIS/RDAP

DNS, certificados, pagamentos, Git, imagens e suporte criam trilhas independentes.

Apontar o domínio à origem “só por alguns minutos”

Coletores de DNS histórico podem guardar esse endereço.

Comprar “bulletproof hosting” sem ler políticas

Marketing não substitui contrato, jurisdição, histórico operacional e controle da conta.

Desativar todos os logs

Você perde capacidade de detectar invasão e depurar falhas. Minimize e retenha pelo tempo necessário; não apague para obstruir investigações.

Misturar persona e vida real

Correlação por usuário, e-mail, chave, navegador, linguagem ou horário costuma ser mais fácil que um ataque técnico.

Checklist de lançamento

☐ Modelo de ameaça escrito e limites aceitos

☐ Pseudônimo, e-mail, senhas, MFA e recuperação separados

☐ TLD e contrato do registrador revisados

☐ RDAP testado após o registro

☐ Pagamento tratado como potencial identificador

☐ VPS/host nunca usado em projeto pessoal

☐ Chave SSH exclusiva e login por senha desativado

☐ Site estático sem painel público

☐ Origem em localhost ou restrita ao proxy

☐ Nenhum A/AAAA público aponta para a origem

☐ Sem e-mail no mesmo IP

☐ Git e histórico sem nome/e-mail pessoal

☐ Imagens e documentos auditados após publicação

☐ Sem analytics ou IDs reutilizados

☐ Certificados e subdomínios verificados em CT

☐ Backup criptografado e restauração testada

☐ Renovações e plano de incidente documentados


Um site da surface web pode parecer e ser, para o público, completamente pseudônimo. O desenho mais sólido combina identidade operacional separada, registro com redação legítima, origem sem porta pública, conteúdo estático e auditorias recorrentes. Ainda assim, cada intermediário conserva uma parte do quebra-cabeça.

A medida de sucesso não é “ninguém jamais saberá”. É: um visitante ou pesquisador não encontra seu nome, endereço, contas pessoais ou IP de origem; uma falha em uma camada não revela automaticamente todas as outras; e você sabe exatamente quais empresas continuam capazes de correlacionar a operação.

Read more

Pablo Murad pablomurad.com

O Plano no Front

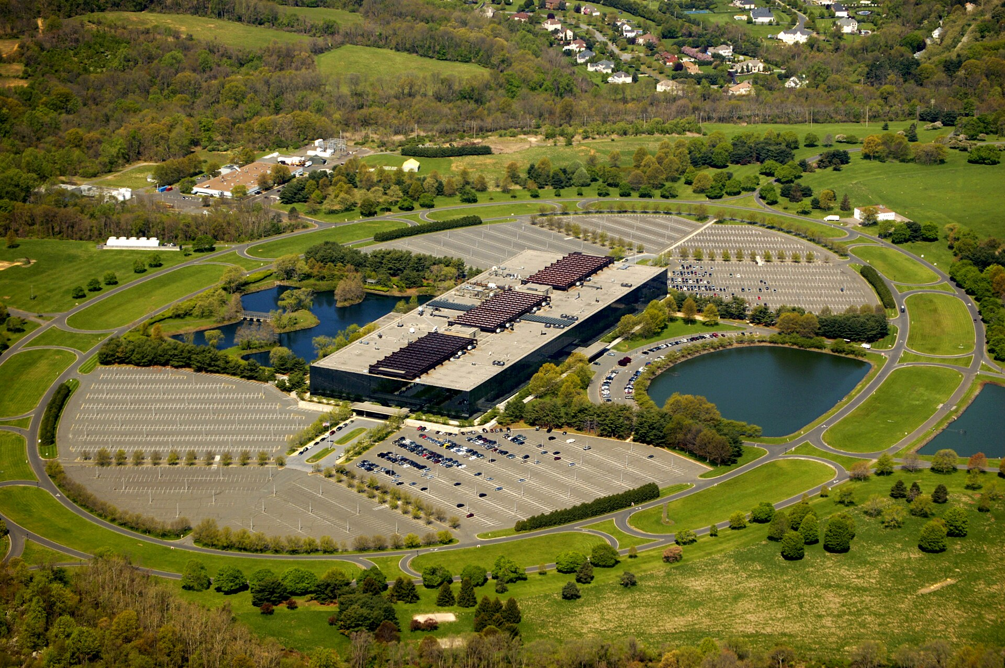
O complexo de Holmdel, projetado por Eero Saarinen, visto do alto. O antigo laboratório hoje se chama Bell Works. Fonte e licença

Quem assistiu à série Severance talvez reconheça o enorme bloco espelhado de Holmdel, em Nova Jersey. Na ficção, ele vira a sede inquietante da Lumon. Na vida real, aquele edifício foi um dos grandes endereços da pesquisa industrial americana. Ali e em outros campi dos Bell Labs, pessoas tentaram fazer uma rede telefônica continental funcionar, reduzir ruído, compreender sinais, construir componentes eletrônicos e inventar ferramentas para computadores que ainda eram raros, caros e difíceis de usar. O resultado foi uma concentração quase absurda de descobertas. O transistor tornou a eletrônica menor e mais confiável. Claude Shannon explicou como medir informação. Penzias e Wilson encontraram um eco do universo primordial. Ken Thompson, Dennis Ritchie e seus colegas criaram o Unix; Ritchie desenvolveu a linguagem C; Bjarne Stroustrup começou o que viria a ser C++. Décadas depois, outra equipe tentou repensar a computação distribuída com o Plan 9. Essa lista é conhecida. O que me interessa, porém, é a cultura que tornou a lista possível.

Este texto conta algumas dessas histórias sem transformar o Bell Labs num templo infalível. O laboratório existiu dentro de uma corporação poderosa, sustentada por um monopólio regulado, atravessada por guerras, disputas de crédito, prioridades comerciais e desigualdades do seu tempo. Ainda assim, há uma lição fértil na maneira como ciência fundamental, engenharia prática e liberdade intelectual puderam dividir o mesmo corredor.

No fim, quero chegar a uma pergunta mais modesta e muito atual: como criar hoje um pequeno lugar na rede em que as pessoas entrem, recebam uma conta, encontrem ferramentas, conversem, publiquem e aprendam umas com as outras? Esse lugar tem um nome antigo, pubnix. Antes de apresentá-lo, vale conhecer a linhagem de ideias da qual ele faz parte.

Antes dos computadores havia uma rede

Bell Labs não nasceu para inventar computadores pessoais, linguagens elegantes ou teorias sobre o universo. Nasceu porque telefonia em grande escala é um problema científico disfarçado de serviço cotidiano. Uma ligação precisava atravessar fios, amplificadores, centrais, cidades e continentes. Cada etapa acrescentava distorção, atraso e ruído. Para entregar a simples experiência de ouvir alguém distante, era necessário dominar materiais, acústica, eletrônica, matemática, transmissão e fabricação. Em 1925, a AT&T e a Western Electric organizaram a Bell Telephone Laboratories como uma empresa separada. Ela começou com cerca de quatro mil cientistas e engenheiros, segundo a história institucional mantida hoje pela Nokia Bell Labs. Era o braço de pesquisa e desenvolvimento do Bell System, a vasta estrutura que controlava boa parte da telefonia americana. A missão tinha dois horizontes: consertar os problemas de amanhã e descobrir o que poderia ser útil daqui a vinte anos.

Essa combinação é importante. Pesquisa básica sem contato com o mundo pode perder direção; engenharia pressionada apenas pelo próximo trimestre tende a repetir o que já existe. Bell Labs aproximava os dois extremos. Um físico podia estudar propriedades da matéria porque, em algum ponto, aquilo talvez produzisse um componente melhor. Um engenheiro podia perseguir um defeito estranho numa linha e acabar diante de uma pergunta fundamental sobre sinais.

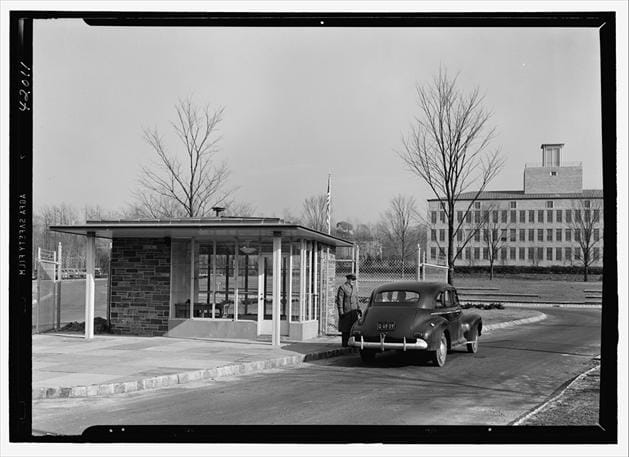
Entrada do laboratório de Murray Hill em 1942. Foto de Samuel H. Gottscho, acervo da Library of Congress, domínio público. Fonte e licença

Os prédios onde as ideias se encontravam

A primeira grande sede ficava na West Street, em Manhattan, num edifício industrial lotado de laboratórios. Depois, Murray Hill, em Nova Jersey, tornou-se o endereço mais associado às descobertas da física e da computação. Holmdel, projetado por Eero Saarinen e construído entre o fim dos anos 1950 e os anos 1960, parecia uma nave horizontal de vidro escuro pousada no campo. Longos corredores e áreas comuns aumentavam a chance de encontros entre especialidades. A arquitetura, sozinha, não produz ideias. Mas ela pode favorecer uma certa espécie de acidente. Mervin Kelly, pesquisador e depois presidente dos laboratórios, defendia proximidade entre pessoas que não falavam a mesma linguagem técnica. Um problema de metalurgia podia aparecer na mesa de um químico; um matemático podia explicar a um engenheiro por que um sistema falhava. As portas não eliminavam hierarquias, mas os corredores criavam atalhos.

Também havia tempo. Projetos podiam sobreviver sem uma justificativa comercial imediata porque a rede telefônica, protegida e regulada, gerava receita previsível. Esse modelo dificilmente pode ser copiado hoje, e havia um preço político nessa estabilidade. Ainda assim, ele permitiu que perguntas fundamentais fossem tratadas como parte da infraestrutura, não como luxo.

INFORMAÇÃO

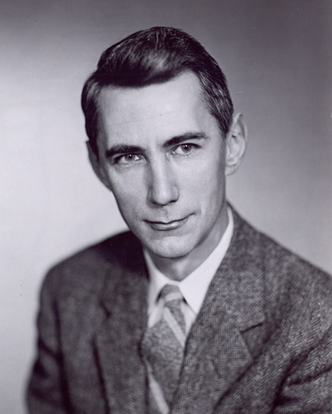
Claude Shannon dá uma medida ao invisível

Em 1948, Claude Shannon publicou A Mathematical Theory of Communication no Bell System Technical Journal. O título parecia estreito; a consequência foi imensa. Shannon separou a informação do significado e mostrou como tratá-la matematicamente. Para uma rede, pouco importa se a mensagem é uma declaração de amor ou uma cotação de bolsa. O problema técnico é representar símbolos, transportá-los por um canal sujeito a ruído e reconstruí-los com uma taxa aceitável de erro.

A unidade que se popularizou foi o bit, uma escolha entre duas possibilidades. A teoria estabeleceu limites para compressão e comunicação confiável e forneceu uma gramática para tudo o que viria depois: modems, discos, redes, vídeo digital, celulares, criptografia aplicada e a própria internet. Shannon não construiu todas essas coisas. Fez algo talvez mais poderoso: mostrou onde estavam os limites e deu aos engenheiros uma régua. Sua figura combina perfeitamente com a mitologia dos Bell Labs. Shannon construía máquinas de xadrez, um rato mecânico capaz de aprender um labirinto e engenhocas para malabarismo. Circulava pelos corredores num monociclo. Essas histórias não são apenas excentricidades simpáticas. Elas revelam uma relação física e brincalhona com as ideias. Para ele, pensar também era fabricar objetos que tornassem um conceito visível.

Claude Shannon, autor da teoria matemática da comunicação. Acervo do Tekniska museet, licença CC BY 2.0. Fonte e licença

Há uma lição de design nessa história. Boas abstrações não escondem o mundo; elas separam o essencial do acidental. Shannon não precisava compreender o conteúdo de cada mensagem para dizer algo profundo sobre todas elas. Décadas de software seriam construídas com o mesmo gesto: encontrar uma interface pequena o bastante para ser geral e concreta o bastante para funcionar.

MATÉRIA

O transistor e a briga por reconhecimento

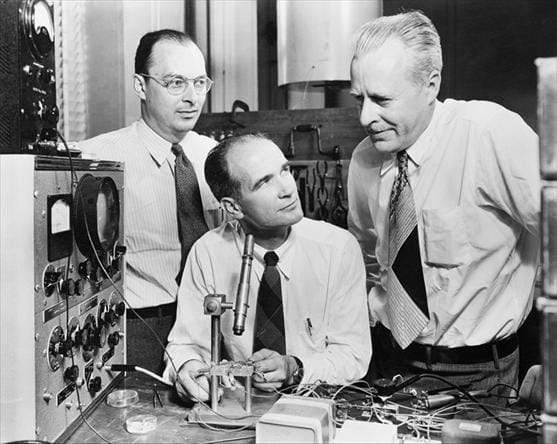
No fim de 1947, John Bardeen e Walter Brattain demonstraram o transistor de contato pontual. William Shockley, que liderava o grupo, desenvolveu pouco depois a teoria e o projeto do transistor de junção. O novo componente podia amplificar e comutar sinais sem depender das válvulas grandes, quentes e frágeis usadas até então. Em 1956, os três dividiram o Nobel de Física pelas pesquisas em semicondutores e pela descoberta do efeito transistor.

John Bardeen, William Shockley e Walter Brattain em uma fotografia promocional de 1948 dos Bell Telephone Laboratories. Domínio público. Fonte e licença

A imagem oficial dos três homens reunidos ao redor do equipamento sugere harmonia. A história foi mais áspera. Houve sigilo, competição interna e desacordo sobre crédito e patentes. Shockley sentiu-se deixado de lado na primeira demonstração; Bardeen e Brattain se ressentiram de sua tentativa de ocupar o centro da narrativa. O laboratório produzia colaboração, mas não suspendia ego, poder ou ambição. Essa tensão ajuda a evitar uma versão infantil da inovação. Descobertas raramente surgem de um herói solitário e raramente pertencem sem conflito a uma equipe perfeitamente alinhada. O transistor dependeu de teoria quântica, cristais mais puros, técnicas de fabricação, instrumentos e muitas tentativas anteriores. Bell Labs reuniu essa cadeia num mesmo ambiente. A fotografia é verdadeira, mas incompleta.

O efeito do transistor escapou rapidamente da telefonia. Sem ele não haveria circuitos integrados como os conhecemos, nem microprocessadores, computadores pessoais ou servidores compactos. O que começou como uma maneira melhor de amplificar sinais tornou-se o tijolo elementar da civilização digital.

COSMOS

O ruído que vinha do começo do universo

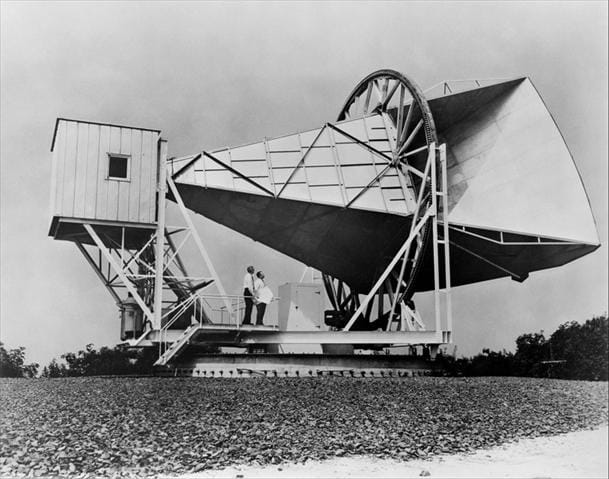
Em 1964, Arno Penzias e Robert Wilson tentavam usar uma grande antena de chifre em Holmdel para radioastronomia e comunicações por satélite. Um ruído de micro-ondas aparecia em todas as direções. Eles verificaram o receptor, consideraram interferências urbanas e limparam da antena o material deixado por pombos. O chiado continuou. A poucos quilômetros dali, em Princeton, uma equipe liderada por Robert Dicke preparava um experimento para procurar a radiação prevista por modelos de um universo quente e denso. O encontro entre os dois grupos revelou o que a antena estava ouvindo: a radiação cósmica de fundo em micro-ondas, luz resfriada pela expansão do universo durante bilhões de anos. Era uma das evidências decisivas para o modelo do Big Bang.

A antena de chifre de Holmdel usada por Arno Penzias e Robert Wilson. Imagem da NASA, domínio público; restauração de Bammesk. Fonte e licença

Penzias e Wilson receberam metade do Nobel de Física de 1978 pela descoberta. A história dos pombos tornou-se popular porque é engraçada, mas o ponto mais interessante é metodológico. Eles não descartaram o ruído como um incômodo. Tentaram explicar cada fonte possível, preservaram o resultado estranho e conversaram com pessoas que tinham outra hipótese. Um defeito aparente no instrumento virou uma janela para a origem do cosmos.

Bell Labs podia chegar a esse tipo de descoberta porque instrumentos de comunicação e instrumentos científicos às vezes eram a mesma coisa. Para falar com um satélite, era preciso aprender a ouvir sinais quase enterrados no ruído. Ao aperfeiçoar essa escuta, o laboratório acabou ouvindo o universo.

SOFTWARE

Unix nasce nas sobras de outro projeto

No fim dos anos 1960, Bell Labs participou do Multics, um projeto ambicioso de sistema de tempo compartilhado com MIT e General Electric. A promessa era criar uma espécie de serviço público de computação: muitos usuários, proteção de memória, arquivos organizados, programas sempre disponíveis. O projeto avançou, mas tornou-se caro e complexo. Bell Labs se retirou em 1969. Ken Thompson sentiu falta daquele ambiente interativo. Num computador PDP-7 pouco usado, começou a montar um sistema menor. Um jogo chamado Space Travel ajudou a levá-lo à máquina e serviu como laboratório para ferramentas, mas dizer que o Unix foi criado apenas para jogar é simplificar demais. Thompson já carregava ideias sobre processos, arquivos e programação interativa amadurecidas no Multics. Dennis Ritchie, Rudd Canaday e outros colegas se juntaram ao trabalho. Brian Kernighan sugeriu o nome Unix, uma brincadeira com Multics.

O sistema cresceu sem um grande plano de produto. Uma das primeiras justificativas internas foi preparar textos para um pedido de patente. Isso é quase cômico: uma ferramenta que mudaria a computação ganhou espaço porque era boa para compor documentos. O Unix sobrevivia porque era útil aos próprios autores e aos colegas próximos.

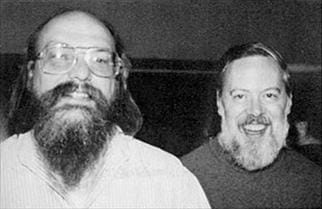
Ken Thompson e Dennis Ritchie em 1973. Fotógrafo não identificado; imagem reproduzida no Jargon File e indicada como domínio público no Wikimedia Commons. Fonte e licença

A filosofia das ferramentas pequenas

O Unix tratou muitos recursos como arquivos e fez do texto um material de troca entre programas. Em vez de uma aplicação enorme para cada tarefa, favoreceu ferramentas pequenas que podiam ser combinadas. Um programa seleciona linhas, outro ordena, outro conta, outro formata. Os pipes, defendidos por Doug McIlroy e implementados por Thompson, permitiram ligar a saída de um processo à entrada do seguinte. A força dessa ideia não está em cada comando isolado. Está no espaço entre eles. Quando as interfaces são simples, o usuário deixa de ser apenas consumidor e se torna autor de combinações. O shell é uma oficina. Um pipeline de uma linha pode ser descartável, compartilhado com um amigo ou amadurecer até virar um programa.

Também era um sistema multiusuário desde a origem. Contas, permissões, processos e diretórios pessoais não foram acrescentados depois como recursos sociais; faziam parte da maneira como computadores caros eram vividos. Várias pessoas ocupavam a mesma máquina sem estar no mesmo processo. Essa convivência técnica é o antepassado direto do tipo de experiência que um pubnix tenta recuperar em escala comunitária.

C torna o sistema portátil

O primeiro Unix foi escrito em assembly. Isso o prendia à máquina. Ritchie desenvolveu C a partir das linguagens BCPL e B, equilibrando acesso direto à memória com estruturas mais expressivas. Em 1973, o núcleo do Unix foi reescrito majoritariamente em C. O sistema deixou de ser uma criatura inseparável do PDP-11 e pôde atravessar arquiteturas com um esforço razoável.

C não eliminou o risco. Ponteiros, limites de memória e comportamento indefinido deram aos programadores tanto poder quanto responsabilidade. Ainda assim, a linguagem encontrou um ponto raro: pequena o bastante para compreender, próxima do hardware o bastante para escrever um sistema operacional e geral o bastante para produzir uma imensa variedade de software. O sucesso de C e Unix tornou cada um propaganda do outro. Universidades receberam versões do Unix com código-fonte e formaram gerações de programadores que liam o sistema como quem estuda um organismo. Variantes comerciais e acadêmicas se multiplicaram. BSD, os sistemas proprietários, Linux e a família moderna de sistemas inspirados em Unix herdaram diferentes partes dessa cultura. A internet foi construída, em grande medida, em máquinas que falavam esse idioma.

OUTROS FUTUROS

Uma fábrica de invenções que não cabem numa lista

O transistor, Shannon e Unix já bastariam para dar fama a qualquer instituição. Bell Labs ainda participou de uma quantidade desconcertante de outros futuros. Em 1954, Daryl Chapin, Calvin Fuller e Gerald Pearson apresentaram uma célula solar prática de silício. Ela tinha eficiência modesta pelos padrões atuais, mas mostrou que luz podia gerar eletricidade de maneira útil e durável.

Arthur Schawlow, então no laboratório, e Charles Townes formularam princípios do maser óptico que ajudaram a abrir o caminho para o laser. É mais correto falar em uma cadeia internacional de contribuições do que atribuir a invenção a um único lugar; Theodore Maiman construiu o primeiro laser operacional em outro laboratório. Bell Labs, porém, teve papel central na teoria e em muitos desenvolvimentos posteriores.

Em 1962, Telstar 1 transmitiu sinais de televisão, voz e dados através do Atlântico e transformou comunicação por satélite em experiência pública. Em 1969, Willard Boyle e George Smith conceberam o dispositivo de carga acoplada, o CCD, que se tornaria fundamental para câmeras digitais e instrumentos científicos. Ideias de células e reuso de frequência ajudaram a formar a telefonia móvel. Max Mathews abriu caminhos para música produzida por computador. Os laboratórios também atravessaram a arte. Em 1966, o engenheiro Billy Klüver e o artista Robert Rauschenberg organizaram 9 Evenings: Theatre and Engineering, com artistas, dançarinos e dezenas de engenheiros. Projeções, sensores, som sem fio e plataformas controladas por rádio entraram em cena antes de esse vocabulário virar rotina em instalações digitais. A tecnologia aparecia não só como produto, mas como novo material expressivo.

Erna Schneider Hoover oferece outra história essencial. Ao perceber que centrais telefônicas computadorizadas podiam colapsar durante picos de chamadas, ela concebeu um método para o sistema priorizar as tarefas de entrada e saída que mantinham o serviço vivo. A solução foi patenteada e tornou-se importante para comutação eletrônica. Sua trajetória também lembra que a narrativa mais conhecida dos Bell Labs, dominada por fotografias de homens brancos, não esgota quem trabalhou ali nem as barreiras que outras pessoas precisaram atravessar.

Uma cronologia muito resumida

Ano

O que aconteceu

1925

Bell Telephone Laboratories é organizada como empresa de pesquisa e engenharia.

1947

Bardeen e Brattain demonstram o transistor de contato pontual; Shockley avança o transistor de junção.

1948

Claude Shannon publica a teoria matemática da comunicação.

1954

Chapin, Fuller e Pearson apresentam uma célula solar prática de silício.

1962

Telstar 1 leva televisão, voz e dados através do Atlântico.

1964

Penzias e Wilson detectam a radiação cósmica de fundo em micro-ondas.

1969

Ken Thompson inicia o Unix no PDP-7, com Dennis Ritchie e outros colegas.

1972–73

A linguagem C toma forma e o Unix é reescrito majoritariamente nela.

1979

Bjarne Stroustrup começa C with Classes, embrião do C++.

1984

A dissolução do Bell System separa parte da pesquisa e muda o ambiente institucional.

Fim dos 1980

Plan 9 começa a ser desenvolvido como uma nova exploração das ideias distribuídas do Unix.

1996–2016

Bell Labs passa por Lucent, Alcatel-Lucent e, por fim, Nokia.

2021

O código histórico do Plan 9 é relicenciado sob a licença MIT.

Até 2028

A Nokia planeja transferir a principal operação de Murray Hill para New Brunswick, Nova Jersey.

LINGUAGENS

C++ e os descendentes do Unix

Em abril de 1979, Bjarne Stroustrup começou nos Bell Labs uma linguagem que chamava de C with Classes. Ele queria preservar a eficiência e o acesso ao sistema oferecidos por C, mas acrescentar recursos de abstração que conhecera em Simula. O nome C++ veio depois. A linguagem cresceu, padronizou-se e passou a sustentar sistemas operacionais, jogos, navegadores, aplicações financeiras e incontáveis programas em que desempenho importa.

C++ representa uma resposta diferente da resposta original do Unix. Em vez de manter toda ideia exposta em poucas construções, oferece muitas formas de criar abstrações sem abandonar o controle de baixo nível. Essa riqueza cobra um preço em complexidade, mas mostrou como o ambiente dos Bell Labs continuava a produzir não apenas produtos, e sim instrumentos que outros usariam para construir produtos. Na mesma linhagem aparecem ferramentas menos famosas fora da comunidade Unix: awk, criado por Alfred Aho, Peter Weinberger e Brian Kernighan; a família de shells; troff e seus parentes; sistemas de controle e linguagens que circularam entre pesquisa e produção. A cultura valorizava programas que explicavam a si mesmos por meio de uma interface pequena, documentação direta e código que pudesse ser lido por colegas.

DEPOIS DO UNIX

Plan 9 coloca a rede dentro do sistema

No fim dos anos 1980, pesquisadores dos Bell Labs começaram a perguntar o que fariam se pudessem redesenhar um sistema operacional distribuído depois de aprender com duas décadas de Unix. O resultado foi Plan 9 from Bell Labs, nome tirado do filme cult de Ed Wood. A brincadeira no nome escondia uma proposta rigorosa: tornar a rede uma parte normal do sistema, sem a coleção de remendos que havia crescido ao redor do Unix. A frase tudo é arquivo, frequentemente usada para explicar Unix, ganha em Plan 9 uma aplicação mais consistente. Serviços apresentam interfaces semelhantes a sistemas de arquivos. O protocolo 9P transporta essas operações pela rede. Processos podem ter namespaces próprios, montando recursos locais e remotos em lugares escolhidos por cada usuário. Em vez de existir uma árvore global e rígida para toda a máquina, cada ambiente pode construir sua visão.

Uma sessão típica podia envolver um terminal para a interface, um CPU server para executar tarefas pesadas e um file server para guardar dados. A distinção não precisava dominar a experiência. Um recurso disponível em outro computador podia aparecer no namespace como se estivesse perto. O desenho antecipava um mundo de dispositivos e serviços conectados, mas com uma uniformidade que a web e as nuvens atuais raramente oferecem.

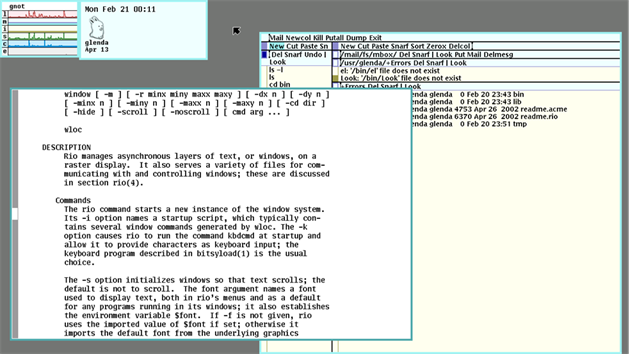
O gerenciador de janelas rio no Plan 9 Fourth Edition. Captura de VulcanSphere; o software histórico do Plan 9 está sob licença MIT. Fonte e licença

Plan 9 nunca substituiu o Unix. Hardware, aplicações, hábitos e compatibilidade formavam uma montanha que elegância arquitetural não podia remover. Mas suas ideias viajaram. 9P apareceu em virtualização, contêineres e projetos de pesquisa; namespaces influenciaram a maneira como pensamos isolamento; UTF-8 foi criado por Rob Pike e Ken Thompson durante esse período e hoje é a codificação dominante da web. Em 2021, o código histórico do sistema foi colocado sob licença MIT pela Plan 9 Foundation, facilitando preservação e experimentação.

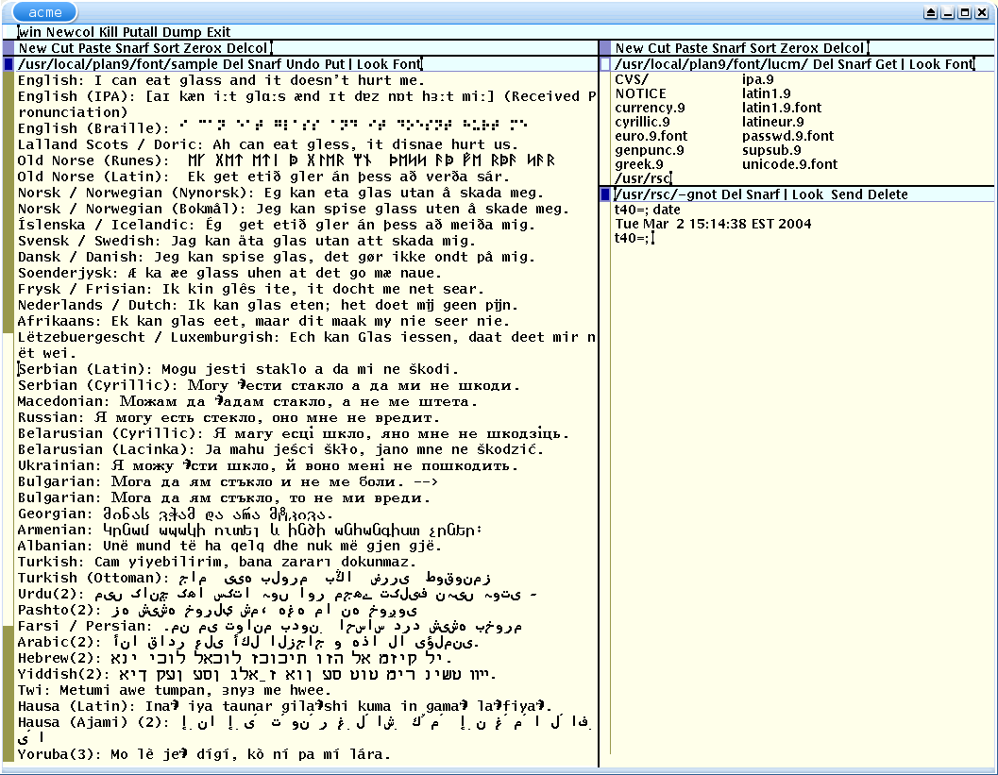
Há beleza na interface quase áspera do Plan 9. Ela não tenta esconder que o computador é um conjunto de ferramentas. O rio usa o mouse de uma maneira própria, Acme mistura editor, shell e hipertexto, e o sistema convida o usuário a entender suas peças. Pode parecer estranho a quem chega de um desktop moderno, mas a estranheza é produtiva: ela mostra que convenções atuais não são leis naturais.

O preço e os limites da fábrica de ideias

É tentador resumir Bell Labs como prova de que basta contratar gênios e deixá-los brincar. A explicação real é mais material. O Bell System controlava uma enorme rede regulada e tinha obrigação de fazê-la funcionar por décadas. Pesquisa de longo prazo era seguro contra problemas futuros, fonte de patentes e instrumento de prestígio. A escala da empresa financiava equipamentos, bibliotecas, oficinas e carreiras estáveis.

O mesmo arranjo concentrava poder econômico. O governo americano processou a AT&T por práticas anticompetitivas e a reorganização que entrou em vigor em 1984 desmembrou o sistema. Parte da pesquisa ligada às operadoras regionais foi para a Bellcore. Em 1996, a AT&T separou a Lucent, que levou Bell Labs consigo. Lucent uniu-se à Alcatel em 2006; a Nokia adquiriu a Alcatel-Lucent em 2016.

O nome sobrevive, a pesquisa continua e a própria Nokia contabiliza dez prêmios Nobel e cinco prêmios Turing ligados ao laboratório. Mas o mundo institucional mudou. Murray Hill, endereço histórico desde os anos 1940, deve dar lugar até 2028 a uma nova instalação em New Brunswick. Holmdel já havia sido transformado no Bell Works, um complexo de escritórios, comércio e eventos. Prédios podem ser preservados; o modelo econômico que os animava é mais difícil.

Também não convém confundir liberdade interna com abertura pública automática. Unix circulou em universidades, mas licenças e disputas comerciais limitaram seu uso em vários períodos. A cultura aberta que associamos aos descendentes do Unix foi construída por universidades, comunidades, projetos de software livre e redes independentes, muitas vezes negociando ou reagindo aos interesses corporativos.

A melhor herança dos Bell Labs não é uma receita empresarial pronta. É um conjunto de perguntas. Estamos dando tempo para problemas profundos? Pessoas de áreas diferentes conseguem se encontrar? Ferramentas são feitas apenas para clientes ou também para ampliar a autonomia de quem as usa? O conhecimento pode escapar do prédio e ganhar vida em outros lugares?

Read more

Pablo Murad pablomurad.com

Plan 9

O fluxo em uma instalação do Plan 9. A interface parece austera, mas já revela a ideia de compor ferramentas simples dentro do mesmo ambiente.

Estive estudando um sistema operacional pouco conhecido chamado Plan 9. E, antes que alguém pergunte que Linux é esse, convém esclarecer: ele não é Linux. Também não é um BSD disfarçado nem uma tentativa de substituir diretamente FreeBSD ou OpenBSD. O Plan 9 nasceu na Bell Labs como um sucessor conceitual do Unix, feito pelas pessoas que conheciam muito bem as qualidades e os limites do sistema anterior.

O ponto que mais me chamou a atenção não foi sua aparência, nem o fato de ser um sistema raro. Foi a tentativa de levar até o fim algumas ideias que o Unix havia apenas começado. No Plan 9, rede, arquivos, dispositivos, processos e interfaces foram pensados como partes do mesmo ambiente distribuído. Isso muda a maneira de enxergar o computador. 

Um sucessor conceitual do Unix

O desenvolvimento do Plan 9 começou no fim da década de 1980, no Computing Sciences Research Center da Bell Labs, o mesmo ambiente de pesquisa de onde saíram o Unix e a linguagem C. Nomes como Rob Pike, Ken Thompson, Dave Presotto e Phil Winterbottom aparecem ligados ao projeto. A proposta não era remendar o Unix indefinidamente, mas imaginar como ele poderia ter sido se redes, estações gráficas e servidores já fossem parte central do projeto original.

O Unix foi criado em um mundo no qual vários terminais acessavam uma máquina central. Depois, as redes locais se tornaram comuns, as estações ganharam interfaces gráficas e diferentes computadores passaram a dividir tarefas. Em muitos sistemas, cada novidade trouxe sua própria API, seu próprio protocolo e sua própria forma de administração. O Plan 9 tentou reduzir essa coleção de exceções.

É importante não romantizar essa história. O Plan 9 não tomou o lugar do Unix, não construiu um ecossistema comparável ao Linux e hoje continua sendo um sistema de nicho. Ainda assim, várias de suas ideias continuam interessantes porque obrigam a pensar em distribuição, identidade e composição de uma maneira muito limpa.

Quase tudo pode aparecer como arquivo

A frase mais repetida quando se fala em Plan 9 é tudo é arquivo. Ela ajuda, mas também simplifica demais. A ideia mais precisa é que quase qualquer recurso pode ser apresentado por meio de uma árvore de arquivos, esteja ele na própria máquina ou do outro lado da rede. Com isso, ler, escrever, listar e montar deixam de ser operações restritas aos arquivos tradicionais e passam a servir como uma linguagem comum para conversar com o sistema.

Em vez de ensinar cada programa a lidar com dezenas de interfaces diferentes, o Plan 9 tenta apresentar cada serviço de uma forma que as ferramentas comuns já entendem. Uma pilha de rede aparece em /net. Informações sobre processos aparecem como arquivos. Recursos fornecidos por outra máquina podem ser montados dentro do namespace local. Para o programa, tudo isso se parece com uma árvore coerente.

O protocolo 9P

O protocolo que sustenta essa organização é o 9P. Em uma primeira aproximação, ele lembra um NFS exótico: um protocolo usado para acessar arquivos pela rede. A comparação é útil para começar, mas fica curta rapidamente. O 9P não serve apenas para abrir uma pasta remota. Ele é o mecanismo usado para apresentar serviços inteiros dentro do namespace do usuário.

·    Menos interfaces fundamentais. Há menos modelos diferentes para aprender e implementar.

·    Serviços combináveis. Recursos podem ser montados e reorganizados sem obrigar cada aplicação a carregar bibliotecas específicas.

·    Inspeção com ferramentas comuns. Comandos de arquivo ajudam a observar e experimentar serviços que, em outros sistemas, dependeriam de clientes próprios.

Observação. Uma abstração uniforme não elimina latência, falhas de rede, concorrência ou diferenças de desempenho. O recurso remoto pode parecer parte da árvore local, mas continua sujeito à realidade de uma rede.

Namespaces que mudam por processo

No Unix tradicional, normalmente pensamos em uma árvore de arquivos compartilhada por todo o sistema. O Plan 9 trata o namespace como algo que pode ser montado de forma diferente para cada processo ou grupo de processos. O mesmo caminho pode apontar para origens distintas dependendo do ambiente em que o programa foi iniciado.

Isso permite entregar a um programa apenas a rede, os dispositivos e os diretórios de que ele precisa. Também permite unir diretórios vindos de lugares diferentes para que apareçam juntos. Não é somente uma curiosidade acadêmica: é uma forma bastante concreta de controlar contexto e compor recursos sem obrigar cada aplicação a entender a topologia inteira.

Uma arquitetura realmente distribuída

Uma instalação clássica do Plan 9 pode ser dividida em funções. O terminal executa a interface e os programas interativos; o CPU server oferece processamento; o file server mantém os dados; e o auth server participa da autenticação. Essas funções podem estar na mesma máquina, mas foram pensadas para trabalhar separadas pela rede.

Componente

Função

O que entrega ao usuário

Terminal

Interface e aplicativos

Teclado, mouse, tela e interação cotidiana

CPU server

Processamento

Execução remota integrada ao ambiente

File server

Dados e arquivos

Armazenamento apresentado por 9P

Auth server

Identidade

Autenticação e autorização entre serviços

Na prática, um usuário poderia se sentar diante de um terminal modesto, executar o trabalho pesado em um CPU server e acessar dados mantidos por outro servidor. O resultado não deveria parecer uma coleção evidente de sessões remotas. Os componentes seriam reunidos no namespace do usuário e apresentados como um único ambiente de trabalho.

As ferramentas que dão personalidade ao Plan 9

O Plan 9 não chama atenção pela quantidade de programas. Ele chama atenção pela forma como poucas ferramentas se combinam. Algumas parecem estranhas no primeiro contato, sobretudo porque nasceram em uma cultura muito diferente da interface gráfica atual. Depois de algum tempo, fica claro que há uma lógica comum entre elas.

Ferramenta

Função

O que a torna diferente

rc

Shell

Sintaxe menor e mais regular que a dos shells tradicionais derivados de Bourne

rio

Sistema de janelas

Interface simples baseada no serviço gráfico draw e no uso intenso do mouse

sam

Editor

Editor estrutural com uma linguagem de comandos poderosa e interface gráfica separável

acme

Ambiente de trabalho

Mistura editor, shell e hipertexto operacional; o texto pode virar ação

plumber

Roteamento de mensagens

Reconhece conteúdos e encaminha ações entre aplicações

mk

Construção de software

Ferramenta aparentada ao make, adaptada às convenções do Plan 9

upas

Correio eletrônico

Conjunto de ferramentas de e-mail integrado ao ambiente


O Acme parece um editor de texto, mas funciona também como shell e ambiente de integração. Palavras nas barras podem executar comandos ou abrir recursos.

O Acme é provavelmente a melhor porta de entrada para quem deseja sentir a filosofia do sistema sem instalar uma máquina inteira. Ele transforma texto em interface. Um nome de arquivo pode ser aberto, uma palavra pode executar um comando e a saída desse comando pode aparecer em outra janela. Em vez de uma coleção de botões desenhados para cada tarefa, o ambiente usa texto, seleção e composição.

Drawterm e acesso remoto

O Drawterm é um cliente para Windows, Linux e outros sistemas. Ele se conecta aos serviços de CPU e autenticação de uma instalação Plan 9, fornece teclado, mouse e exibição e ainda pode exportar um diretório local para o namespace remoto. É uma forma prática de usar uma instalação distante sem transformar a máquina principal em um terminal Plan 9 dedicado.

Também existe uma diferença importante quando se fala em SSH. O 9front atual possui um cliente SSH2, além de ferramentas como sshfs e sshnet. Isso permite sair do 9front para acessar um servidor Debian ou montar arquivos remotos. Para entrar no 9front, porém, o caminho natural é usar Drawterm e rcpu, não tratar a máquina como mais um servidor OpenSSH comum.

# No 9front, abrir uma sessão SSH em um servidor remoto

ssh usuario@servidor.example

 # Montar uma pasta SFTP remota em modo somente leitura

sshfs -R -m /n/remoto usuario@servidor.example

Segurança e identidade

A Quarta Edição do Plan 9 consolidou uma arquitetura de segurança centrada em autenticação distribuída e na separação entre protocolos e segredos. O factotum atua como agente de autenticação: mantém chaves e executa protocolos em nome das aplicações sem entregar diretamente os segredos a cada programa. O secstore pode armazenar material privado de forma protegida.

A ideia lembra, em espírito, o uso moderno de um agente SSH. A aplicação pede que determinada autenticação seja realizada, enquanto um componente especializado controla o acesso à chave. Isso não significa que os dois sistemas sejam equivalentes, mas a analogia ajuda a entender por que o Plan 9 trata identidade como parte da arquitetura e não como um detalhe acrescentado depois.

Primeiro projeto Acme no Linux

O começo mais simples é instalar o plan9port em uma máquina Linux com interface gráfica e usar o Acme durante uma semana. Eu escreveria rascunhos do meu digital garden, abriria diretórios de projetos e experimentaria a ideia de usar texto como interface. O objetivo não seria substituir imediatamente meu editor atual, mas entender o que muda quando comandos, arquivos e anotações vivem no mesmo espaço.

Plan9port convivendo com programas Linux. É a maneira mais simples de experimentar Acme, rc e outras ferramentas sem abandonar o sistema atual

Segundo projeto Uma estação Plan 9 em uma VM

Depois eu criaria uma pequena VM 9front em um hipervisor doméstico, com poucos recursos e acesso restrito à rede privada. Dois processadores virtuais, 2 GB de memória e 16 GB de disco são suficientes para estudar com folga. O acesso seria feito por Drawterm através da rede local ou de uma rota privada controlada. Nada de abrir a máquina diretamente para a internet no primeiro dia.

Terceiro projeto Um painel do homelab em 9P

Este é o projeto que melhor combina a filosofia do Plan 9 com um homelab doméstico. Um pequeno servidor 9P no Debian poderia apresentar o estado das máquinas como uma árvore: /srv/homelab/servidor/status, /virtualizacao/vms e /radio/ouvintes. Ler um arquivo mostraria a informação atual. Não haveria painel web, framework de frontend nem uma API cheia de endpoints para esse primeiro experimento.

/srv/homelab/

├── servidor/status

├── servidor/temperatura

├── virtualizacao/vms

├── radio/agora

└── radio/ouvintes

Eu começaria em modo somente leitura. Nada de arquivos chamados restart ou delete controlando serviços de produção. Primeiro, o sistema precisa provar que é útil para observar. Só depois faria sentido discutir comandos de administração.

Quarto projeto Um catálogo fotográfico pessoal

Outro experimento interessante seria expor metadados das fotografias como arquivos. Cada imagem poderia ter caminhos como camera, receita, data e nota. Uma busca deixaria de depender de um banco de dados fechado e poderia ser feita com as próprias ferramentas do ambiente. O objetivo não seria substituir o catálogo principal, mas construir uma visão experimental e navegável do acervo.

Quinto projeto Um console somente leitura para uma rádio web

Uma rádio web também renderia um bom laboratório. Um serviço poderia publicar a música atual, o número de ouvintes, a fila e o estado dos componentes de transmissão como arquivos. Acme, rc ou qualquer cliente 9P conseguiria consultar essas informações. Mais uma vez, eu manteria o primeiro protótipo somente leitura. O Plan 9 seria uma lente sobre a rádio, não o sistema responsável por mantê-la no ar.

Vale a pena experimentar

Sim, desde que a expectativa esteja correta. O Plan 9 não é uma substituição prática para Debian, OpenBSD ou Windows no meu ambiente. Também não é a melhor escolha para hospedar um serviço público que precisa de atualizações previsíveis, integrações modernas e uma comunidade grande. Usá-lo dessa maneira seria criar dificuldade sem receber uma vantagem proporcional.

Como laboratório, porém, ele é excelente. Poucos sistemas deixam tão visível a relação entre nomes, arquivos, rede, identidade e composição. Instalar o 9front, entrar por Drawterm, trabalhar no Acme e publicar um serviço 9P pequeno é uma forma de estudar sistemas distribuídos colocando a mão em algo concreto.

É isso que me interessa no Plan 9. Não a fantasia de abandonar tudo o que funciona, mas a oportunidade de olhar para meus sistemas atuais com outra cabeça. Depois de algum tempo usando Plan 9, até uma pasta, uma conexão de rede ou uma ferramenta de texto começa a parecer menos óbvia. Para um sistema operacional que nunca conquistou o mercado, já é um resultado bastante respeitável.

Read more

Pablo Murad pablomurad.com

Construindo Soledade

Há um tempo eu vi algo extremamente interessante, um projeto chamado Nightfall City e achei fantástico de uma pessoa que usa o pseudônimo de m15o, e achei fascinante.

Comecei a seguir de perto os projetos do m15o e quanto mais eu aprendia, mais queria entender sua criatividade e capacidade de modificar recursos e criar coisas novas.

Uma coisa me chamou mais atenção, dentre todas as coisas que vi: o protocolo que foi utilizado para Nightfall City.

Então me ocorreu que eu poderia talvez criar meu próprio protocolo e iniciar um projeto similar baseado inteiramente nele.

Então iniciei a construção do SOLED/2.

O que é

Soledade se apresenta como “um blog textual, quieto e feito à mão”. Por baixo dessa frase existe uma metáfora que organiza o sistema inteiro: o site é uma pequena cidade.

  • Cada autor é um cidadão, com uma casa textual própria em /@nome/.
  • Cada tema é um bairro — Cinema, História, Livros, Programação, Geral.
  • A home é a Praça Central, onde se reúnem os últimos escritos.
  • Textos podem virar cartas endereçadas a outro cidadão, e a curadoria vira jornal e coleções.

Nada disso depende de JavaScript no navegador. O visitante recebe apenas HTML e CSS — a cidade é estática, e a lógica toda vive antes, no momento em que o texto é publicado.


A cidade por dentro

Cidadãos, bairros e casas

A cidadania é aberta: qualquer pessoa se registra por terminal, escolhe um handle e recebe uma identidade técnica (um segredo com hash SHA-256 — não é documento oficial). A partir daí já pode publicar. O Prefeito modera depois, se precisar.

A cada texto publicado corresponde um arquivo .md dentro de content/, com um pequeno cabeçalho YAML (o front matter) que diz o título, o bairro, as tags e a data:

---
title: "A canção de Cassilda"
citizen: "pablo"
district: "cinema"
tags: ["ensaio", "carcosa"]
date: "2026-06-01"
---
# O corpo do texto vem aqui, em Markdown.

Como funciona

A arquitetura em uma frase

Publicar é gravar um arquivo. Ler é um cat. A partir dessa ideia, o sistema tem três peças de infraestrutura e um pacote Python que costura tudo — sem Django, sem Flask, sem framework web.

Duas portas TCP, dois papéis

A cidade não tem login no navegador. Toda a escrita e leitura “por dentro” acontece por TCP puro, atendido por dois pequenos servidores escritos só com a biblioteca padrão do Python:

  • Porta 1900 — leitura (inspirada nos servidores estilo Nex): você manda um caminho e recebe o Markdown bruto, ou a listagem de um diretório. Não autentica: quem alcança a porta, lê.
  • Porta 1915 — publicação: aceita o protocolo SOLED/2 (identidade cidadã) e um protocolo legado do Prefeito. Cada publicação bem-sucedida dispara um rebuild na hora.

O caminho de um texto até a web

você, no terminal (ncat)
        |
        | porta 1915 · SOLED/2 + identidade
        v

public/         ── HTML estático
        |
        v

Caddy :443      ── HTTPS automático
        |
        v

navegador

O build.py limpa a pasta public/ e a regenera inteira a cada vez: páginas, índices por ano/mês, páginas de bairro, tags, feeds RSS (global, por cidadão e por bairro), sitemap.xml, 404 e um endpoint de saúde. O visitante final só toca em arquivos estáticos servidos pelo Caddy, que cuida do HTTPS sozinho.


A experiência

Publicar por linha de comando

Como não há formulário, o cidadão monta um “pacote de texto” e envia com ncat (ou nc). O site inclui um guia inteiro para isso. Um envio SOLED/2 tem esta forma — a identidade real fica no lugar do marcador:

# enviar um texto para a cidade (porta 1915)

SOLED/2
CITIZEN pablo
IDENTITY <sua-identidade-cidadã>
PATH citizens/pablo/posts/meu-texto.md

---
title: "Meu texto"
district: "cinema"
---

# Corpo do texto

.

O protocolo tem mais verbos: REGISTER (virar cidadão), PREVIEW (validar sem gravar), LIST (listar seus arquivos) e RECOVER (recuperar a identidade). Há limite de taxa por IP e moderação — banir IP ou cidadão — quando necessário.


Ficha técnica

Do que a cidade é feita

A apresentação é um único arquivo base.html: tema escuro, fonte monoespaçada, CSS embutido, nenhum pipeline de front-end. Toda a instalação em servidor é um script bash idempotente que prepara pacotes, venv, systemd, Caddy e firewall de uma vez.


Por que assim

A filosofia de design

  • Texto primeiro. Publicar é gravar um arquivo; ler é um cat ou uma linha de TCP.
  • Estático na web. O visitante recebe HTML e CSS. Zero lógica no request HTTP.
  • Rebuild síncrono. Cada publicação regenera o site imediatamente.
  • Poucas dependências. Quanto menos peças, menos coisa para quebrar ou envelhecer.
  • Segurança por camadas. Identidade cidadã, limite de taxa, moderação e bloqueio de path traversal na leitura e na escrita.

Feito em texto. Servido por silêncio. Lido por navegador ou terminal.

— o rodapé de toda página em Soledade

Soledade é, no fim, uma aposta calma: que um lugar de escrita pode existir sem métricas, sem infinito scroll e sem algoritmo — só casas, bairros e palavras. A cidade está aberta, e a cidadania também.

Visite a cidade em soledade.city :)

Read more

Pablo Murad pablomurad.com

Memórias Binárias – Parte I

Meu primeiro contato com computadores foi por volta de 1993/94, jogando Duke Nukem na casa de um primo, em Cruzeiro. E, cara, era muito bom. Aquilo me fascinava. E não estou falando do jogo, não, mas da máquina, do sistema, das possibilidades.

Duke Nukem

Apesar de ainda estar cego, com meus olhos infantis, para todas aquelas possibilidades, eu via possibilidades do mesmo jeito. Como a de “desenhar no computador”, ouvir música ou simplesmente ouvir a máquina ligar.

O barulho mecânico do Windows ao inicializar era incrível. Tudo se encaixando, se conectando e, no final, na tela preta do terminal, digitar apenas:

WIN

Era isso. O Windows podia ser iniciado.

E os jogos ilimitados? Aí sim, estou falando de jogo. Era Campo Minado e um de cartas que nunca aprendi a jogar. Mas era muito bom.

Meu primeiro contato com a internet foi em meados de 1995, sentado ao lado do meu tio Dirceu, o nerd mais velho que conheço e que hoje está descansando no paraíso, na fibra ótica de Deus.

Tio Dirceu - em memória

Ele acessava o que chamava de BBS e, em outro PC, estava no IRC. Não lembro qual BBS era, mas o IRC, salvo engano, era EFNet.

BBS era assim! Mas não era essa... não me lembro qual era.

E as telas de arte ASCII e tudo mais eram hipnotizantes. Eu amava. Era lindo. E eu queria ver mais.

Em 1996, ganhei meu primeiro PC, com seu absoluto poder e um modem destemido da USRobotics. Minha conexão com AIM era incrível nos meus 9 kbps. Incrivelmente instalada pelo meu amigo Dionísio, que também me colocou, pela primeira vez, no ICQ e no meu IRC.

E olha que doido: eu tinha um nick.

O nick era a identidade, era como éramos conhecidos no mundo virtual. O meu era Wagon, que significava “vagão”. Eu tinha visto aquilo em um adesivo num caderno. Não sabia o que significava, mas, quando Dionísio me perguntou qual nick eu queria, foi a primeira coisa que vi na minha frente.

Dois dias para conseguir baixar uma música. Isso se tivesse sorte e tentasse depois da meia-noite, nos feriados.

Então, eu queria saber mais.

Depois de muita briga com minha mãe, comprei um livro de Delphi na Avalon, uma antiga livraria da minha cidade. E, teoricamente, eu, como criança, não deveria saber nada daquilo.

Mas aprendi.

Criei meu primeiro software em Delphi, e ele fazia o que havia de mais legal para uma criança: era um botãozinho que, ao clicar, mudava o programa inteiro de cor.

Didático. Livro bem didático.

Continua.

Read more

Pablo Murad pablomurad.com

RATs e o controle remoto invisível

Existe uma invasão que não quer apenas roubar um arquivo e desaparecer. Ela quer ficar. Quer assistir à tela, registrar o que você digita, abrir pastas, mover o mouse e esperar a hora certa de agir. Esse é o RAT, sigla de Remote Access Trojan, ou trojan de acesso remoto.

OBS: Links para tabela cronológica da minha pesquisa.

O CERT.br o descreve como a combinação de um cavalo de Troia com uma porta dos fundos. Primeiro vem o engano que coloca o programa dentro do aparelho. Depois fica aberto um canal para o criminoso voltar. A diferença mais incômoda está aí: muitas ações não são decididas pelo malware. Existe uma pessoa do outro lado observando o contexto e escolhendo o próximo passo.

Isso muda a natureza do ataque. Um código automático procura arquivos, senhas ou carteiras de criptomoedas seguindo regras. Um operador consegue esperar você abrir o banco, montar uma tela falsa naquele instante, esconder uma transação e mudar a abordagem se perceber que alguma coisa deu errado.

Nem todo acesso remoto é RAT

O nome costuma ser usado para situações diferentes. Separar as categorias evita alarmismo e ajuda a entender o risco real.

Categoria

O que define

Exemplos

RAT malicioso

Entra sem consentimento, tenta se esconder e entrega controle ao invasor.

BRATA, JanelaRAT, BTMOB

Ferramenta legítima abusada

O programa é normal, mas a conta ou a sessão foi obtida por fraude.

AnyDesk, TeamViewer, RustDesk, RDP, VNC

Banker com controle remoto

O objetivo principal é a fraude bancária, mesmo com tela, teclado e mouse remotos.

Grandoreiro, Janeleiro, Maverick

A pergunta mais útil é simples: eu pedi esse acesso, sei quem está conectado e consigo encerrar a sessão? Se a resposta for não, o nome técnico vira detalhe. Já existe um incidente.

O que muda quando há alguém operando

Um RAT pode reunir captura de tela, registro de teclas, câmera, microfone, localização, leitura de notificações, cópia de arquivos e execução de comandos. Nem toda família possui todas essas funções, mas o princípio é o mesmo. O aparelho deixa de responder apenas ao dono.

Em fraude bancária, o operador não precisa adivinhar o momento certo. Ele pode ver quando a pessoa entra no aplicativo, cobrir a tela com uma camada escura, mostrar uma janela falsa e operar por baixo. Em espionagem, pode buscar uma pasta específica, selecionar conversas e ativar sensores. Em uma empresa, pode usar a primeira máquina como entrada para alcançar contas e sistemas internos.

O perigo também não termina quando a janela de suporte fecha. Se o invasor instalou outro componente, criou uma inicialização automática ou roubou credenciais, desinstalar o programa visível não resolve tudo.

Como o golpe chega até o controle

Os casos brasileiros mudam de embalagem, mas repetem uma cadeia conhecida. A isca pode ser uma cobrança, um documento fiscal, uma falsa atualização, um benefício do governo, um arquivo enviado pelo WhatsApp ou uma ligação do suposto suporte do banco.

Depois vem a ação da vítima. No computador, aparecem ZIP, LNK, MSI, scripts ou páginas que mandam abrir o Executar e colar um comando. Esse truque é chamado de ClickFix. No Android, a isca tenta levar a um APK falso e pede acesso à Acessibilidade, leitura de notificações, sobreposição de tela ou instalação de outros aplicativos. No falso suporte, a própria pessoa instala uma ferramenta remota legítima e entrega o código da sessão.

Quando o programa consegue executar, ele tenta continuar disponível. Pode criar uma entrada de inicialização, instalar um serviço, esconder uma janela ou manter uma conexão periódica com o servidor de comando e controle. Só então o operador recebe a tela, os comandos e os dados necessários para agir.

Figura 1. A cadeia resume comportamentos recorrentes. Uma campanha pode pular etapas, trocar ferramentas ou combinar malware com software legítimo.

O que trinta anos de nomes revelam

O PDF que serve de base para esta pauta reuniu 300 famílias e ferramentas associadas a acesso remoto entre 1989 e 2018. A própria autora trata a lista como uma amostra curada, não como um censo de todos os RATs existentes. O ano de 2018 também estava incompleto.

Mesmo com esses limites, a distribuição é reveladora. Dos 300 itens, 217 aparecem a partir de 2010. São 72% da amostra. Isso não prova que 72% de todos os RATs nasceram naquele período. Mostra que a parcela mais densa do catálogo está concentrada nos anos em que construtores, painéis, código reaproveitado e venda de acesso tornaram esse tipo de ferramenta mais fácil de obter e operar.

Figura 2. Distribuição dos 300 itens da terceira versão do estudo. A amostra é curada, não exaustiva, e 2018 estava incompleto.

A história não é apenas de crescimento numérico. Os alvos e os dispositivos mudaram. O RAT saiu do computador doméstico e chegou ao celular, ao ambiente corporativo e à fraude financeira operada ao vivo. Também virou serviço. Quem compra um kit pronto não precisa dominar cada parte do código para espionar ou controlar uma vítima.

No Brasil, o controle remoto encontra o dinheiro

O próprio CERT.br usa como exemplo o controle interativo durante uma sessão de Internet Banking. Não é por acaso que tantos casos observados no país misturam RAT, trojan bancário e suporte remoto fraudulento.

Em 2019, o BRATA mostrou como esse risco funcionava no Android. Uma das campanhas usava uma falsa correção do WhatsApp. O aplicativo abusava da Acessibilidade para monitorar a tela, capturar credenciais, ler mensagens e ganhar controle amplo do celular. Ele apareceu até no Google Play, lembrando que loja oficial reduz o risco, mas não substitui atenção ao desenvolvedor e às permissões solicitadas.

Em 2021, a ESET documentou o Janeleiro, direcionado a usuários corporativos no Brasil. Ele observava janelas do navegador e permitia que o operador apresentasse telas bancárias falsas sob demanda. O nome se parece com JanelaRAT, mas são famílias diferentes. Janeleiro é banker. JanelaRAT é um RAT financeiro documentado anos depois.

O Grandoreiro ajuda a enxergar essa zona de contato. Ele é um trojan bancário, não um RAT genérico, mas oferece ao operador bloqueio da tela, registro de teclas, simulação de mouse e teclado e pop-ups falsos. Em janeiro de 2024, a Polícia Federal realizou uma operação contra sua infraestrutura com apoio técnico da ESET.

Há também ataques sem RAT na primeira etapa. A Mandiant investigou um grupo que telefonava para funcionários de empresas brasileiras fingindo ser o suporte de TI. A vítima instalava AnyDesk e entregava o acesso. Em outras cadeias, o grupo usou ferramentas de gerenciamento remoto e também malware. A mesma operação pode combinar software legítimo, credenciais roubadas e backdoor.

O WhatsApp virou outro atalho. Em outubro de 2025, a Kaspersky bloqueou 62 mil tentativas de infecção do banker Maverick no Brasil durante os dez primeiros dias da campanha analisada. O arquivo ZIP vinha de contas comprometidas, iniciava uma cadeia no Windows e ainda tentava sequestrar o WhatsApp para continuar se espalhando. Isso é telemetria de uma empresa, não 62 mil pessoas infectadas.

Em 2026, o cenário continuou chegando por caminhos familiares. O CTIR Gov alertou sobre páginas falsas ou comprometidas que imitavam serviços governamentais e distribuíam malware. Também descreveu páginas do tipo ClickFix, que mandavam a vítima copiar um comando para o Windows. No celular, pesquisadores encontraram o BTMOB em uma campanha voltada ao Brasil. O RAT era distribuído por páginas falsas e aplicativos maliciosos, capturava tela, coletava dados e assumia o aparelho.

No mesmo período, a Kaspersky informou que sua telemetria havia registrado 14.739 ataques ligados ao JanelaRAT no Brasil em 2025. Novamente, ataque detectado não é sinônimo de vítima única, infecção concluída ou total nacional.

Figura 3. A linha histórica e os casos brasileiros foram separados para não confundir uma amostra mundial com incidência nacional.

O tamanho do problema que não sabemos medir

O Brasil aparece repetidamente em pesquisas de segurança, campanhas direcionadas e operações policiais. Isso é evidência de atividade, não uma taxa nacional de RAT.

As bases públicas consultadas do CERT.br e da Polícia Federal trabalham com categorias mais amplas. Elas não oferecem uma série exclusiva capaz de responder quantos RATs infectaram brasileiros ou quanto esse tipo de ataque cresceu. As notificações do CERT.br são voluntárias, e os números de empresas de segurança dependem da base de clientes e dos produtos que cada uma consegue observar.

Por isso, detecção, tentativa, ataque e vítima não podem ser trocados como se fossem a mesma coisa. Um aparelho pode gerar várias detecções. Uma tentativa bloqueada pode não produzir infecção. Uma campanha estudada no Brasil não representa todas as campanhas em circulação.

Essa limitação não enfraquece o alerta. Ela só impede que uma ameaça real seja explicada com estatística inventada.

Sinais que merecem atenção

Cursor se movendo sozinho, tela preta durante o uso do banco, câmera ou microfone ativados sem motivo, aplicativo desconhecido com acesso à Acessibilidade e mensagens enviadas pelo próprio WhatsApp são sinais importantes. Também vale desconfiar de ferramenta remota instalada depois de uma ligação não solicitada de banco, governo ou suporte.

Nenhum desses sinais, isoladamente, confirma um RAT. Uma falha de driver pode mexer com a tela. Um aplicativo legítimo pode usar Acessibilidade. O diagnóstico vem do conjunto: instalação inesperada, permissões amplas, conexão remota, alteração de conta e comportamento que a pessoa não iniciou.

Em empresas, a investigação precisa olhar a sequência. Um agente remoto novo, seguido por inicialização automática, conexão externa longa e abertura de PowerShell ou Prompt de Comando, é mais significativo do que um executável isolado. Ferramentas portáteis também importam, pois podem funcionar sem uma instalação tradicional.

O que fazer quando a suspeita aparece

1. Interrompa a conexão.

Desligue Wi-Fi, cabo e dados móveis. Isso corta o canal de controle, embora não remova o malware.

2. Pare de usar o aparelho para dinheiro ou senhas.

Não abra o banco e não tente testar se está tudo normal. Use outro dispositivo confiável para falar com a instituição e trocar as credenciais mais sensíveis.

3. Preserve o que ajuda a entender o incidente.

Guarde mensagens, números de telefone, nomes de arquivos, horários e comprovantes. Em uma empresa, acione TI ou segurança antes de formatar. Apagar tudo pode destruir registros úteis.

4. Encerre acessos remotos conhecidos.

Revogue sessões, troque senhas e remova a ferramenta instalada por orientação do golpista. Considere que outro componente pode ter ficado no sistema.

5. Limpe ou reinstale com segurança.

Antimalware pode identificar parte da cadeia, mas uma máquina comprometida nem sempre merece confiança depois de uma remoção simples. Dependendo do caso, restaure um backup confiável ou reinstale o sistema.

6. Avise quem precisa agir.

Banco, empresa, provedor e autoridades podem bloquear contas, preservar registros e reduzir o dano. Incidentes de rede também podem ser notificados ao CERT.br.

Prevenção sem transformar tudo em medo

Não abra ZIP, LNK, MSI, APK ou correção urgente só porque chegou de um conhecido. A conta dele pode ter sido comprometida. Confirme por outro canal. Feche páginas que mandam pressionar Win+R, colar um comando ou abrir PowerShell para provar que você não é um robô.

No Android, confira o desenvolvedor e trate Acessibilidade, sobreposição de tela, leitura de notificações, câmera, microfone e instalação de outros apps como permissões de alto impacto. No computador, mantenha sistema, navegador e antimalware atualizados. Ative autenticação em duas etapas nas contas importantes.

Em empresas, ferramentas remotas precisam de inventário, responsáveis e regras. Permitir apenas soluções aprovadas, exigir autenticação forte, limitar privilégios, registrar sessões e monitorar conexões torna o abuso mais visível. O treinamento também deve incluir falso suporte, WhatsApp e ClickFix, não apenas o velho anexo de e-mail.

O ponto central é simples. RAT não é apenas software malicioso. É presença humana escondida dentro do aparelho. A defesa começa quando tratamos anexos, comandos copiados, permissões e pedidos de acesso remoto como decisões de segurança, não como etapas banais de suporte.

Referências reunidas no fim para manter a leitura limpa.

Veronica Valeros e Stratosphere Laboratory. A Study of RATs e Third Timeline Iteration.

CERT.br. Códigos Maliciosos, Cartilha de Segurança para Internet.

CERT.br. Servidor de comando e controle de RAT.

CERT.br. Estatísticas de Incidentes.

Polícia Federal. Dados Estatísticos de Combate a Crimes Cibernéticos.

GSI. Orientação sobre segurança em soluções de acesso remoto.

CTIR Gov. Recomendação 02/2026.

CTIR Gov. Recomendação 03/2026.

CISC Governo Digital. Malware utilizando WhatsApp.

ENCCLA. Fraude do falso técnico e abuso de software de acesso remoto.

MITRE ATT&CK. Remote Access Software, T1219.

Kaspersky. BRATA: RAT Android observado inicialmente no Brasil.

ESET Research. Janeleiro: trojan bancário direcionado a usuários corporativos no Brasil.

ESET Research. Operação contra o trojan bancário Grandoreiro.

Google Cloud e Mandiant. BREEZE COMET targets Brazil.

Kaspersky GReAT. Maverick banker distributing via WhatsApp.

Kaspersky GReAT. JanelaRAT: a financial threat targeting users in Latin America.

ESET Research. BTMOB: A stealthy RAT burrowing deep into Android devices.

Read more

Pablo Murad pablomurad.com

Como enviar e-mails com mais privacidade

A resposta curta

Se o objetivo é separar o e-mail da sua identidade civil, Mullvad com Tuta é a combinação mais coerente entre as duas opções deste guia. A Mullvad gera uma conta numérica e não pede nome, usuário, senha nem endereço de e-mail. A Proton VPN também mantém uma política sem logs de atividade, mas o fluxo gratuito atual pede um e-mail externo de recuperação. Se você usar seu endereço pessoal, o vínculo nasce antes mesmo de abrir o Tuta. [5] [10] [12]

Para privacidade cotidiana, Proton VPN com Tuta funciona bem. Para uma identidade pseudônima mais isolada, Mullvad leva vantagem. Nenhuma das duas combinações protege contra um computador comprometido, uma ordem judicial válida, erros no conteúdo da mensagem, metadados de anexos ou correlação de tráfego feita por um adversário com grande capacidade. [2] [4]

Três palavras que não significam a mesma coisa

·   Privacidade significa reduzir quem consegue observar sua comunicação e quais dados ficam disponíveis.

·   Pseudonimato significa usar uma identidade persistente que não aponta diretamente para seu nome civil.

·   Anonimato significa impedir que a ação seja ligada a uma pessoa. Na internet aberta, isso depende de toda a cadeia e nunca deve ser presumido.

O que esta combinação protege

·   O Tuta recebe o IP de saída da VPN em vez do seu IP residencial.

·   Seu provedor de internet vê uma conexão criptografada com a VPN, não uma conexão direta com o Tuta.

·   O destinatário não recebe seu IP residencial nos cabeçalhos enviados pelo Tuta, que declara remover esses endereços das mensagens.

·   A VPN reduz a exposição em redes públicas e evita que uma queda acidental revele o IP quando o kill switch está funcionando.

·   O Tuta cifra o conteúdo armazenado. Entre contas Tuta, ou no modo protegido por senha para destinatário externo, a mensagem pode usar criptografia ponta a ponta.

Essas proteções são úteis, mas nenhuma delas corrige um nome de usuário conhecido, um arquivo com autor gravado ou um texto que revele detalhes biográficos. [1] [3]

Diagrama mostrando o que o dispositivo, a VPN, o Tuta, o destinatário e o provedor de internet conseguem observar.

A VPN separa seu IP residencial do provedor de e-mail. As outras camadas continuam existindo.

O que ela não protege

Uma VPN concentra confiança em outro intermediário. Ela vê seu IP real e o destino da conexão. Com HTTPS funcionando corretamente, não lê o texto do e-mail, mas conhece horários e volumes. Um observador que monitore vários pontos da rede pode tentar correlacionar esses padrões.

O navegador também pode identificar você por cookies, contas abertas, extensões e impressão digital. Por isso, usar o mesmo Firefox cheio de extensões e com Google, Microsoft ou redes sociais conectadas desfaz boa parte do isolamento.

O Tuta não registra IP por padrão e remove IPs dos cabeçalhos, mas sua política reconhece metadados necessários, como endereços de remetente e destinatário e datas. O relatório de transparência informa que uma ordem judicial alemã válida pode exigir monitoramento futuro de tráfego para uma conta específica. Nessa situação, o IP observado seria o da VPN, não uma garantia de impunidade ou anonimato. [2] [4]

Mensagens comuns enviadas a Gmail, Outlook ou outro provedor externo não ficam automaticamente protegidas de ponta a ponta. Elas usam criptografia de transporte durante a entrega, e o provedor do destinatário pode processar o conteúdo. Para mensagem externa sensível, use o modo protegido por senha e combine a senha por outro canal.

Cinco faixas mostram vazamentos de identidade por conta, navegador, conteúdo, anexos e rotina.

A maior parte das falhas acontece fora da VPN. Separe conta, navegador, conteúdo, anexos e rotina.

Comparação entre Proton VPN e Mullvad

Neste artigo, Proton significa Proton VPN. O serviço de e-mail continua sendo o Tuta nos dois caminhos.

Critério

Proton VPN com Tuta

Mullvad com Tuta

Cadastro

O fluxo gratuito atual pede um e-mail externo de recuperação.

Gera uma conta numérica sem nome, senha ou e-mail.

Registros

Política sem logs de tráfego, IP, duração de sessão ou localização.

Não registra tráfego, DNS, conexões, horários, IP ou banda vinculados à conta.

Custo

Há plano gratuito, sem cartão.

Custa 5 euros por mês, sem desconto por prazo.

Falha da VPN

Kill switch padrão e modo avançado, conforme a plataforma.

Kill switch sempre ativo durante a conexão e Lockdown opcional fora dela.

Vínculo de identidade

Pode ser forte se a recuperação ou o pagamento usar dados pessoais.

A conta numérica reduz o vínculo; cartão e PayPal ainda deixam dados de pagamento.

Uso indicado

Privacidade cotidiana e opção gratuita.

Separação pseudônima mais coerente e simples.

Resumo baseado nas políticas e guias oficiais consultados em 11 de setembro de 2026.

A escolha depende do risco. Se você quer uma camada extra de privacidade sem pagar, Proton VPN é uma boa opção. Se quer evitar que a própria conta da VPN peça um e-mail e aceita pagar 5 euros por mês, Mullvad é mais consistente. Pagamento com cartão ou PayPal ainda cria um registro financeiro; dinheiro enviado pelo correio ou Monero reduzem esse vínculo, mas não transformam toda a operação em anônima. [5] [9]

Preparação antes do cadastro

Faça esta preparação antes de abrir o site da VPN ou do Tuta. Misturar identidades durante o cadastro é o erro mais difícil de corrigir depois.

1. Defina o objetivo. Para esconder o endereço residencial de um destinatário comum, uma VPN confiável já ajuda. Para uma denúncia de alto risco, o caminho adequado costuma ser o SecureDrop oferecido pela própria organização, acessado pelo Tor Browser.

2. Separe o ambiente. Crie um perfil de usuário dedicado no computador ou, no mínimo, use uma instalação separada do Mullvad Browser. Não entre em contas pessoais nesse ambiente.

3. Desative sincronização, preenchimento automático e importação de favoritos. Não leve cookies, senhas ou histórico do navegador principal.

4. Decida como guardar credenciais. O número da Mullvad e o código de recuperação do Tuta funcionam como chaves de acesso. Guarde-os fora do e-mail, preferencialmente em papel ou em um cofre criptografado separado.

5. Escolha um pseudônimo novo. Não reaproveite apelido, domínio, avatar, frase de perfil ou padrão de endereço já associado a você.

Caminho um Proton VPN com Tuta

Este caminho é prático e pode ser gratuito. Ele serve melhor para privacidade comum do que para uma separação forte de identidade, porque a criação da conta gratuita da Proton VPN pede um endereço externo de recuperação.

Passo 1 Crie a conta Proton VPN

1. Abra o endereço oficial de cadastro da Proton VPN no navegador separado.

2. Use um e-mail de recuperação que não revele sua identidade. Se você informar seu endereço pessoal, considere esta rota uma solução de privacidade, não de anonimato.

3. Crie uma senha exclusiva. Não use a mesma senha do Tuta e não salve a credencial no navegador pessoal.

Cadastro oficial https://protonvpn.com/support/how-to-create-free-vpn-account

Passo 2 Proteja a conexão

1. Instale o aplicativo oficial da Proton VPN e mantenha-o atualizado.

2. Ative conexão automática e o kill switch. No Windows e no aplicativo gráfico do Linux, prefira o modo avançado quando o computador for dedicado a essa identidade.

3. Desative o split tunneling para esse uso. Caso contrário, o navegador pode sair por fora do túnel por engano.

4. Conecte-se antes de abrir o navegador dedicado. Confirme que o endereço IP público mudou e que não há vazamento evidente de DNS ou WebRTC.

Guia do kill switch https://protonvpn.com/support/advanced-kill-switch

No Linux, o cliente atual também oferece o kill switch padrão pela linha de comando:

protonvpn config set kill-switch standard

Passo 3 Crie o endereço Tuta

1. Com a VPN conectada, abra o Mullvad Browser ou outro navegador exclusivo para essa identidade.

2. Acesse app.tuta.com, escolha Sign up e crie um endereço que não tenha nome, iniciais, data de nascimento ou apelido conhecido.

3. Use uma senha longa, exclusiva e aleatória. Anote imediatamente o código de recuperação mostrado pelo Tuta.

4. Se a conta entrar em aprovação por ter sido criada por VPN, espere até 48 horas. O próprio Tuta informa que o suporte não consegue acelerar essa análise.

Cadastro do Tuta https://app.tuta.com/signup

Caminho dois Mullvad com Tuta

A Mullvad é o caminho recomendado neste guia para uma identidade pseudônima mais isolada.

Ela gera um número de conta e não pede e-mail, nome de usuário ou senha.

Passo 1 Crie e financie a conta Mullvad

1. Abra o aplicativo oficial ou o site da Mullvad e gere uma nova conta numérica.

2. Copie o número para um local seguro. Quem tiver esse número pode usar a conta, e a recuperação é limitada.

3. Adicione tempo. Cartão, PayPal e transferência são convenientes, mas processam dados de pagamento. Dinheiro pelo correio ou Monero reduzem a ligação direta entre pagamento e identidade. Escolha de acordo com seu risco real.

4. Não reutilize uma conta Mullvad já associada ao seu uso pessoal se a separação entre identidades for importante.

Política de registros https://mullvad.net/en/help/no-logging-data-policy

Passo 2 Configure a proteção contra vazamentos

1. Instale o aplicativo oficial e ative Launch app on start-up e Auto-connect.

2. O kill switch da Mullvad já fica ativo enquanto a VPN está conectando ou sofre uma falha. Ative Lockdown mode para bloquear a internet mesmo depois de clicar em Disconnect ou Quit.

3. Não coloque o navegador dedicado no split tunneling. Aplicativos excluídos continuam acessando a internet fora da VPN, inclusive com Lockdown mode.

4. Conecte e use a página de verificação da Mullvad para checar a conexão, DNS e WebRTC.

Verificação de conexão https://mullvad.net/en/check

No terminal, o Lockdown mode pode ser ativado assim:

mullvad lockdown-mode set on

Passo 3 Use um navegador separado

O Mullvad Browser foi desenvolvido com o Tor Project para reduzir rastreamento e impressão digital. Ele pode ser usado com Proton VPN, Mullvad ou outra VPN confiável. Deixe as configurações próximas do padrão, não instale extensões e não faça login em serviços pessoais. [7]

Mullvad Browser https://mullvad.net/en/browser

Passo 4 Crie e proteja a conta Tuta

1. Só abra o Tuta depois que a VPN estiver conectada e verificada.

2. Escolha um endereço sem relação com seus outros nomes. Não use foto, assinatura ou texto de perfil.

3. Guarde a senha e o código de recuperação separadamente. Se perder ambos, o Tuta não consegue devolver o acesso.

4. Ative autenticação em dois fatores por TOTP ou chave física. Evite qualquer método que exija um número de telefone pessoal.

5. Contas gratuitas do Tuta podem ser apagadas após mais de seis meses sem login. Crie uma rotina discreta para não perder o endereço.

Como enviar sem entregar sua identidade

A configuração técnica só funciona quando o modo de uso continua separado. Antes de cada mensagem, passe por esta lista.

·   Conecte a VPN antes de abrir o navegador ou aplicativo do Tuta.

·   Confirme a conexão, o DNS e o WebRTC. Não continue se o IP residencial aparecer.

·   Não abra Gmail, Outlook, Google Drive, redes sociais ou contas de trabalho na mesma sessão.

·   Não use assinatura, telefone, domínio próprio, avatar ou estilo visual já associado a você.

·   Evite fatos biográficos desnecessários. Cidade, cargo, datas, horários e relações pessoais podem identificar mais do que o IP.

·   Não cole links privados de nuvem ou URLs do seu próprio servidor. O link pode revelar a conta ou produzir registros de acesso.

·   Revise anexos, nomes de arquivo e conteúdo visível antes de enviar.

·   Não encaminhe a mensagem depois para sua conta pessoal e não responda por outro endereço.

Escolha o modo de envio correto

Três cartões comparam Tuta para Tuta, Tuta protegido por senha e e-mail normal para provedor externo.

A criptografia ponta a ponta depende do modo de envio. E-mail normal para um provedor externo não recebe a mesma proteção.

Para um contato que já usa Tuta, a criptografia ponta a ponta funciona automaticamente. Para alguém em outro serviço, selecione o envio confidencial e defina uma senha. Compartilhe essa senha por um canal diferente do e-mail. Uma ligação, uma conversa presencial ou um mensageiro ponta a ponta podem servir, conforme o risco.

Se você enviar como e-mail normal, trate a mensagem como legível pelo provedor do destinatário. TLS protege o caminho entre servidores quando suportado, mas não impede que a caixa de destino processe, indexe, guarde ou entregue o conteúdo por ordem válida.

Anexos e metadados

Fotos podem guardar modelo da câmera, data, localização GPS e software de edição. Documentos podem carregar autor, empresa, comentários, revisões e caminhos internos. A VPN não toca nesses dados.

O método mais seguro é não enviar o arquivo original. Quando possível, copie apenas o trecho necessário para o corpo da mensagem. Se o anexo for indispensável, trabalhe sobre uma cópia, remova metadados e abra o resultado para conferir o conteúdo.

Limpeza básica de uma imagem JPEG

O ExifTool pode remover metadados embutidos de uma cópia da imagem. Por padrão, ele preserva o original com o sufixo _original. Confira a saída antes de apagar esse backup.

exiftool -all= foto-copia.jpg
exiftool -a -G1 -s foto-copia.jpg

Não use esse comando às cegas em RAW, TIFF ou PDF. Em alguns formatos, metadados fazem parte da estrutura; em PDFs, alterações incrementais podem deixar dados antigos recuperáveis. Para documentos Office, use o Inspetor de Documento, remova comentários e revisões e exporte uma cópia nova. Mesmo assim, confira o arquivo final. [16]

Metadados removidos não apagam pistas visuais. Uma captura de tela pode mostrar nome de usuário, caminho de pasta, relógio, idioma, número de série ou conteúdo exclusivo. Leia a imagem como se você fosse a pessoa tentando identificar o autor.

Rotina segura para os próximos acessos

1. Abra o perfil de usuário ou navegador dedicado.

2. Conecte a VPN e confirme o status do kill switch ou Lockdown mode.

3. Verifique IP, DNS e WebRTC quando a mensagem for sensível.

4. Entre apenas no Tuta e nos serviços estritamente necessários para aquela identidade.

5. Envie a mensagem, encerre a sessão e feche o navegador.

6. Não misture arquivos baixados, notas ou credenciais com pastas sincronizadas da sua conta pessoal.

Não é preciso trocar de país ou servidor a cada acesso. Mudanças aleatórias não corrigem um navegador identificável e ainda podem gerar alertas. Consistência operacional vale mais do que ritual sem objetivo.

Quando usar Tor ou SecureDrop

O próprio Tuta recomenda Tor para quem precisa ocultar o IP sem confiar em uma única VPN. O cadastro pode entrar em aprovação por até 48 horas quando vem de Tor ou VPN. Se o site recusar temporariamente um nó, tente outro circuito ou espere, sem criar uma sequência de contas. [1]

Não empilhe VPN e Tor por instinto. O Tor Project diz que essa combinação pode reduzir o anonimato ou quebrar proteções quando é configurada sem conhecimento. Para a maioria das pessoas, use Tor Browser sozinho ou uma VPN com navegador dedicado, conforme o modelo de ameaça. [14]

Se a mensagem for uma denúncia de alto risco e a organização oferecer SecureDrop, prefira esse canal. Ele foi criado para receber documentos de fontes anônimas, minimizar metadados e funcionar por Tor. Siga exatamente as instruções da organização e evite computador de trabalho. [15]

Problemas comuns

O Tuta pediu até 48 horas

Isso pode acontecer com cadastros feitos por Tor ou VPN. Espere o prazo indicado. O suporte informa que não consegue acelerar a aprovação automática.

A internet parou depois de fechar a Mullvad

Provavelmente o Lockdown mode está ativo. Esse é o comportamento esperado: a conexão fica bloqueada até a VPN voltar ou o recurso ser desligado conscientemente.

O Proton VPN pediu um e-mail

O fluxo gratuito atual usa um e-mail externo como nome da conta e recuperação. Se você só dispõe de um endereço pessoal, aceite que essa rota oferece privacidade de conexão, mas não uma separação forte de identidade.

O destinatário usa Gmail ou Outlook

Use o modo confidencial do Tuta com senha se o conteúdo precisar permanecer cifrado de ponta a ponta. Envie a senha por outro canal. Se isso não for possível, assuma que o provedor externo poderá processar a mensagem.

A VPN caiu durante o uso

Feche o navegador e confirme o kill switch antes de continuar. Depois da reconexão, verifique o IP público. Se o aplicativo ou navegador saiu pelo split tunneling, considere que o IP real pode ter sido exposto.

Receita recomendada

Para uma identidade pseudônima de baixo ou médio risco, eu usaria esta sequência:

1. Perfil de usuário separado no computador.

2. Nova conta numérica Mullvad, sem reutilizar a conta pessoal.

3. Mullvad com Auto-connect, kill switch e Lockdown mode.

4. Mullvad Browser sem extensões nem logins pessoais.

5. Novo endereço Tuta sem nome, apelido ou padrão conhecido.

6. Senha exclusiva, código de recuperação guardado fora do e-mail e 2FA sem telefone.

7. Mensagens externas sensíveis enviadas no modo protegido por senha.

8. Anexos copiados, limpos e revisados antes do envio.

Para risco alto, não confie apenas nessa receita. Use Tor Browser ou o SecureDrop oficial do destinatário, evite dispositivos de trabalho e siga as instruções específicas do canal.

Uso responsável

Privacidade protege pessoas em situações legítimas: fontes, pesquisadores, profissionais expostos, vítimas de perseguição e qualquer pessoa que não queira transformar a própria correspondência em dado comercial. Ela não elimina responsabilidade legal e não deve servir para fraude, ameaça, assédio, spam ou dano a terceiros.

A regra prática é simples: uma boa ferramenta reduz rastros técnicos; uma boa rotina evita que você mesmo devolva esses rastros ao sistema.

Fontes consultadas

Documentação oficial consultada em 11 de setembro de 2026. Políticas, preços e interfaces podem mudar; confira os links antes de seguir o procedimento em uma situação sensível.

1. Tuta. Anonymous email.

2. Tuta. Privacy Statement.

3. Tuta. Security at Tuta.

4. Tuta. Transparency Report and Warrant Canary.

5. Mullvad. No logging of user activity policy.

6. Mullvad. Using the Mullvad VPN app.

7. Mullvad. Mullvad Browser.

8. Mullvad. Connection check.

9. Mullvad. Pricing.

10. Proton VPN. Does Proton VPN keep logs.

11. Proton VPN. Privacy policy.

12. Proton VPN. How to create a free VPN account.

13. Proton VPN. How to use advanced kill switch.

14. Tor Project. Using Tor Browser with a VPN.

15. SecureDrop. Share and accept documents securely.

16. ExifTool. Frequently asked questions.

Read more

Pablo Murad pablomurad.com

Memórias Binárias – Parte II

Delphi foi uma alegria incrível naqueles meus primeiros anos como programador, e eu amava o pouco que sabia. Era o suficiente para ganhar elogios de adultos que nitidamente não entendiam nada do que eu estava fazendo, e menos ainda do que estavam vendo.

Mas funcionava.

Eu tinha um amigo de infância chamado Daniel. Bem, ainda somos amigos, mas mais distantes, devido a termos crescido e vivermos basicamente cada um em um extremo do país. Gosto de pensar que nos vemos a cada pandemia. E é legal, pois parece que nos vimos ontem pela última vez.

Daniel seguiu seu rumo como economista. E eu segui meu rumo, extremamente obscuro até então. Mas, na época, adorávamos revistas de hacker que vendiam no Brasil. Ao mesmo tempo, eu já vivia em redes de IRC, operando firmemente como ‘op’ em canais e até como NetAdmin em umas redes malucas e como IRCop em outras.

Em paralelo, meu amigo Daniel e eu comprávamos revistas em bancas, pois a internet da USRobotics já não era mais suficiente, e essas revistas vinham com diversos softwares. Uma grande memória da Revista Hacker.

Revista H4ck3r

E não só ela: havia Top Hacker, H4ck3r (da Digerati), Digerati Hacker, Universidade Hacker e também uma das minhas favoritas, que era a Geek.

E foi através da Revista Hacker que li a palavra: Sub7. Poucos devem se lembrar desse RAT, que era o terror do IRC e do ICQ. Um trojanzinho de ‘brincadeira’ que tornava incrível invadir pessoas; depois de ter em mãos, o negócio era ir atrás do famoso ‘Joiner’, que muitas vezes era nada mais que um script para fundir dois arquivos.

Ou seja, você pegava o .exe e colocava em .jpg, mas isso era uma enganação. Só trocava o ícone. Mas já nos dávamos como satisfeitos.

Revista Geek

A infame revista Geek de que tanto falei, onde tinha meus softwares favoritos...

Daniel e eu éramos os reis dos RATs, adorávamos ‘trollar’ as pessoas, as mais diversas, e os RATs, como Sub7, Back Orifice e Netbus, são um pouco antecessores de outra ferramenta que usei muito nos anos 2000: os keyloggers.

Falarei mais dos keyloggers talvez em outro capítulo.

Então em 1999, eu conheci o Leo Louco.

Um gênio que veio parar na minha cidade depois de algum acidente maluco, que contava histórias de ter arrumado notebook na floresta embaixo de chuva torrencial. O Leo é uma criatura extraordinária, mente incrível, extremamente acelerada, e foi, por um ou dois meses, meu professor. Não mais que isso, porque ninguém aguentava passar mais tempo com ele. Mas sim, ele é uma boa pessoa.

Usando seus óculos e ensinando ao Daniel e a mim, desde 1999, os princípios e valores do Software Livre, coisa que devo confessar que desprezei até 2016. Mas também falarei disso em outra oportunidade.

O Grande Leo

Leo era tão bizarro. Mas tão bizarro que, em nossas primeiras aulas, ele me colocou na cadeira do seu laboratório e disse as palavras que, na época, soaram como mágica. Ele disse: você irá aprender SLACKWARE.

Imagine alguém dizendo isso devagar e de forma confiante. Eu fiquei apavorado; não sabia o que era, apenas que era Linux, mas não tinha noção do quão difícil era.

E a primeira lição foi construir um drive para modem... e para Slackware.

Continua...

Read more

Pablo Murad pablomurad.com

Hammer

Tem uma época da internet que eu simplesmente não esqueço: a dos BBS. Você discava, o modem cantava aquela música estranha, e do outro lado abria um mundo inteiro feito de texto — menus desenhados em ASCII, cores piscando no terminal, um canto pra conversar, pra baixar alguma coisa, pra jogar. Era pequeno, artesanal, e tinha alma. Cada sistema era a cara de quem o mantinha.

O Hammer nasceu dessa saudade. Não veio de uma necessidade de mercado, nem de métrica nenhuma, nem de um plano grandioso. Veio do gosto pela net antiga e da vontade boba e teimosa de ver de novo aquela tela de terminal se abrindo quando a gente se conecta. Foi diversão, no sentido mais honesto da palavra — o tipo de projeto que você faz no fim de semana porque te dá prazer, não porque alguém pediu.

“E se, em vez de mais um site, o ponto de entrada fosse o próprio SSH?”

Essa foi a pergunta que puxou o resto. Você abre o terminal, digita um comando, e cai num menu — como nos velhos tempos, só que rodando sobre a infraestrutura de hoje, com criptografia de verdade e sem discar. A nostalgia por fora; engenharia atual por dentro.

O que é o Hammer

No fundo, o Hammer é uma caixa de ferramentas que você acessa por SSH. Você se conecta e encontra um menu interativo, com cores e caixas desenhadas, exatamente no espírito de um BBS. A primeira ferramenta a nascer foi a de clima — pergunta a previsão de qualquer cidade e ela responde ali, no terminal, em texto bonito. Mas a graça é que o clima é só a primeira gaveta de um armário que vai crescendo.

Ao lado dele foram entrando pequenos utilitários do dia a dia de quem mexe com rede e texto:

●        net — checagens de DNS, TLS, HTTP e informações de domínio;

●        qr — gera QR Code em ASCII, para URL, telefone ou texto;

●        hash — resumo, tipo e entropia de qualquer conteúdo colado;

●        jq — transforma e filtra JSON e YAML;

●        age — cifra e decifra mensagens;

●        e outros que aparecem no menu só quando o servidor tem o que precisam — como checagem de links, consultas a bases e diagnóstico de rota.

Cada uma delas segue a mesma filosofia: um vocabulário fechado, com entradas validadas. Nada de abrir um shell solto para o mundo — é um menu com portas certas, não uma porta dos fundos.

Como foi construído

O Hammer é escrito em Go, e a decisão que define quase todo o resto foi esta: ele é um único binário estático. Fontes, traduções, modelos de página e o que mais o programa precisa ficam embutidos dentro do próprio executável (o recurso de embed da linguagem). O resultado é que não há dependências soltas para instalar, nem servidor extra na frente: um arquivo só, que você copia e roda.

A porta de entrada nostálgica — o BBS — é um servidor SSH próprio. Quando você conecta, ele desenha o menu, lê tecla por tecla, cuida de acentos e emojis na largura certa do terminal, e mantém um perfil só seu: cidade padrão, cidades salvas, unidades, idioma e tema. Esse perfil fica guardado num banco leve, para voltar igual na próxima visita.

O serviço de clima tem uma herança que eu faço questão de creditar: ele começou como uma releitura, em Go, do wttr.in — aquele projeto que mostra o tempo no terminal via curl. Boa parte dos formatos de saída, do vocabulário de opções e das dezenas de traduções descende desse trabalho, e o original segue sendo a referência. Em cima dessa base eu fui costurando o resto: o menu, as ferramentas, a identidade visual.

Para colocar de pé sem dor, o Hammer roda em contêiner. O serviço web de clima fica atrás de um proxy reverso, com HTTPS resolvido na entrada; o BBS, por ser SSH puro, atende direto na sua própria porta. Duas caras do mesmo programa, no mesmo processo.

Entrar sem burocracia

Um detalhe que me importava: eu queria que entrar fosse fácil como era antigamente. Nada de criar conta, inventar senha, confirmar e-mail. Então o Hammer aceita acesso anônimo — você digita o comando com o usuário guest e já está dentro, sem precisar de nada. Quem prefere, pode se identificar pela própria chave; quem não quer, entra assim mesmo.

E, fiel ao espírito da coisa, as preferências continuam salvas mesmo para quem entra anônimo: escolha uma cidade, ajuste o tema, volte depois — e ele lembra. Para não virar bagunça, há limites gentis: um teto de conexões ao mesmo tempo e um espaço de trabalho que se limpa sozinho de tempos em tempos. Suficiente para brincar à vontade, sem deixar a porta aberta para abuso.

Então...

No fim, o Hammer é exatamente o que eu queria que fosse: um cantinho da internet antiga que ainda respira. Um lugar onde você abre o terminal, ouve — na imaginação — o modem cantar, e encontra um menu em texto esperando por você. Feito com ferramentas de hoje, mas com o coração lá atrás.

Não é um produto. É um hobby que virou software, de código aberto, que continua crescendo uma gaveta de cada vez. E, honestamente, essa é a melhor parte: não ter que ser mais do que isso.

Read more

Pablo Murad pablomurad.com

Não coleto pedras, eu destruo castelos

Figura solitária caminhando, em pixel art preta e branca, representando afastamento emocional

Recentemente, saí de vários grupos do mundo tech dos quais eu fazia parte. No convívio social, eu já havia feito isso há algum tempo. É uma forma de me poupar do peso das emoções e de evitar que aquilo que os outros sentem acabe me contaminando.

Esse afastamento também nasce de algumas posições difíceis que preciso tomar no dia a dia. Para fazer a empresa avançar e conter crises, preciso tomar decisões que nem sempre gostaria de tomar. Falo, especificamente, da posição de CEO.

A maioria das pessoas enxerga apenas o que conquistamos. Poucas veem os caminhos que percorremos e as decisões amargas que tomamos todos os dias, algumas das quais continuam nos assombrando. Também não veem a saúde que perdemos, o estresse e o desgaste acumulado.

Ouvi certa vez uma frase que dizia algo assim:

“Deus não dá uma cruz maior do que você pode carregar.”

Quando penso nela, lembro que há pessoas que parecem atravessar a vida com tanta leveza e problemas tão pequenos que talvez não suportassem cruz alguma. Isso não é problema meu. Ainda assim, não consigo deixar de pensar na paz em que vivem, e confesso que sinto um pouco de inveja.

Mas é a vida. Eu pedi por isso. Eu faço isso.

Read more

Pablo Murad pablomurad.com

Fediverso como funciona e por onde começar

Abra o Mastodon, o Pixelfed e o PeerTube. À primeira vista, parecem três redes separadas: uma para conversas curtas, outra para fotografias e uma terceira para vídeos. No Fediverso, porém, contas hospedadas em serviços diferentes podem se encontrar, seguir e trocar parte de suas publicações. O elo não é uma empresa dona de tudo. É um conjunto de protocolos abertos, servidores independentes e acordos de interoperabilidade.

Uma rede formada por servidores independentes

Essa arquitetura devolve escolhas ao usuário, mas também troca algumas facilidades de uma plataforma central por decisões que antes ficavam escondidas. É preciso escolher onde criar a conta. A moderação varia entre comunidades. A busca não enxerga necessariamente toda a rede. Nem todo recurso funciona do mesmo modo entre programas diferentes.

O objetivo deste guia é tornar essas diferenças compreensíveis sem transformar o Fediverso em uma aula de infraestrutura. No final, você saberá o que é uma instância, como o ActivityPub transporta atividades entre servidores, em que o AT Protocol segue outro caminho e qual é o jeito mais simples de começar.

O que é o Fediverso

Fediverso é a junção de “federação” com “universo”. O nome descreve uma rede social formada por muitos servidores administrados de maneira independente. Cada servidor pode ter seu próprio responsável, regras, público, política de moderação e modelo de financiamento. Mesmo assim, servidores compatíveis conseguem conversar.

A comparação mais útil é o e-mail. Você pode ter uma conta no Proton Mail e enviar uma mensagem para alguém no Outlook porque os provedores adotam protocolos em comum. No Fediverso, alguém em @ana@servidor-a.example pode seguir @bia@servidor-b.example sem que as duas precisem abrir conta no mesmo lugar. O domínio faz parte do endereço porque indica onde aquela identidade está hospedada. A documentação do Mastodon usa exatamente essa estrutura e recomenda compartilhar o nome completo, com usuário e domínio.

A analogia termina aí. Redes sociais precisam representar publicações, respostas, curtidas, compartilhamentos, perfis, grupos, vídeos e controles de visibilidade. Além disso, cada programa interpreta uma parte desse vocabulário. Por isso, interoperabilidade não significa que todas as funções serão idênticas em todos os aplicativos.

No uso atual, Fediverso costuma indicar sobretudo o ecossistema que fala ActivityPub. O termo já foi empregado de modo mais amplo para redes federadas baseadas em outros protocolos, mas este texto adota o sentido mais comum: serviços capazes de trocar atividades sociais pela recomendação do W3C publicada em 2018.

Rede, programa e instância não são a mesma coisa

Três camadas aparecem misturadas em muitas explicações:

·     Fediverso é o ecossistema conectado.

·     ActivityPub é o protocolo que descreve como clientes e servidores publicam e entregam atividades.

·     Mastodon, Pixelfed, PeerTube, Lemmy, BookWyrm e WriteFreely são programas ou serviços com experiências diferentes.

·     Instância é uma instalação de um desses programas em um domínio específico, mantida por uma pessoa ou organização.

Mastodon, portanto, não é o Fediverso inteiro. Ele é a porta de entrada mais conhecida para uma rede que inclui fotografia, vídeo, fóruns, leitura social e blogs.

Como a federação funciona

Imagine duas pessoas. Alice tem conta no servidor A. Bruno tem conta no servidor B. Quando Alice segue Bruno, o servidor A localiza a identidade de Bruno, envia uma atividade de seguimento ao servidor B e aguarda a aceitação. Depois, quando Bruno publica algo para seus seguidores, o servidor B entrega a atividade aos servidores que hospedam esses seguidores. A timeline de Alice exibe uma cópia adequada da publicação.

O ActivityPub organiza essa troca ao redor de “atores”. Um ator pode representar uma pessoa, um grupo, uma aplicação ou outro agente. Cada ator tem uma caixa de entrada (inbox) para receber atividades e uma caixa de saída (outbox) para publicá-las. O protocolo define uma API entre cliente e servidor e outra entre servidores. As mensagens usam ActivityStreams 2.0, um vocabulário em JSON para descrever ações como Create, Follow, Like, Announce, Update e Delete.

Essa escolha tem uma consequência importante: o servidor não precisa ser Mastodon para entender uma atividade básica. O PeerTube, por exemplo, representa canais e vídeos com objetos do ActivityPub, enquanto o Lemmy mapeia comunidades, usuários, posts e comentários para tipos como Group, Person, Page e Note.

O que o protocolo não padroniza por completo

ActivityPub oferece uma base, não uma interface universal. Ele não obriga todos os serviços a exibir a mesma timeline, aplicar o mesmo algoritmo, adotar a mesma política de busca ou implementar toda extensão criada por outra plataforma.

É por isso que uma conta do Mastodon pode seguir um blog do WriteFreely e receber seus artigos na timeline, mas não ganha automaticamente todas as ferramentas de edição daquele blog. Também é possível acompanhar um canal do PeerTube e interagir com um vídeo, enquanto recursos próprios do vídeo permanecem no PeerTube. A compatibilidade costuma ser melhor nas ações comuns, como seguir, publicar, responder, curtir e compartilhar. Recursos específicos podem aparecer de forma parcial ou não aparecer.

Uma conta para conversar com serviços diferentes

O valor do Fediverso aparece quando o formato do conteúdo muda sem romper a rede social.

Se você procura

Serviço conhecido

O que ele acrescenta ao Fediverso

Conversas curtas e perfis pessoais

Mastodon

Microblog, timelines, listas, hashtags e ampla compatibilidade com outros serviços ActivityPub

Fotografias e vídeos curtos

Pixelfed

Álbuns, filtros, comentários e interação com perfis remotos de serviços compatíveis [9]

Vídeos, canais e transmissões

PeerTube

Hospedagem federada de vídeo, canais, comentários e compartilhamento de metadados entre instâncias [10]

Comunidades e discussões por tema

Lemmy

Fóruns com comunidades, posts e comentários federados [11]

Leitura, resenhas e acompanhamento de livros

BookWyrm

Comunidades de leitura que se conectam a outros serviços ActivityPub [12]

Blogs e textos longos

WriteFreely

Blogs que podem ser seguidos a partir de uma conta no Fediverso [13]

Isso não quer dizer que uma conta substitua todos os aplicativos. Se você deseja administrar uma comunidade do Lemmy, publicar um álbum com recursos exclusivos do Pixelfed ou usar o painel completo de um canal do PeerTube, uma conta no serviço correspondente pode ser necessária. A federação evita o isolamento; ela não apaga as diferenças entre produtos.

O servidor que você escolhe importa

Em uma plataforma centralizada, a escolha costuma ser “entrar ou não entrar”. No Fediverso, existe uma escolha adicional: quem hospedará sua conta.

O servidor guarda seu perfil e suas credenciais, monta sua timeline, processa publicações e decide como moderar o conteúdo que recebe. Também determina quais servidores serão limitados ou bloqueados. A lista oficial do Mastodon lembra que cada servidor é operado de forma independente e pode adotar políticas de moderação diferentes.

Essa autonomia permite comunidades ajustadas a idiomas, regiões ou interesses. Ela também significa que duas pessoas usando o mesmo programa podem ter experiências diferentes. Um servidor pequeno talvez ofereça proximidade com a equipe de moderação, mas dependa de poucos voluntários. Um servidor grande tende a ter mais recursos e mais conteúdo já conhecido localmente, porém pode lidar com volume maior de abuso e suporte.

Moderação local com efeitos de rede

Um moderador do servidor A não apaga a conta original hospedada no servidor B. Ele age sobre o que seu próprio servidor armazena e exibe. Se um domínio inteiro se comporta mal, a administração pode limitar ou suspender a federação com ele. No Mastodon, uma suspensão de domínio rejeita o conteúdo daquele servidor e rompe relações de seguimento entre os dois lados. [7]

Isso cria fronteiras comunitárias sem um conselho central para toda a rede. O benefício é distribuir poder. O custo é a fragmentação: uma conta pode ser visível de um servidor e bloqueada em outro; uma conversa pode chegar incompleta; regras e recursos de apelação variam.

Federação não é sinônimo de privacidade

Descentralizar o controle não torna uma publicação secreta. Conteúdo público pode ser copiado para outros servidores, indexado e armazenado por terceiros. Mesmo quando uma atividade de exclusão é enviada, não existe garantia técnica de que toda cópia externa será removida.

No Mastodon, “menções privadas” são publicações entregues apenas às contas mencionadas. Elas não têm criptografia de ponta a ponta. A própria documentação alerta que administradores dos servidores de origem e destino podem acessar o texto. Para informações sensíveis, use uma ferramenta criada para mensagens criptografadas, como Signal ou Matrix, e não a caixa de menções privadas de uma rede social.

Escolher uma instância é, portanto, também escolher um custodiante. Leia a política de privacidade, verifique quem administra o serviço e desconfie de promessas vagas de segurança. O Fediverso distribui confiança entre operadores; ele não elimina a necessidade de confiar em alguém.

O que acontece quando você muda de servidor

No Mastodon, é possível criar uma nova conta, declarar uma relação entre os dois perfis e pedir ao servidor antigo que encaminhe os seguidores para o novo endereço. Listas de pessoas seguidas, bloqueios e silenciamentos podem ser exportadas e importadas. Os seguidores são avisados e passam gradualmente a seguir a nova conta.

Mudar de servidor preserva partes diferentes da conta em cada protocolo

Essa migração é útil, mas não equivale a transportar a conta inteira. No modelo do Mastodon, o novo perfil tem outro endereço. Publicações antigas permanecem associadas ao servidor anterior, e o processo não transfere todo o histórico como se o banco de dados tivesse mudado de provedor. O comando Move e a relação alsoKnownAs são implementados pelo Mastodon sobre a federação do ActivityPub.

É nesse ponto que a comparação com o AT Protocol fica mais interessante.

Fediverso e AT Protocol

ActivityPub e AT Protocol tentam reduzir a dependência de uma plataforma única, mas partem de perguntas diferentes.

ActivityPub pergunta: como atores em servidores diferentes entregam atividades sociais uns aos outros?

AT Protocol pergunta: como separar identidade, dados, indexação, aplicativo, algoritmo e moderação para que essas peças possam ser substituídas?

Bluesky é um aplicativo construído sobre o AT Protocol. Do mesmo modo que Mastodon não resume o Fediverso, Bluesky não é todo o protocolo. A documentação do AT Protocol chama o ecossistema de “Atmosphere” e descreve componentes com funções próprias. [15]

A arquitetura do ActivityPub

No arranjo mais comum do Fediverso, cada instância reúne muitas responsabilidades. Ela hospeda contas, recebe e envia atividades, guarda conteúdo, monta timelines e aplica suas regras. A rede cresce pela comunicação direta entre servidores. Não há uma cópia global obrigatória de tudo. Um servidor conhece o conteúdo que recebeu por relações de seguimento, buscas, compartilhamentos e outras interações. A documentação do Mastodon explica que não existe um estado público global e que a timeline de outros servidores mostra apenas o que a instância já conhece.

A arquitetura do AT Protocol

No AT Protocol, a identidade está ligada a um identificador permanente, o DID. Um nome legível, chamado handle, pode usar um domínio, mas não é a âncora criptográfica da conta. O conteúdo público de cada pessoa fica em um repositório verificável hospedado por um Personal Data Server, ou PDS.

Relays agregam mudanças publicadas por muitos PDSs e fornecem um fluxo para serviços seguintes. AppViews indexam esses dados e montam a experiência do aplicativo, como perfis, conversas, contagens e feeds. Geradores de feed podem oferecer algoritmos diferentes. Serviços de rotulagem aplicam metadados de moderação, que os aplicativos e usuários interpretam conforme suas escolhas.

O resultado é uma federação orientada a uma visão ampla da rede. O servidor que hospeda seus dados não precisa definir sozinho tudo o que você vê. Essa separação favorece descoberta global, feeds substituíveis e portabilidade de identidade, mas também cria componentes de infraestrutura grandes. A própria descrição arquitetural do projeto observa que um relay de rede inteira consome muitos recursos e prevê poucos operadores de grande porte ao lado de relays menores ou parciais.

Comparação prática entre ActivityPub e AT Protocol

Aspecto

ActivityPub no Fediverso

AT Protocol

Unidade principal

Atores trocam atividades por caixas de entrada e saída

Cada conta publica registros em um repositório verificável

Identidade

Normalmente uma URL e um endereço ligados ao domínio do servidor

DID permanente separado do handle legível e do PDS

Hospedagem

A instância costuma reunir conta, aplicação, timeline e moderação

O PDS hospeda conta e dados; Relay, AppView, feeds e labelers cumprem outras funções

Distribuição

Servidores entregam atividades diretamente a outros servidores

PDSs publicam mudanças que podem ser agregadas por Relays e consumidas por AppViews

Descoberta

Depende do que a instância conhece; não existe visão global obrigatória

A arquitetura favorece indexação ampla e feeds que atravessam provedores

Moderação

Regras locais, ações sobre contas e cópias remotas, bloqueios entre domínios

Takedowns de rede, rótulos de serviços de moderação e controles do usuário podem ser combinados [18]

Mudança de provedor

Aplicações como Mastodon movem seguidores, mas o endereço muda e o histórico não acompanha por completo

O DID e o repositório foram desenhados para migrar entre PDSs; as ferramentas e mecanismos ainda podem evoluir [20]

Interoperabilidade

Muitos programas sociais distintos compartilham um vocabulário básico

Aplicações compartilham dados e esquemas chamados Lexicons, com serviços especializados

Ponto forte

Diversidade de comunidades e aplicações que conversam sem uma autoridade central

Separação entre identidade, dados, indexação, feeds e moderação

Principal atrito

Recursos parciais entre programas, descoberta fragmentada e dependência do operador local

Infraestrutura de agregação mais pesada e ecossistema prático ainda concentrado em poucos serviços amplos

 Nenhuma coluna é uma nota final. O Fediverso pode ser excelente para comunidades autônomas e para conectar formatos diferentes. O AT Protocol pode oferecer uma portabilidade mais profunda e uma conversa global mais uniforme. Os dois modelos continuam dependendo de software, operadores, governança e recursos financeiros. “Aberto” descreve possibilidades e direitos técnicos; não garante que a distribuição de poder já seja equilibrada na prática.

Eles conversam entre si

Não de forma nativa. ActivityPub e AT Protocol usam identidades, formatos de dados e fluxos de distribuição diferentes. Pontes de terceiros podem traduzir parte das ações, mas introduzem outra entidade no caminho e não transformam os dois sistemas em uma rede única. Se você depende de uma ponte, verifique quem a opera, quais dados ela replica, quais recursos suporta e como funciona a remoção de conteúdo.

Por onde começar no Fediverso

Para a maioria das pessoas, a entrada mais simples é o Mastodon. Ele ajuda a aprender endereço federado, instância, timeline e moderação sem exigir que você administre um servidor. Depois, a mesma conta pode encontrar perfis e conteúdos de outros serviços compatíveis.

Escolher uma instância é escolher a casa da sua conta

Passo 1 escolha o tipo de experiência

Comece pelo que pretende fazer, não pelo protocolo.

·     Conversar e acompanhar pessoas: Mastodon.

·     Publicar fotografia: Pixelfed.

·     Ver ou hospedar vídeos: PeerTube.

·     Participar de comunidades temáticas: Lemmy.

·     Registrar leituras e resenhas: BookWyrm.

·     Publicar um blog que possa ser seguido no Fediverso: WriteFreely.

Você pode abrir uma conta no serviço que mais combina com seu uso e acompanhar perfis de outros programas quando houver compatibilidade. Se uma função específica não atravessar a federação, abra a publicação original no serviço de origem.

Passo 2 escolha uma instância com critérios concretos

Na lista de servidores do Mastodon, filtre por idioma, região, tema e modo de inscrição. Antes de se cadastrar, abra a página “Sobre” da instância e confira:

1. Regras e moderação: as normas são claras? Há política contra assédio? A equipe explica como trata denúncias e recursos?

2. Responsáveis: existe uma pessoa ou organização identificável e um canal de contato?

3. Sustentação: o serviço explica como paga hospedagem e manutenção? Há doações, associação ou orçamento institucional?

4. Continuidade: há sinais de atualizações, backups e avisos aos usuários? Uma instância abandonada é um risco mesmo que esteja funcionando hoje.

5. Privacidade: a política informa quais dados são coletados, por quanto tempo ficam armazenados e em qual jurisdição?

6. Tamanho e comunidade: o ambiente local combina com você? Prefere uma comunidade pequena ou um servidor generalista?

7. Federação: a instância publica regras sobre domínios limitados ou bloqueados? Isso pode alterar quem você encontra.

Não procure a instância “perfeita”. Procure uma administração que pareça competente, previsível e compatível com suas necessidades. Se a escolha deixar de servir, planeje a mudança enquanto o servidor antigo ainda está acessível.

Passo 3 monte um perfil encontrável

Use uma foto ou avatar reconhecível, escreva uma bio curta e informe temas sobre os quais pretende publicar. Compartilhe o endereço completo, como @nome@servidor.example. Se você possui um site, adicione o link ao perfil e use os recursos de verificação oferecidos pelo serviço.

Um perfil vazio tende a parecer automatizado ou provisório. Uma apresentação simples ajuda pessoas de outras instâncias a decidir se querem seguir você.

Passo 4 construa a timeline

Em muitas experiências do Fediverso, a timeline melhora quando você escolhe ativamente quem acompanhar.

·     Siga primeiro pessoas, projetos e publicações que você já conhece.

·     Procure hashtags relacionadas a seus interesses.

·     Explore os feeds local e federado com a consciência de que eles refletem o que seu servidor conhece.

·     Ao encontrar um perfil remoto fora de sua instância, copie a URL completa e cole na busca do seu próprio servidor. O Mastodon usa esse processo para buscar e importar o perfil ou a publicação.

·     Observe quem é compartilhado por contas de confiança.

Dez bons perfis valem mais que centenas escolhidos ao acaso. Dê alguns dias para a timeline ganhar forma.

Passo 5 publique de maneira federável

Escreva pensando em pessoas que usarão interfaces diferentes. Prefira links completos, use hashtags úteis sem exagero e adicione texto alternativo às imagens. Marque mídia sensível e use avisos de conteúdo quando o contexto pedir. Esses cuidados não são cerimônia: ajudam acessibilidade, descoberta e convivência entre comunidades.

Lembre que a visibilidade é definida por publicação. Uma postagem pública pode viajar e ser copiada. Uma postagem para seguidores reduz a entrega, mas continua passando pelos servidores envolvidos. Menção privada não é mensagem criptografada.

Passo 6 aprenda três controles de segurança

Antes de precisar deles, descubra onde ficam:

·     silenciar uma conta sem notificá-la;

·     bloquear uma conta ou um domínio;

·     denunciar uma publicação e decidir se o relatório também deve seguir para a moderação do servidor remoto.

No Fediverso, a equipe da sua instância é sua primeira referência. Um relatório pode envolver também a administração de onde veio a conta denunciada, mas cada lado conserva sua própria autoridade.

Passo 7 prepare uma saída

Exporte periodicamente as listas que o serviço permite baixar. Guarde o endereço de contato da administração e saiba onde fica a opção de migração. Se um encerramento for anunciado, não deixe a mudança para o último dia: transferir seguidores depende de o servidor antigo ainda conseguir assinar e entregar as atividades necessárias.

Vale a pena hospedar sua própria instância

Autohospedagem oferece domínio próprio, controle de políticas e independência de um provedor. Também transforma você em operador de um serviço social conectado a desconhecidos.

Uma instância pública exige atualizações de segurança, banco de dados, armazenamento de mídia, entrega de e-mail, filas de trabalhos, monitoramento, backups externos e resposta a abuso. A documentação do Mastodon coloca PostgreSQL, segredos da aplicação, arquivos enviados e Redis na estratégia de backup e alerta que perder o banco elimina contas, publicações e seguidores locais.

Para uma pessoa só ou um grupo pequeno, a operação é mais administrável, mas não desaparece. Comece como usuário em uma instância bem mantida. Hospede a sua quando tiver um motivo claro, uma rotina de atualização e recuperação testada, e disposição para lidar com federação e moderação.

No AT Protocol, hospedar um PDS tem outro alcance. O PDS guarda a conta e o repositório, mas a experiência completa de um aplicativo como o Bluesky também depende de relay, AppView, feeds e moderação. Rodar o PDS não equivale a operar sozinho uma cópia de toda a rede.

Dúvidas rápidas

Preciso de uma conta em cada servidor

Não para seguir e interagir com atividades compatíveis. Uma conta basta para circular pela rede que sua instância alcança. Você pode querer outra conta quando precisar de ferramentas exclusivas de um serviço ou separar identidades.

Todo mundo vê a mesma timeline

Não. A timeline inicial depende das contas seguidas, das políticas e do conteúdo conhecido pelo servidor, além dos recursos do aplicativo. Não existe uma timeline pública global obrigatória no ActivityPub.

Posso levar meus seguidores se mudar

Em programas como Mastodon, sim, desde que o processo seja iniciado corretamente e o servidor antigo ainda funcione. Perfil, listas e seguidores têm caminhos de migração, mas publicações antigas não se transformam automaticamente em histórico nativo da nova conta.

Fediverso é mais seguro

Ele pode reduzir a dependência de uma empresa e permitir comunidades com regras melhores, mas segurança depende da implementação e da administração. Atualizações, backups, política de acesso, resposta a abuso e escolha do servidor continuam essenciais.

Bluesky faz parte do Fediverso

Bluesky é federado pelo AT Protocol, não pelo ActivityPub. Em um uso amplo e histórico da palavra, algumas pessoas agrupam várias redes federadas sob o rótulo Fediverso. No sentido prático adotado neste guia, são ecossistemas diferentes e não interoperam nativamente.

Um primeiro dia sem complicação

Se você quer apenas experimentar, reserve meia hora:

1. Entre na lista oficial de servidores do Mastodon e escolha uma instância generalista em um idioma que você lê.

2. Leia as regras e identifique quem mantém o serviço.

3. Crie a conta, complete a bio e compartilhe seu endereço com domínio.

4. Siga dez perfis e duas ou três hashtags.

5. Publique uma apresentação curta com os assuntos que você acompanha.

6. Adicione texto alternativo se usar imagem.

7. Localize as opções de silenciar, bloquear, denunciar e exportar dados.

Não é preciso entender inbox, DID ou Relay para conversar. Esses conceitos servem para você avaliar promessas, escolher provedores e reconhecer limites. A melhor introdução ao Fediverso ainda é usá-lo como uma rede de pessoas: entrar em uma comunidade, seguir alguém de fora dela e perceber que os dois servidores fizeram o trabalho sem pedir permissão a uma plataforma central.

E para terminar...

O Fediverso substitui a ideia de uma rede social única por uma rede de comunidades e programas interoperáveis. O ActivityPub fornece a linguagem comum. Mastodon, Pixelfed, PeerTube, Lemmy, BookWyrm e WriteFreely transformam essa linguagem em experiências diferentes.

O AT Protocol reorganiza o mesmo problema. Em vez de concentrar a experiência na instância, separa identidade, repositório, hospedagem, agregação, aplicativo, feeds e moderação. Essa arquitetura dá mais destaque à portabilidade e à visão global, enquanto o ActivityPub favorece a comunicação direta entre comunidades autônomas.

Comece pela experiência que deseja, escolha com cuidado quem hospedará sua conta e trate federação como distribuição, não como promessa automática de privacidade. Depois disso, o resto deixa de parecer uma coleção de siglas. Torna-se uma escolha concreta sobre quem opera sua vida social online e quais saídas permanecem abertas.

Read more

Pablo Murad pablomurad.com

Como publicar um site em ip6 arpa

A ideia é curiosa: usar a zona reversa de um prefixo IPv6 como endereço público para um site. Funciona, ensina bastante sobre DNS e custa zero, mas não substitui um domínio comum. Neste guia eu mostro o caminho completo, as limitações e os cuidados que evitam os atalhos problemáticos do tutorial que inspirou esta adaptação.

Baseado no artigo de Ethan Hawksley: How to get a free .arpa domain

O que estamos fazendo de verdade

O endereço final parece um domínio dentro de .arpa, mas eu não o registro em um cartório de domínios. A Hurricane Electric me atribui um prefixo IPv6 e delega a zona reversa correspondente. Enquanto essa atribuição existir, eu posso administrar registros DNS abaixo dela e criar um host como site.<zona>.ip6.arpa.

A IANA reserva .arpa para a infraestrutura da Internet. A subárvore ip6.arpa existe para transformar endereços IPv6 em nomes, por meio do DNS reverso. A RFC 3596 também admite outros usos nessa árvore; é essa margem técnica que torna o experimento possível.

Resumo honesto. É um laboratório de DNS, não um endereço curto, permanente ou indicado para produção. O nome depende do túnel, da delegação reversa, do deSEC e do serviço de hospedagem.

O que você precisa

·         Um IPv4 público sob seu controle, com resposta a ICMP liberada para a validação do Tunnel Broker.

·         Uma rede que permita configurar e usar o túnel IPv6 da Hurricane Electric de forma legítima.

·         Contas gratuitas no Hurricane Electric Tunnel Broker, no deSEC e no Surge.

·         Node.js 18 ou superior, ou Bun, além de um terminal.

·         Um site estático simples, ainda que seja apenas um arquivo index.html.

Importante. Use dados verdadeiros no cadastro e um IPv4 que pertença a você ou que você esteja autorizado a operar. Os termos da Hurricane Electric exigem informações corretas e proíbem falsificação. Além da questão contratual, um endpoint alheio pode desaparecer ou mudar sem aviso.

Como ler o nome ip6 arpa

No IPv6, cada bloco separado por dois-pontos é um hexteto. Para montar o nome reverso, eu completo os hextetos com zeros, separo cada dígito hexadecimal — chamado nibble — e inverto a ordem.

Etapa

Resultado

Prefixo recebido

2001:470:1f09:140::/64

Completar zeros

2001:0470:1f09:0140

Separar os nibbles

2.0.0.1.0.4.7.0.1.f.0.9.0.1.4.0

Inverter e acrescentar

0.4.1.0.9.0.f.1.0.7.4.0.1.0.0.2.ip6.arpa


1 Criar e configurar o túnel IPv6

Eu começo em tunnelbroker.net, crio uma conta com dados reais e confirmo o endereço de e-mail. No painel, escolho Create Regular Tunnel.

Página inicial do Hurricane Electric Tunnel Broker.

Página inicial do Hurricane Electric Tunnel Broker. Captura de tela: Ethan Hawksley, hawksley.dev.

No menu lateral, a opção Create Regular Tunnel inicia o cadastro.

No menu lateral, a opção Create Regular Tunnel inicia o cadastro. Captura de tela: Ethan Hawksley, hawksley.dev.

No campo IPv4 Endpoint, informo o endereço público da minha própria conexão ou servidor. Ele precisa responder a ping no momento da validação. Escolho um servidor de túnel próximo e confirmo antes se ele está operacional na página de status da Hurricane Electric. Para um túnel usado de verdade, distância e rota afetam latência e estabilidade.

Exemplo do campo de endpoint IPv4 aceito pelo formulário. Use somente um endereço sob seu controle.

Exemplo do campo de endpoint IPv4 aceito pelo formulário. Use somente um endereço sob seu controle. Captura de tela: Ethan Hawksley, hawksley.dev.

2 Encontrar o prefixo roteado

Depois de criar o túnel, abro Tunnel Details e procuro Routed IPv6 Prefixes. O que me interessa para este guia é o Routed /64, não o endereço do servidor nem o Client IPv6 Address.

O prefixo /64 roteado aparece nos detalhes do túnel.

O prefixo /64 roteado aparece nos detalhes do túnel. Captura de tela: Ethan Hawksley, hawksley.dev.

No exemplo do artigo, o prefixo é 2001:470:1f09:140::/64. Eu uso apenas os primeiros 64 bits: 2001:470:1f09:140. A transformação completa é a mostrada na tabela anterior.

3 Criar a zona no deSEC

Crio uma conta no deSEC e, durante o cadastro ou no painel, escolho a opção de configurar um domínio próprio. Informo a zona ip6.arpa calculada, sem acrescentar o subdomínio do site nesta etapa.

Cadastro da zona reversa no deSEC.

Cadastro da zona reversa no deSEC. Captura de tela: Ethan Hawksley, hawksley.dev.

Guardo os servidores DNS apresentados pelo deSEC. Em geral, serão ns1.desec.io e ns2.desec.org, mas confiro os valores mostrados na minha conta antes de continuar.

4 Delegar o DNS reverso

Volto ao Tunnel Broker, abro a área de rDNS Delegations do túnel e informo os nameservers do deSEC. Essa delegação faz com que consultas à minha subárvore ip6.arpa cheguem à zona que acabei de criar.

Delegação do rDNS para os servidores do deSEC.

Delegação do rDNS para os servidores do deSEC. Captura de tela: Ethan Hawksley, hawksley.dev.

A delegação pode levar algum tempo para aparecer. Antes de publicar o site, verifico se os servidores autoritativos já respondem:

Resolve-DnsName -Type NS 0.4.1.0.9.0.f.1.0.7.4.0.1.0.0.2.ip6.arpa

Troque a zona do exemplo pela sua. Se o resultado ainda não mostrar o deSEC, aguarde o TTL e tente novamente.


5 Publicar o site no Surge

Em uma pasta nova, crio um index.html. Para testar, basta um conteúdo pequeno:

<!doctype html>
<html lang="pt-BR">
  <meta charset="utf-8">
  <title>Meu laboratório ip6.arpa</title>
  <h1>Funcionou</h1>
  <p>Este site está publicado em uma zona reversa IPv6.</p>
</html>

Dentro da pasta, publico escolhendo um host abaixo da zona. Eu uso site no exemplo porque um CNAME não pode ocupar o ápice da zona, onde já existem registros NS e SOA.

npx surge . site.0.4.1.0.9.0.f.1.0.7.4.0.1.0.0.2.ip6.arpa

Também posso usar bunx surge com a mesma sintaxe. Se for a primeira execução, o Surge pede a criação de uma conta gratuita. No final, anoto o destino informado pelo serviço.

Resposta do Surge depois da publicação.

Resposta do Surge depois da publicação. Captura de tela: Ethan Hawksley, hawksley.dev.

6 Criar o CNAME no deSEC

Na zona do deSEC, crio um registro CNAME. Em Subname, uso apenas site — ou o nome escolhido no comando do Surge. Como destino, uso o host indicado pelo Surge. A documentação atual recomenda geo.surge.sh para domínios personalizados; se o terminal fornecer outro alvo, sigo o valor exibido por ele.

Criação do CNAME no painel do deSEC.

Criação do CNAME no painel do deSEC. Captura de tela: Ethan Hawksley, hawksley.dev.

7 Conferir o DNS e abrir o site

Eu testo em camadas. Primeiro confirmo a delegação NS. Depois verifico o CNAME do host. Por fim, testo a resposta HTTP.

Resolve-DnsName -Type NS <sua-zona>.ip6.arpa
Resolve-DnsName -Type CNAME site.<sua-zona>.ip6.arpa
curl.exe -I http://site.<sua-zona>.ip6.arpa

Se o nome não resolver, pode haver um NXDOMAIN no cache local. Eu aguardo o TTL, limpo o cache DNS do Windows com ipconfig /flushdns e tento novamente. Também verifico se a delegação usa exatamente os nameservers do deSEC, se o CNAME foi criado no subdomínio correto e se o domínio aparece no painel do Surge.

A limitação decisiva do HTTPS

Este endereço deve ser tratado como HTTP. Desde 15 de março de 2026, os requisitos do CA Browser Forum proíbem autoridades certificadoras públicas de emitir certificados para nomes terminados em zonas reversas de IP, incluindo ip6.arpa. Portanto, não conte com um certificado TLS reconhecido normalmente pelos navegadores.

Consequência prática. Não publique senhas, formulários, dados pessoais nem qualquer conteúdo sensível. Uma autoridade certificadora privada pode servir em um laboratório controlado, mas seus dispositivos precisam confiar nela manualmente.

Problemas comuns

Sintoma

O que conferir

O Tunnel Broker rejeita o endpoint

Confirme que o IPv4 é público, está sob seu controle e responde a ICMP. CGNAT costuma impedir esse cenário.

A zona não aparece no deSEC

Revise a sequência dos nibbles. Todos os dígitos precisam estar separados por pontos e em ordem inversa.

O NS ainda aponta para outro lugar

Aguarde a delegação e confira se os dois nameservers foram salvos no Tunnel Broker.

O CNAME não resolve

Crie o registro em um subdomínio como site. Não tente usar CNAME no ápice da zona.

O navegador insiste em HTTPS

Digite http:// explicitamente. Alguns navegadores ou políticas locais podem forçar HTTPS e impedir o acesso.

O site some depois

Confira se o túnel e o prefixo continuam ativos e se as contas de deSEC e Surge permanecem válidas.

Vale a pena

Eu usaria esse endereço para aprender e demonstrar como IPv6, DNS reverso e delegação se encaixam. Para um projeto que precisa permanecer no ar, eu escolheria um domínio registrável e HTTPS público. Aqui, o valor está no caminho: sair de um prefixo IPv6, administrar sua zona reversa e terminar com um site acessível pelo navegador.

A URL é longa, a cadeia depende de vários serviços e a atribuição pode terminar junto com o túnel. Essas limitações não anulam o experimento; apenas definem o lugar certo para ele.

Fontes e leitura complementar

·         Tutorial original e imagens

·         IANA sobre o domínio arpa

·         RFC 3596 e o formato ip6 arpa

·         Hurricane Electric Tunnel Broker

·         Termos do Tunnel Broker

·         Documentação de registros do deSEC

·         Domínios personalizados no Surge

·         Requisitos do CA Browser Forum

Créditos. A ideia, o fluxo original e as capturas de tela são de Ethan Hawksley. A adaptação textual foi ampliada e atualizada em português com atribuição ao artigo original. O repositório do autor licencia textos e documentação em CC BY 4.0; as capturas são reproduzidas aqui com atribuição ao autor e à página de origem.

Read more

Pablo Murad pablomurad.com

AT Protocol sem mistério

Quando alguém conhece o AT Protocol pelo Bluesky, é fácil concluir que se trata apenas de uma infraestrutura aberta para fazer redes parecidas com o Twitter. Essa é a porta de entrada, mas não o edifício inteiro. O protocolo separa coisas que as plataformas tradicionais empacotaram dentro de uma única empresa: identidade, hospedagem, dados, descoberta, interface, algoritmos e moderação.

Essa separação abre espaço para clientes sociais, publicações longas, música, meteorologia, rastreamento de voos, check-ins, colaboração em código e outros produtos que compartilham identidades e formatos de dados sem pertencer ao mesmo aplicativo.

Este guia nasceu da curadoria Essential Resources for Getting Started with AT Protocol, de Tierney Cyren, mas vai além da lista original. A ideia é construir um mapa: primeiro o modelo mental, depois as peças técnicas, as ferramentas para explorá-las e, por fim, uma trilha prática para começar. O retrato de projetos e estágios de desenvolvimento foi verificado em 8 de setembro de 2026.

Antes de tudo AT Protocol não é Bluesky

O AT Protocol é um protocolo descentralizado e um conjunto aberto de componentes para construir aplicações sociais em grande escala. O Bluesky é uma aplicação feita sobre ele. A distinção parece semântica, mas muda tudo.

Em uma plataforma convencional, a empresa mantém sua conta, armazena suas publicações, escolhe o algoritmo, fornece o aplicativo e determina as regras de moderação. Sair costuma significar abandonar quase tudo. No AT Protocol, essas funções podem ser prestadas por serviços diferentes. Uma identidade pode entrar em mais de um aplicativo; um aplicativo pode ler dados publicados por outro; a hospedagem pode mudar sem que a identidade precise ser recriada.

Isso não elimina dependências nem garante uma descentralização perfeita. Significa que o desenho do sistema cria pontos de substituição. Para uma visão oficial e direta, comece pelo Protocol Overview, pelo guia Understanding Atproto e pela descrição da pilha do protocolo.

O modelo mental certo arquivos separados dos aplicativos

Dois ensaios de Dan Abramov ajudam a enxergar a arquitetura sem começar por siglas. A Social Filesystem propõe pensar nos dados sociais como arquivos estruturados que diferentes programas conseguem interpretar. There Are No Instances in atproto usa uma comparação ainda mais familiar: blogs, RSS e leitores de feeds.

Um texto de blog vive em uma hospedagem. Um leitor como o antigo Google Reader agrega textos de muitos lugares e oferece uma interface. Trocar de leitor não move os artigos; trocar a hospedagem não obriga todo mundo a usar uma nova interface. O AT Protocol recupera essa separação para dados sociais mais ricos.

Por isso, procurar as "instâncias do Bluesky" pode levar à conclusão errada. Um PDS não é uma pequena cópia completa do Bluesky. Ele hospeda contas e dados. A agregação, a busca, o algoritmo e a interface podem estar em outros serviços.

Os ensaios de Abramov são leituras independentes, não especificações. Use-os para formar a intuição e confirme os detalhes na documentação oficial.

Da identidade ao registro DID, handle, PDS e repositório

Toda conta tem um DID, um identificador descentralizado e estável. O handle é o nome legível, normalmente semelhante a um domínio. O handle pode mudar; o DID é a âncora usada por sistemas para reconhecer aquela identidade.

Quando um aplicativo recebe um handle, ele o resolve para um DID. O documento DID informa chaves criptográficas e serviços ligados à conta, inclusive onde está seu PDS. Essa camada permite descobrir a hospedagem atual sem transformar o endereço do servidor na identidade da pessoa. O guia oficial sobre identidade mostra o processo, enquanto Account Management e Account Migration explicam gestão e migração.

O Personal Data Server, ou PDS, é a casa da conta na nuvem. Ele hospeda o repositório, distribui dados, participa da autenticação e ajuda a administrar a identidade. Há uma implementação oficial de PDS, com contêineres e documentação para autohospedagem. O guia de self-hosting mostra, porém, que instalar um servidor é apenas o começo: DNS, TLS, e-mail, armazenamento, atualizações, backups e disponibilidade passam a ser responsabilidade do operador.

Dentro do PDS, os dados públicos da conta ficam em um repositório pessoal. Ele é uma estrutura assinada: cada alteração produz um novo estado verificável. Os registros são organizados em coleções. Um endereço como at://alice.com/app.bsky.feed.post/1234 aponta para uma identidade, uma coleção e uma chave de registro. A documentação de Personal Data Repositories, Reads and Writes e Reading Data desenvolve esses conceitos.

Convém moderar a frase "o usuário possui os dados". A arquitetura oferece dados assinados, identidade portátil e sincronização independente. Isso não resolve sozinho posse jurídica, privacidade, recuperação ou disponibilidade. Conteúdo público pode ser copiado; apagar o original não recolhe automaticamente réplicas feitas por terceiros. Blobs, chaves e informações fora do protocolo também exigem uma estratégia própria.

Como os dados circulam Relay e AppView

Quando uma conta escreve em seu repositório, essa mudança precisa chegar a quem constrói experiências sobre a rede. Relays coletam eventos de muitos PDSes e oferecem um fluxo agregado. Em vez de cada aplicativo manter conexões com todos os servidores, ele pode sincronizar a partir de um relay.

O AppView faz outro trabalho: indexa e combina registros para responder perguntas de aplicação. Quantas curtidas um post recebeu? Qual é a thread completa? Quem segue quem? O que aparece na busca? O repositório guarda registros; o AppView produz uma visão consultável deles.

Isso explica por que um AppView costuma ser uma das partes mais trabalhosas de um produto AT Protocol. O HappyView, citado na postagem original, é um projeto comunitário que tenta simplificar implantação, ingestão e consultas. Ele pode ser um atalho valioso, mas não é um componente oficial nem serve necessariamente para todo produto.

O mesmo cuidado vale para o Tranquil PDS, uma implementação comunitária alternativa. Para aprender a operação e comparar escolhas, use como referência o PDS oficial e trate recomendações informais como ponto de partida, não como auditoria.

Para consumir eventos, existe o firehose canônico definido pela especificação de sincronização. Ele preserva os formatos necessários para verificar e reconstruir repositórios, mas cobra uma curva de aprendizado. O Jetstream oferece uma entrada mais amigável, em JSON e com filtros. Em 2026, o Jetstream v2 é descrito como arquivo integral e fluxo ao vivo da rede, mantendo compatibilidade com o formato simplificado anterior. Para protótipos e análises, é uma excelente primeira etapa. Para verificação criptográfica completa, ainda é necessário entender o fluxo canônico.

Lexicons o vocabulário comum

Se os aplicativos podem ser diferentes, como eles entendem os mesmos dados? Por meio dos Lexicons. Lexicon é a linguagem de esquema usada para definir registros, métodos de API XRPC e mensagens de fluxo. Ela lembra JSON Schema e OpenAPI, com regras específicas do AT Protocol.

Cada esquema recebe um NSID em formato de domínio invertido. app.bsky.feed.post descreve um post do ecossistema Bluesky; app.bsky.graph.follow, uma relação de seguir. Os esquemas com.atproto.* cobrem primitivas do protocolo. Você pode estudar o guia de Lexicons, a especificação, o processo de publicação e o guia de estilo.

O Standard.site mostra por que isso importa. Trata-se de um conjunto comunitário de esquemas para conteúdo longo. Um escritor pode publicar em uma ferramenta e o leitor consumir o artigo em outra, desde que ambas implementem o formato de maneira compatível. Isso é interoperabilidade no nível dos dados, e não apenas um link abrindo outra página.

Mas um esquema não cria adoção por decreto. Ele define estrutura e semântica; a interoperabilidade surge quando diferentes produtores e consumidores implementam o acordo. standard.site é um sinal relevante de coordenação comunitária, não um padrão oficial do protocolo.

Spaces a fronteira dos dados não públicos

O AT Protocol nasceu fortemente orientado a dados públicos. Isso funciona para posts, artigos e perfis, mas não atende grupos privados, amigos próximos, documentos compartilhados, assinaturas ou comunidades restritas. Atproto Spaces tenta preencher essa lacuna.

Spaces oferece uma fronteira de permissão para armazenar e sincronizar dados não públicos sem abandonar identidade portátil e interoperabilidade. Cada espaço pode reunir participantes e regras de acesso. O texto Reintroducing Spaces, de Daniel Holmgren, ajuda a imaginar o que essa primitiva permite.

O potencial é amplo: um "Dropbox da Atmosphere", círculos privados, cursos, arquivos pagos e comunidades acessíveis por identidade. Há também consequências econômicas discutidas em Let's Talk Money: criação, descoberta, leitura e pagamento poderiam acontecer em serviços distintos.

O aviso mais importante: Spaces entrou em alpha em 20 de agosto de 2026. APIs e garantias podem mudar. Não trate a tecnologia como infraestrutura madura para dados sensíveis. "Não público" também não é sinônimo automático de criptografia ponta a ponta. Antes de guardar segredos, avalie modelo de ameaças, operadores com acesso e propriedades concretas da implementação.

Uma caixa de ferramentas para explorar a rede

Você não precisa montar toda a pilha para aprender. Alguns exploradores permitem abrir uma conta e enxergar o que normalmente fica escondido pela interface:

·     pds.ls exibe identidades, PDSes, coleções, registros e ferramentas relacionadas a fluxos, Spaces e labelers.

·     Taproot, em atproto.at, oferece outra interface visual para investigar registros e componentes.

·     atproto.md representa registros como Markdown sem exigir autenticação.

·     microcosm.blue reúne APIs e blocos comunitários para construir sobre dados da Atmosphere.

·     ATStore funciona como diretório de aplicativos AT Protocol.

Uma experiência didática simples é abrir o mesmo registro em mais de um explorador. O conteúdo permanece reconhecível; o que muda é a projeção. Esse exercício torna concreta a separação entre dado e interface.

Para programar, priorize as fontes oficiais: a documentação da API Bluesky, os tutoriais, o Cookbook, a implementação TypeScript e o Indigo, em Go. O utilitário goat ajuda a inspecionar identidade, conta, repositórios e Lexicons. Para TypeScript, `@atproto/api` oferece o cliente conhecido do ecossistema, enquanto `@atproto/lex` trabalha com clientes tipados e geração baseada em Lexicons.

No Windows, vale um cuidado: os tutoriais oficiais registravam, nesta data, um problema de DNS do Node.js capaz de afetar a resolução usada por lex. WSL é a rota recomendada nesses roteiros enquanto a limitação persistir.

OAuth e moderação não são detalhes finais

Uma aplicação nova deve adotar OAuth. No AT Protocol, o app descobre o PDS da pessoa e conduz a autorização com aquele servidor. Os SDKs cuidam de detalhes como DPoP, renovação de tokens e sessões. O guia About OAuth, os padrões de implementação, o tutorial com Next.js e o Scope Builder formam uma boa sequência.

Peça apenas as permissões necessárias. Senhas de aplicativo ainda aparecem em exemplos e automações antigas, mas não devem ser o fluxo principal de um produto para usuários. Nunca peça a senha principal da conta.

Moderação também faz parte da arquitetura. Ela combina retiradas na infraestrutura, rótulos emitidos por serviços e controles pessoais como bloqueios e silenciamentos. Labelers podem criar taxonomias; clientes decidem como aplicar os rótulos conforme regras e preferências. Leia Moderation, Labels, Subscriptions e o tutorial de rótulos.

Um cliente que ignora rótulos, bloqueios, silenciamentos e denúncias não é neutro; ele apenas transfere o custo do abuso para quem o utiliza.

O que já estão construindo

A melhor maneira de abandonar a ideia de "mais um clone do Twitter" é observar a diversidade atual:

·     BeaconBits explora check-ins de lugares.

·     atmowx publica e visualiza dados meteorológicos.

·     adsb.at trabalha com rastreamento colaborativo de aeronaves.

·     plyr.fm experimenta música social ligada aos repositórios dos usuários.

·     Marque aproxima registro de domínios, identidades e aplicativos.

·     Leaflet, Pckt e Offprint mostram publicação longa.

·     Tangled aplica identidade e dados abertos à colaboração em código.

·     Semble explora curadoria social e coleções.

Na camada econômica, Atmosphere Money testa pagamentos no ecossistema. É um experimento construído sobre o protocolo, não prova de que pagamentos nativos, repartição de receita ou uma economia justa já estejam resolvidos.

Todos esses exemplos são projetos externos e retratam o ecossistema em setembro de 2026. Estar no ATStore ou em uma lista de recursos não equivale a auditoria de segurança, estabilidade ou endosso oficial. Antes de entregar credenciais ou dados, verifique mantenedores, código, política de privacidade e atividade recente.

Uma trilha prática para começar

Primeiro, leia There Are No Instances in atproto e confirme a arquitetura na documentação oficial. Não tente memorizar tudo; fixe apenas a separação entre hospedagem, agregação e interface.

Depois, escolha uma conta pública e abra-a no pds.ls. Localize handle, DID, PDS, coleções e registros. Em seguida, encontre um AT URI e veja como ele identifica um registro sem depender da tela do Bluesky.

O terceiro passo é aprender o vocabulário mínimo: DID, handle, PDS, repositório, registro, Lexicon, NSID, AT URI, CID, relay, AppView e labeler. Esses termos bastam para entender a maior parte das conversas iniciais.

No quarto passo, faça algo pequeno. O tutorial de bot ensina interações básicas; os tutoriais oficiais também incluem aplicação social, feed personalizado e OAuth. Evite começar implantando um relay ou AppView completo.

O quinto passo é autenticar corretamente com OAuth e escopos mínimos. O sexto é observar eventos pelo Jetstream. Só então decida se seu produto precisa de um índice próprio, HappyView, Tap, sincronização integral ou infraestrutura autohospedada.

Por último, desenhe moderação e segurança antes de ganhar usuários. Dados abertos tornam experimentação mais fácil, mas também facilitam replicação, coleta e abuso. Portabilidade não substitui backup; assinatura não produz privacidade; interoperabilidade não garante que todos os aplicativos respeitem as mesmas expectativas.

Um protocolo para construir portas, não outro jardim murado

O aspecto mais interessante do AT Protocol não é a possibilidade de copiar uma rede social conhecida. É permitir que mais de uma interface, um algoritmo, uma hospedagem e uma comunidade sejam portas para identidades e dados compatíveis.

Ainda há concentração de infraestrutura, componentes jovens, desafios econômicos e trabalho de segurança. Spaces está em alpha. Muitos projetos comunitários podem mudar rapidamente. Mesmo assim, já é possível observar uma ideia rara funcionando: uma pessoa publica por uma ferramenta, é descoberta por outra e lida em uma terceira, sem que uma única empresa precise possuir todas as etapas.

Comece pelos dados. Abra um registro, siga seu AT URI, identifique o Lexicon e descubra onde a conta está hospedada. Quando essas peças fizerem sentido, o restante da Atmosphere deixa de parecer uma coleção de siglas e passa a parecer o que ela pretende ser: um espaço comum onde diferentes aplicativos podem continuar inventando novas portas.

Read more

Pablo Murad pablomurad.com

O primeiro acesso

Quando comecei a acessar a internet de forma constante, por volta de 1995, o espaço virtual no Brasil era mato. Não existia Google. Como se descobria um site? Por meio de publicações físicas ou recomendações de terceiros. Imagine isso. Tudo era realmente um deserto.

Ainda naquele ano, apareceu um “buscador” brasileiro chamado Cadê? (o falecido cade.com.br), que era mais ou menos o Google da época, só que completamente diferente. Faz sentido? Hehe, imagino que não.

Site do Cadê

O Cadê? tinha um tráfego alto, e boa parte da internet brasileira, que ainda engatinhava, concentrava-se nele para encontrar o que procurava. Diferentemente dos crawlers modernos e ativos, o Cadê? era um site no qual você cadastrava sua página, que ficava lá no catálogo e era conferida de tempos em tempos para saber se ainda estava no ar. Precário, mas era assim.

Antes disso, meu primeiro contato com a internet foi observando meu tio Dirceu, o nerd mais velho que conheci, acessando redes via Telnet. Isso foi no começo dos anos 90. Não me lembro de quais eram aquelas BBS, mas me lembro dele também no IRC. Inclusive, foi ele quem me ensinou sobre IRC em meados dos anos 90. Lembro que a rede era a EFnet e que, posteriormente, ele migrou para a BrasIRC.

Tínhamos também o BOL, serviço brasileiro de internet muito popular nos anos 90 e queridinho de quem queria ter um e-mail. Quem era mais sabido já ia de America Online ou Yahoo! A internet dos anos 90 era curiosamente pessoal. Se você quisesse alguma coisa, teria que criar e customizar. Bem diferente da internet moderna, industrializada e despersonalizada.

Site do bol.com.br

Então, em 1998, fiz meu primeiro acesso ao IRC. Eu estava no meu pequeno quarto, repleto de pôsteres de bandas e adesivos por todos os lados. Um amigo chamado Dionísio me ajudou. Foi quando ele me fez a pergunta que me definiria por boa parte da vida. Mentira:

“Qual nick você quer?”

Eu? Um nick? Um alter ego estava prestes a nascer. Uma lenda que, posteriormente, mudaria de nome, hehe.

Não soube o que responder. Corri os olhos rapidamente pelo quarto e parei em um adesivo colado na janela. Nele estava escrito “Wagon”, uma marca de roupas dos anos 90. Olhei para Dionísio e pronunciei aquela palavra que só Deus sabia o que queria dizer. Dionísio olhou para mim e, sem dizer nada, digitou “Wagon”.

Foi assim que nasceu meu primeiro nick, que também passei a usar no ICQ poucos meses depois de começar a acessar o IRC.

No IRC, a sala mais movimentada da BrasIRC era a #brasil. Eu ficava maravilhado vendo tantas pessoas interagindo de forma tão dinâmica. Não demoraria muito até eu começar a escorregar pelo #debian e pelo #slackware, mas essa história fica para a próxima.

No ICQ, tínhamos a possibilidade de procurar pessoas por região, cidade e por aí vai.

Você basicamente saía adicionando todo mundo e foda-se. E isso era legal. A internet funcionava com modems de 14.400 bps e, se você estivesse em uma condição financeira melhor, já podia desfrutar da altíssima velocidade de 56 Kbps, no padrão V.90.

E isso tudo era foda demais. Esperar até depois da meia-noite para se conectar e passar a noite inteira baixando uma ou, se tivesse sorte, duas músicas, conectado ao provedor do BOL ou a algum provedor regional.

Só não podiam tirar o telefone do gancho enquanto você estivesse conectado.

O que eu queria dizer neste artigo, que acabou virando uma história, vou deixar para o próximo.

Vlw.

Read more

Pablo Murad pablomurad.com

Um digital garden para documentação

Nota: Se você veio até aqui querendo o que interessa, vá na última linha do texto.

Bem, este é o primeiro post em português de fato. Anteriormente, só fiz o anúncio do que eu iria fazer e, no caso, estou fazendo. Vou falar um pouco sobre conhecimento adquirido e sobre como o armazeno.

Você sabe o que é um digital garden? Um digital garden é um espaço seu na internet, tipo um blog, mas que não é exatamente um blog, onde você “cultiva” ideias, notas, referências, imagens, vídeos e aprendizados ao longo do tempo. Diferente do blog, que costuma organizar textos prontos em ordem cronológica, o jardim, ou digital garden, aceita conteúdos incompletos, interligados por links e sempre sujeitos a revisões. Ele funciona como uma extensão pública do pensamento: algumas notas são apenas sementes, enquanto outras amadurecem conforme você pesquisa, aprende e estabelece novas conexões.

Pense em uma pasta do seu computador na qual você salva tudo de que gosta. Depois, transforme isso em um site que frequentemente recebe novas notas e outros conteúdos. Essa seria a explicação curta do que é um digital garden.

Eu precisava de algo assim. Faço muitas pesquisas e tenho fome de aprender mais, todos os dias. Mas estava cansado de pesquisar, às vezes, diversas vezes sobre os mesmos assuntos. Então iniciei um digital garden.

Queria colocar documentação, tutoriais, links e qualquer tranqueira que eu quisesse em algum lugar. Mas você pode perguntar: por que você não usou o Notion ou o Obsidian?

A resposta é simples: eu queria que fosse público e auto-hospedado.

Coisa que muitas ferramentas entregam apenas em parte.

Ter controle de todos os seus dados é extremamente importante, não apenas por questões de privacidade. Mas todos esses pontos serão abordados no futuro. Já foram abordados em inglês, então, caso queira ler sobre isso agora, procure no blog.

Uso o Obsidian de forma offline e, por meio dele, tomei nota de diversas coisas que eram importantes para mim. Até aí, eu já tinha meu conteúdo. Precisava torná-lo público.

Como o Obsidian utiliza escrita em Markdown, eu precisava apenas ajustar uma coisa ou outra, usar um SSG (Static Site Generator) e pronto: teria o site. Era só customizar, hospedar e pronto.

E, acredite, juntei muita coisa nos últimos dois anos da minha vida. Muito conhecimento. Eu quebrei minha própria Lei de Moore cerebral.

Eu disse “documentação” não apenas porque haverá docs nesse sistema, mas porque queria organizá-lo como os sites de documentação de verdade. Sabe quando você entra em algum site legal, clica em “Documentação” e encontra tudo organizadinho? Na maioria das vezes, são stacks prontas. A única coisa que fiz foi escolher uma e colocar tudo junto.

Eu havia escolhido o Material for MkDocs e estava bem satisfeito. Sempre gostei dele, mas, dois dias depois de deixar meu digital garden pronto, vi que o projeto havia entrado em modo de manutenção e receberia atualizações por apenas mais alguns meses.

Decidi migrar de uma vez, antes que ficasse com preguiça posteriormente.

Então fui pro Zensical. Ele foi criado por uma galera que participou do Material for MkDocs. É bem parecido e bem legal.

Então pronto: meu SSG é o Zensical, com Python 3.12 no CI.

Tenho o plugin Awesome Nav, com um arquivo .nav.yml, e umas extensões aí.

Como fontes, estou usando IBM Plex Sans e IBM Plex Mono, tudo self-hosted.

Nada demais, né? De fato, não é nada demais. Você só precisa ser criativo e pode ir longe em qualquer ambiente de desenvolvimento.

Chega de falação. Vamos ao que interessa: quer ver o que estou postando por lá? Vai no Docs do Murad.

Read more

Pablo Murad pablomurad.com

Anúncio.

Note 1: I apologize to my international readers. I miss writing in Portuguese, and I feel that I also need to help make technology more accessible in my own language. From now on, I’ll be posting in both languages.
Nota 2: Este é o primeiro post em português, minha língua nativa, neste blog. Talvez eu faça mais isso...

Estive postando muito em inglês. Minto, só em inglês.

Mas depois de tantos anos na bolha de desenvolvedores (quase 30), eu até esqueço às vezes da língua-mãe. Passo quase 16 horas na frente do computador, movido a Red Bull, criando, conectando e analisando, dividido entre momentos em que tenho que ser administrador na empresa (sim, eu trabalho).

Talvez eu tenha tomado uma decisão que vá reduzir drasticamente o movimento do meu site: começar a escrever em português.

E sendo sincero? Não estou nem um pouco preocupado. Nunca vivi de tráfego – pelo menos por aqui.

Serão diversos posts, diversos comentários e muitos duplicados, porque já foram postados em inglês.

Mas é isso, esse é um anúncio apenas.

Em breve vou trazendo mais novidades... agora em pt-BR em America/Sao_Paulo.

Read more

Pablo Murad pablomurad.com

Dance monkey, dance.

"The infinite monkey theorem says that a monkey typing randomly for an infinite amount of time would eventually produce any possible work, including Shakespeare."

Around 2022, I began studying the algorithms behind some artificial intelligence systems, and I found it extraordinary. The ability of trained models to produce answers on virtually any subject gave me an almost oracular feeling, as if an immense portion of the universe had somehow been concentrated onto a computer screen.

Shannon's entropy - H(p)=−plog2​p−(1−p)log2​(1−p)

But something felt wrong. In that early dawn of LLMs, everything still seemed empty to me, a kind of colossal mechanism reduced, in my mind, to relationships of if and then. Not because that was actually how it worked, but because I still saw artificial intelligence as a sophisticated succession of conditions, rules, and possible responses.

For some time, I kept following the subject. I joined communities, read articles, followed discussions, and tried to better understand the concepts that kept appearing. Little by little, that simplified image began to fall apart. The machine took on a different shape before me: weights, probabilities, context, attention, sampling, and an almost incomprehensible number of variables interacting at the same time.

That was when it stopped looking like a mere sequence of conditions and began to reveal itself as something much stranger: a machine navigating possibilities.

I then began watching its hallucinations up close, along with its almost inexhaustible ability to produce content, a kind of “industrialized infinity” that we have since learned to recognize by the name slop. And there was something curious about it: different LLMs could answer the same question in different ways, choose different words, follow different paths, and even disagree with one another. Even so, the impression almost always remained that everything came from the same place, like variations produced by a common source.

For a moment, it occurred to me that artificial intelligence might not be all that different from a practical demonstration of the Infinite Monkey Theorem: a machine producing successive combinations without truly understanding what it was placing in front of us.

The comparison, however, began to bother me.

I was a neophyte standing before a new genesis. Then one difference began to seem almost obvious to me: artificial intelligence does not create from nothing, while the monkey, paradoxically, can. The monkey does not need to know Shakespeare in order to produce Shakespeare at some point in infinity. AI, by contrast, depends on a world that came before it, on texts, patterns, and relationships that already existed before its first word.

Well, the fact is, I see a lot of developers worried about the fucking artificial intelligence. It does not create without reference, and it is no more intelligent than... a monkey...

Read more

Pablo Murad pablomurad.com

setting everything up

Well, I was a little sleepless tonight and had nothing I felt like reading or watching on TV. I was feeling this dull kind of boredom, which is pretty bad for me because I’m far too restless. So, at around 8 PM yesterday, I started a little journey.

I sat down at my PC, opened Obsidian, and started gathering Markdown files with notes that I consider pretty interesting.

Obsidian graph view showing a dense network of interconnected notes and knowledge clusters.
Obsidian's graph

Then I thought about taking it a little further, and I did. I decided to catalog as many of the services I maintain as I could. There are a lot of them. I didn’t finish everything, but I did as much as I could. I worked on it from a little after 8 PM until exactly 5:51 this morning.

I spent that time adapting things, creating connections, and customizing my MkDocs. To be fair, I didn’t actually write that much. The real work was separating and organizing everything.

I tend to compulsively catalog every bit of research and every bit of progress I make, and I do it methodically. Even so, I still find myself pretty lost quite often. I always need some kind of guide, a little reference booklet showing what was done, where it came from, and where it is going. I like to keep my system well distributed, especially because I consider myself a compulsive researcher who is never looking for just one piece of information, but rather for variables and variety.

That made me think about all the notes that never made it into Obsidian, so I threw everything I managed to recover into Murad Library. My endless research.

https://murad.gg

But in the end, all of this led me to something more useful, filtered, and organized: Murad’s Docs. Unfortunately, I still don’t have an English version, mostly because I’m too lazy to translate such a huge number of files.

But who knows, maybe one of these days.

Read more

Pablo Murad pablomurad.com

A recap and a reflection

I haven’t created anything lately. For the past three weeks, I’ve focused only on programming and running the company. Not just out of necessity. Building something and making it work has always filled me with joy.

But lately, I’ve been kind of fed up with the “dev” world and its vanities, its criticism, its ideologies and convictions. Maybe I’ll stop doing the little things that have made me happy for almost 30 years. And that “maybe” is a very serious one.

I’m thinking about dedicating myself only to work and to what can be created and generated through it. I don’t know. I just don’t have the same enthusiasm I had in my twenties anymore.

This year has been complicated. This could be considered a sort of mid-year assessment, even though the year won’t actually end for another few months. But there have been so many losses, so many difficult moments. Probably the hardest year of my life.

Just to give you a brief idea, I lost people I cared about deeply and who were very close to me. I lost relatives in Lebanon because of wars. I lost relatives in Brazil, more than five of them. I was betrayed by people I considered friends. I watched people driven by greed come close to destroying everything I had built. And on top of all that, when it came to work, I faced a crisis unlike anything I had ever faced before. And yes, I had to overcome it and build everything back up again.

My social life has become nonexistent. It’s been almost a year since I even knew what it was like to go out and just sit somewhere talking to people. And I’m not even sure I want to anymore.

It’s hard to be optimistic when you have no idea what kind of unpleasant surprise tomorrow might bring, but I am, and I have to be. There’s no room to be weak when dozens of people depend on you.

Motivation is something I know nothing about. Discipline, I have. But above all, I know one thing: nothing beats obsession.

Invictus by William Ernest Henley

Read more

Pablo Murad pablomurad.com

Movie - Cannibal Holocaust

I watched Cannibal Holocaust for the first time a few years ago, and I remember finishing it feeling somewhat disappointed. After all the notoriety, the bans, and all the stories surrounding it, I found the whole thing rather silly, exaggerated, and even a little ridiculous.

I decided to watch it again today, but this time after reading quite a lot about what happened during and after the filming. And that completely changed the experience.

I still think it is a bad film in many ways, cinematically speaking. There are terrible performances, bad dialogue, unintentionally funny moments, and a cheap-looking production that cannot always be excused by the documentary style. At the same time, I realized that some of that ugliness actually works in its favor. Once the supposedly recovered footage begins, the shaky camera, awkward framing, and the feeling that you are watching something that should not exist make everything much more unpleasant.

And there is an unbelievable story behind it. The four main actors signed contracts requiring them to disappear from the media for a period after the film’s release. When accusations began to circulate that Cannibal Holocaust was a snuff film and that some of the deaths were real, their disappearance obviously did not help. Ruggero Deodato eventually had to prove that his actors were still alive. The film was seized shortly after its Italian release, and the director even faced accusations related to the supposed deaths.

The problem is that there is real violence in the film. The animals killed on camera were actually killed, including the famous turtle. There is no special effect or trick involved. Decades later, this is still the part I find hardest to stomach and almost impossible to defend.

Another thing I did not know the first time I watched it is that Deodato said he was thinking about the sensationalism of Italian television at the time, especially the violent imagery associated with the Red Brigades years. The idea was to question how far someone would go to obtain a shocking image. That makes the film much more interesting, because the real monsters in the story are not exactly the people the title tries to sell as savages. They are the civilized men holding the cameras.

And that is where the contradiction that bothered me most during this rewatch comes in: Cannibal Holocaust criticizes people who exploit suffering in order to create sensational images while the film itself exploits real suffering in order to create sensational images. It seems to understand perfectly well the perversity it is condemning while participating in that same perversity.

It is also impossible to ignore its importance. Long before The Blair Witch Project, it was already seriously playing with the idea of recovered material, lost cameras, and fiction presented as documentary evidence. In that sense, it is one of the foundational films of what we would later call found footage.

So my opinion changed quite a lot. I still think Cannibal Holocaust is an ugly, uneven, and often bad film.

I just do not think it is silly anymore.

Once you know the story behind it and understand better what it is trying to do, it becomes much heavier.

And, unfortunately, much more interesting.

Note: I didn’t include any images from the film, and you already know why.

Note 2: You can find the full film on Pablo Tube: https://pablo.tube

Read more

Pablo Murad pablomurad.com

Movie: The Night Porter

Well, I liked The Night Porter, although it is one of those films I could probably never watch (again) with any real emotional distance.

Liliana Cavani does not seem interested in making a comfortable film, nor is she particularly concerned with giving the viewer a safe moral position. What exists there is a deeply unhealthy relationship between memory, desire, guilt, and power. Max and Lucia do not fit easily into the categories we would like to use to understand them. The past did not end when the war ended. It remains present in their bodies, in their gestures, in their sexuality, and in the way they recognize each other so many years later.

Dirk Bogarde is extraordinary precisely because he does not try to make Max into something more palatable. There is a strange, almost pathetic fragility in him, but never enough to erase what he was. Charlotte Rampling achieves something even more difficult. Lucia seems at once trapped by the past and drawn to it. It is uncomfortable because the film refuses to explain exactly where trauma ends and desire begins.

And perhaps that is where The Night Porter is most interesting and also most problematic. The eroticization of the relationship between victim and perpetrator can feel like provocation for the sake of provocation, and I completely understand anyone who rejects the film because of that. At times, Cavani comes dangerously close to turning a story of violence and domination into a kind of aesthetic ritual. Even so, I think the film knows it is dealing with something repulsive. It does not ask us to admire that relationship. It only asks us to keep looking.

For me, there is also an unavoidable personal barrier. I am disgusted by Nazis. Not in some abstract or cinematic sense of the word. My grandparents suffered at their hands, so certain symbols, uniforms, and gestures provoke an immediate reaction in me. I cannot look at those things merely as costumes, aesthetics, or historical reconstruction. There is a family history behind them.

Curiously, that did not make me like the film any less. Perhaps it made me watch it with greater resistance.

The Night Porter is beautiful in many moments, but its beauty is almost always contaminated. There is no real nostalgia in that past, only people who never managed to leave it behind. And the film understands something terrible: surviving something does not necessarily mean escaping it.

I liked it a lot.

But it is a film that leaves a bad taste in your mouth.

And I suspect that is exactly the point.

Read more

Pablo Murad pablomurad.com

There Is Nothing as Powerful as a Transformed Mind

There is nothing as powerful as a transformed mind. You can change your hair, your clothes, your address, your home, your job, the people around you, and even the entire appearance of your life. But if your way of thinking remains the same, sooner or later you are likely to find yourself living through the same conflicts again, repeating the same habits, and stumbling over the same limits. Everything will have changed externally, but inside, you will still be carrying the same structure that produced what you tried to escape from.

That is why every true change begins within. If you want something different from life, if you want to reach a goal, abandon a behavior, overcome a habit, or simply become a better version of yourself, you will have to accept that this process requires effort. It is difficult to examine the things we do automatically, question old beliefs, and recognize our own limitations. Even so, it is precisely in confronting these things that we begin to discover what we are capable of.

Many people go through life without knowing their own talents. Some never discover what they could have done; others do discover it, but never develop it. Not because they lack intelligence, strength, or ability, but because it is often more comfortable to remain in familiar territory than to risk something new. Perhaps one of the greatest losses possible is to reach the end of life carrying talents, ideas, and possibilities that never had the chance to exist.

Happiness, in this sense, is not only about achieving something. It also appears when you realize that you have moved forward, that you have broken through an old limit, and that you are no longer exactly the same person you once were. There is a kind of satisfaction that is difficult to explain when we discover that we were capable of facing something that, for a long time, seemed too great for us. Little by little, what once seemed impossible stops being a wall and becomes simply another difficulty that must be crossed.

When you face your fears and keep moving forward despite them, something changes inside you. Confidence does not suddenly appear like a revelation. It is born from repetition, from small victories, from endured mistakes, and from the experience of continuing even when things do not go as planned. You begin to trust yourself not because you believe you will never fail, but because you learn that you can survive failure, correct your course, and try again.

It is easy to look at someone successful and imagine that the person possesses some special quality, some extraordinary talent, or a kind of genius inaccessible to others. The problem is that we usually see only the final result. We see the recognition, but not the years of silent work that came before it. People are often rewarded in public for what they spent a long time doing when no one was watching.

We almost never see the failed attempts, the doubts, the mistakes, the exhaustion, or the times when someone seriously considered giving up. We do not see the training, the study, the difficult choices, or the periods when there seemed to be no reward at all. That is why comparing the beginning of our journey with the result of someone who has already traveled much of the road is an unfair way to measure our own ability.

We also need to learn to protect what we want to build. If you spend too much time trying to convince other people that your dream deserves to exist, you risk giving them the power to decide whether it is worthwhile. Not everyone will understand your choices. Some people will try to discourage you, while others will project their own fears onto what you intend to do. And if you constantly depend on their approval, you may abandon something important simply because someone who never had the courage to try decided to tell you it was impossible.

There are moments when you need to stop explaining and start doing. Not every project needs to be understood by everyone, just as not every dream needs an audience. Some things need only time, persistence, and work. The value of what you are building cannot depend exclusively on the opinions of the people around you, especially when they do not know your reasons, your abilities, or the path you have chosen to follow.

There is also an uncomfortable question that we almost always avoid: how much time do we have left? We simply do not know. We live as though there will always be another year, another opportunity, another Monday, another more suitable moment to begin. While we wait for perfect conditions, time keeps passing without asking permission.

Many of us carry things that never make it into the world. Ideas that were never put into practice, projects left waiting, words that were never spoken, and talents that remained hidden because there always seemed to be a better occasion in the future. But the future owes us absolutely nothing. At some point, we need to understand that the time we have is precisely this one, with all its limitations, imperfections, and difficulties.

If you truly want something, you will need to learn to persist. It is not enough to want it when everything is working. You will need to find ways forward when the most obvious path disappears, learn new skills, adapt, improvise, and continue after defeat. Perseverance is not a beautiful quality only when told after victory; it is often quite unpleasant while it is happening.

It is exhausting to try again when you have just failed. It is uncomfortable to admit that you were wrong, correct what you did, and begin again. But perhaps one of the greatest differences between those who abandon a goal and those who manage to achieve it lies precisely in this ability to endure discomfort without turning it into a definitive reason to give up. Falling is part of it. Staying on the ground forever is something else.

There is a curious strength that appears when someone clearly understands what they want and decides to truly commit to it. It does not mean that fear disappears, nor that doubts cease to exist. It simply means that they no longer have the final word. Difficulties remain difficulties, but they no longer necessarily feel like sentences. They become problems that need to be understood, faced, and, when possible, solved.

There is also a critic within each of us. It knows our old mistakes, our insecurities, and our failures, and it knows exactly which words to use to convince us that we are incapable. We do not need to pretend that this voice does not exist, but we do need to learn not to treat it as an authority. Fear is not prophecy, insecurity is not a diagnosis, and doubt is not proof of incapacity.

At some point, you need to take responsibility for what you will do with your own life. Perhaps you still do not know exactly how to get where you intend to go, and there is nothing wrong with that. You can learn what you do not yet know, improve what you still do poorly, change strategy when necessary, and keep moving forward without demanding an impossible certainty from yourself.

The human spirit is more resilient than we usually imagine. Many times we believe we have reached our limit and, even so, we find the energy to move a little farther. Not because we are invincible, but because we are capable of adapting. We can learn, rebuild, change direction, begin again, and transform difficult experiences into something that allows us to keep going.

That is why you should live with intention. Do not go through your own days with the brakes on because you are afraid of bothering someone, failing, or disappointing someone. Do not diminish what you want simply to fit comfortably within other people's expectations. Allow yourself to discover how far you can go, even if that discovery happens slowly and without any guarantee of success.

Confidence is built this way: one small promise kept at a time. Every time you decide to do something and actually do it, you strengthen the trust you have in yourself. Every fear you face adds something. Every attempt, even an imperfect one, provides experience for the next. Little by little, you stop depending only on motivation and begin to have something more solid: evidence that you are capable of continuing.

Perhaps you still do not know whether you will be able to reach exactly where you want to go. No one can promise you that. But you can decide not to allow fear to choose the path in your place. You can begin with what you have, learn along the way, and move forward a little every day. Sometimes, that is how great changes begin: not with absolute certainty, but with the quiet decision not to abandon yourself.

Read more

Pablo Murad pablomurad.com

systemd: why do some Linux distributions go out of their way to avoid it?

I was reading about antiX when something caught my attention. The distribution presents itself as lightweight, suitable even for older machines, based on Debian and, at the same time, deliberately continues without systemd. In version 26, released in March 2026, antiX went even further: it began offering five init options, with runit as the default, in addition to SysVinit, dinit, s6-rc and s6-66.

The first reaction is to imagine that the explanation is simple. Maybe systemd is heavy. Maybe it is incompatible with older machines. Maybe the antiX developers are simply traditionalists. None of those answers, on its own, explains much.

What I found is a far more interesting discussion. The debate around systemd mixes operating system architecture, process management, cgroups, logging, security, portability, Unix philosophy and, inevitably, culture. There is also quite a bit of historical noise. There are very good technical criticisms, outdated criticisms, exaggerations and a considerable number of slogans that have been repeated for more than a decade.

The best way to understand why someone would choose not to use systemd is to first understand what problem it tried to solve.

Before systemd

For a long time, talking about booting a Unix or Linux system meant talking about some variant of the traditional init model.

After the kernel finishes its part of the boot process, it starts the first process in user space. That process receives PID 1. Historically, init implementations such as SysVinit took on that role. PID 1 then coordinates the transition from an almost empty system to a usable environment.

In the SysV world, much of that work was organized around scripts in:

/etc/init.d/

and around runlevels. Each service had a script capable of accepting actions such as:

/etc/init.d/ssh start
/etc/init.d/ssh stop
/etc/init.d/ssh restart

Distributions created links and conventions to define what should start at each runlevel.

This model has a real virtue: it is easy to inspect. A shell script is just a text file. If something looks strange, you open the file, follow the commands and, in many cases, run the same steps manually.

But local simplicity does not mean simplicity of the system as a whole.

On a machine with dozens or hundreds of services, difficult questions arise. Does the database need to start before the application? Does the application really depend on the network being available, or only on the interface having been configured? What happens when a daemon calls fork() and creates children? How do you restart it if it dies? How do you know that the process using the PID recorded in a file is still the original process? How do you parallelize boot without creating races? How do you express dependencies without turning shell scripts into a web of conventions specific to each distribution?

During the 2000s, several attempts appeared to modernize this. One of the best known was Upstart, created by Canonical. It replaced part of the sequential logic with an event-driven model. Ubuntu adopted it before later migrating to systemd.

When systemd appeared in 2010, then, it was not solving an invented problem. There was room for a service manager with better supervision, explicit dependencies and more precise knowledge of process state.

Traditional Unix boot sequence

An /etc/rc from Unix Version 7, from 1979. The historical model was much smaller than that of a modern Linux system.

What systemd really is

Calling systemd simply an “init” is accurate enough for a quick conversation and insufficient for understanding the controversy.

The systemd executable, when used as PID 1, works as a system and service manager. It starts and tracks services, builds a dependency graph, manages states, sockets, mounts, timers, slices, scopes and other types of units.

But the name systemd also identifies a larger project, made up of several programs and daemons. Among them are or have been, depending on the distribution's configuration:

systemd-journald
systemd-logind
systemd-networkd
systemd-resolved
systemd-timesyncd
systemd-udevd
systemd-homed
systemd-machined
systemd-boot

This distinction matters because a common criticism says that “everything runs inside PID 1.” It does not.

PID 1 is one process. systemd-journald is another. systemd-resolved is another. systemd-logind is another. They belong to the same project and are integrated with one another, but they are not a single mass running inside the same process.

This also explains why the phrase “systemd is monolithic” tends to cause confusion. If “monolithic” means “a single gigantic binary doing everything,” the description is wrong. If the word is being used to criticize the broad scope of the project and the degree of integration among its components, then there is a legitimate architectural discussion there.

PID 1 is a special place

Minimalists are not concerned about the size of PID 1 out of nostalgia. There is a technical reason.

On Unix and Linux, PID 1 receives responsibilities that ordinary processes do not have. Among other things, it takes part in handling orphaned processes and must correctly perform the reaping of terminated child processes. The kernel also treats signals sent to PID 1 in a special way.

If PID 1 fails irrecoverably, the machine does not simply continue running as if a text editor had closed. The system loses its primordial user-space process.

That is why there is a school of thought that prefers something extremely small as PID 1 and moves supervision, logging, networking and other functions into independent components.

The argument is reasonable. So is the counterargument: a modern PID 1 needs to know quite a lot about service topology in order to manage it correctly, and pushing complexity into dozens of external scripts does not make the complexity disappear.

The useful question is not “how many lines of code does the project have?”, but where the complexity lives, how it is bounded and how failures propagate.

Why Fedora adopted systemd so early

Fedora was the distribution that turned systemd from a new project into a seriously tested alternative on the Linux desktop. The historical feature page for Fedora 15 explicitly described the goal of replacing SysVinit and Upstart.

It already contained several ideas that would become central:

  • aggressive parallelization;
  • socket and D-Bus activation;
  • on-demand startup;
  • process tracking with cgroups;
  • transactional dependencies;
  • mounts and automounts treated as units;
  • .service files instead of large shell scripts.

Fedora 15, released in 2011, adopted systemd as the default.

An interesting detail in the documentation from the time is that boot speed was present, but it was not the only motivation. The architecture aimed to improve management, not merely shave a few seconds off startup.

That distinction remains relevant in 2026. On modern machines, boot is often fast enough that nobody chooses an init system over a difference of two or three seconds. Supervision, isolation, observability and integration with cgroups are more important arguments.

Why Debian adopted systemd

Debian's decision was decisive because Debian is the foundation of a huge ecosystem.

In February 2014, after months of discussion, the Technical Committee decided that systemd would be the default init system for Debian Jessie's Linux architectures.

The vote matters for another reason: it shows that the discussion was not simply about “which one boots faster?” There was explicit concern about coupling.

Still in 2014, the project discussed whether packages should be allowed to require a specific init system. One proposal warned about the risk of the ecosystem making it impractical to switch init systems if unrelated software began depending on a particular implementation.

That is exactly the issue that today explains much of the work done by distributions such as Devuan and antiX.

Ubuntu, which used Upstart, ultimately followed the Debian ecosystem and adopted systemd as the default starting in 2015.

From that point on, the center of gravity shifted. Fedora, Debian, Ubuntu, Arch, SUSE and other major distributions converged. For software developers, documenting a systemd unit began to solve the problem for a huge share of Linux users.

That standardization advantage also produces the side effect that bothers its critics: the more software assumes systemd, the more expensive it becomes to live outside it.

What is a unit?

One of systemd's best aspects is the idea of representing resources as declarative units.

A simple service unit can look like this:

[Unit]
Description=Example service
After=network-online.target

[Service]
ExecStart=/usr/local/bin/example
Restart=on-failure

[Install]
WantedBy=multi-user.target

Instead of manually writing start() and stop() functions, manipulating PID files and repeating daemonization logic, you declare the main process and execution properties.

systemd has several types of units. Among the most common:

.service
.socket
.timer
.mount
.automount
.path
.target
.slice
.scope
.device

.service describes services. .socket allows socket activation. .timer schedules executions. .mount represents mounts. .target aggregates units and, in many cases, works as a synchronization point conceptually similar to old runlevels, although the model is more flexible.

Dependency is not the same thing as ordering

This detail seems small, but it is one of the model's smartest decisions.

Consider:

Requires=postgresql.service
After=postgresql.service

Requires= expresses a dependency relationship.

After= expresses ordering.

A unit may need to start after another without necessarily causing the other one to start. And it may want a dependency without, by itself, determining the entire ordering.

In traditional SysV, these two ideas often ended up mixed together in script sequencing. systemd makes them explicit.

Wants= expresses a weaker dependency than Requires=. Before= is the inverse of an After= ordering relationship.

This produces a graph that the service manager can analyze before executing transactions.

Supervision: starting a daemon is not the same as managing it

An essential difference between old and new models is the idea of supervision.

Starting a process is easy:

/usr/local/bin/example &

Managing its lifecycle is another matter.

Who checks whether it died? Who restarts it? Who records its status? Who knows which child processes belong to the service? Who terminates all of them during shutdown?

With systemd:

[Service]
ExecStart=/usr/local/bin/example
Restart=on-failure

already describes a basic supervision policy.

This is not exclusive to systemd. runit and s6 provide excellent supervision, and that is precisely why they are far more interesting alternatives than simply going back to pure SysVinit.

systemd's merit was combining supervision with the rest of the modern Linux administration model.

Cgroups changed process management

This is one of the most important parts of the story.

Imagine a service that creates this tree:

main daemon
├── worker
├── worker
└── helper

In the old model, reliably identifying every process that belongs to the service can become complicated. PID files help with the main process, but they do not robustly represent the entire tree.

Linux cgroups solve that problem at another layer.

systemd places services into cgroups. As a result, the service manager stops thinking only in terms of “what is the daemon's PID?” and starts managing the group of processes that belongs to the unit.

This helps with:

  • shutdown;
  • restart;
  • accounting;
  • memory limits;
  • CPU limits;
  • identifying the processes of a service;
  • isolation;
  • delegation to containers.

With cgroup v2, systemd organizes services, sessions, scopes and slices into a hierarchy. The project's current documentation describes system.slice, user.slice and machines.slice as standard parts of that tree.

This is a case in which systemd is deeply tied to Linux. And that is intentional.

From Fedora's earliest documents, the project said it did not intend to be portable to other Unix systems. The idea was to make aggressive use of Linux kernel features.

For people who think “Linux first,” that is an advantage.

For people who value software that can move between Linux, FreeBSD, OpenBSD and other Unix-like systems, it is exactly the opposite.

Socket activation

Socket activation is another concept that is often mentioned without explanation.

We normally think of it like this:

start daemon
↓
daemon opens port/socket
↓
clients can connect

With socket activation, the service manager can open the socket first:

systemd opens socket
↓
client connects
↓
service is started
↓
socket is handed to the service

This makes it possible to start services on demand and, in certain scenarios, parallelize dependencies: a consumer can begin working even while the process that will handle the socket is still starting up.

It is not magic. The software must be compatible with the model, and not every daemon benefits from it. But it is a powerful tool when applied correctly.

s6 also provides mechanisms related to socket activation. So, once again, this is not a capability that only systemd can implement.

Timers and cron

cron is still great.

A line like:

0 3 * * * /usr/local/bin/backup

is small, universally recognizable and perfect for many cases.

systemd timers solve the same kind of problem in a way that is integrated with the service manager.

A .timer triggers a .service, which means the execution inherits the same model for logs, dependencies, user, sandboxing, resource limits and status.

Timers also have useful features such as randomized delays, monotonic timers and handling of runs that should have happened while the machine was powered off, depending on the configuration.

The choice does not have to be religious. If I have half a dozen simple scripts on a server, cron may be clearer. If the task is already managed as a service unit and needs the same security and observability policy, a timer usually fits better.

journald and the log war

Perhaps no part of systemd has irritated traditional administrators as much as journald.

The classic Unix model is comfortable:

/var/log/syslog
/var/log/messages
/var/log/auth.log

and then:

grep
awk
sed
tail
less

Text files are transparent, easy to copy, recover and analyze with tools that have existed for decades.

journald chose its own structured format. You query it with:

journalctl

and can filter by unit:

journalctl -u nginx

by boot, PID, UID, priority, time interval and various other metadata fields.

The gain is real. A log is not merely a sequence of lines; each entry can carry structured context. That makes operational questions very easy to answer.

The criticism is real too. You become dependent on tools that understand the journal. cat is no longer enough to inspect the raw storage.

Simply saying that “binary logs are bad” is shallow. Databases and structured formats do not become unsuitable merely because they are not plain text. The question is whether the advantages of indexing and metadata outweigh the cost of specific tools and more specialized recovery.

Another exaggerated claim is that journald prevents syslog. It does not. systemd can coexist with traditional syslog implementations, and distributions can forward messages according to their policy.

My reading is that the strongest criticism is not “binary = bad,” but rather reduced replaceability through generic Unix tools. That is a much more interesting architectural criticism.

Sandboxing without putting everything in a container

One of systemd's capabilities that administrators tend to underestimate is systemd.exec.

A service unit can receive restrictions such as:

[Service]
ExecStart=/usr/local/bin/example

NoNewPrivileges=yes
ProtectSystem=strict
ProtectHome=yes
PrivateTmp=yes
PrivateDevices=yes
RestrictAddressFamilies=AF_UNIX AF_INET AF_INET6
MemoryMax=512M
CPUQuota=50%
CapabilityBoundingSet=

These options belong to different families.

NoNewPrivileges=yes prevents the process and its descendants from gaining privileges through mechanisms such as setuid executables.

ProtectSystem= and ProtectHome= alter the visibility and permissions of parts of the filesystem.

PrivateTmp=yes creates a private view of temporary directories.

PrivateDevices=yes restricts access to devices.

RestrictAddressFamilies= limits socket families.

MemoryMax= and CPUQuota= use resource-control mechanisms.

CapabilityBoundingSet= reduces the available capabilities.

SystemCallFilter= can limit sets of syscalls.

This does not automatically turn an insecure program into a secure one. Hardening requires understanding the service. A bad rule can break the application or provide a false sense of isolation.

But for many small daemons, these options make it possible to impose useful limits without creating a Docker container just to obtain basic isolation.

You can even analyze a unit with:

systemd-analyze security name.service

and use the result as a starting point for review.

So why do people say systemd violates the Unix philosophy?

The most repeated phrase is:

Do one thing and do it well.

It represents a real tradition, but it is not a constitutional article of Unix.

The idea is to favor small programs, simple interfaces, composition and replaceability. Tools should communicate through predictable mechanisms, often text and pipes.

systemd was born from a different priority: coherent integration of system management.

It uses many separate components, but those components share conventions, libraries, APIs, unit formats, D-Bus and a common view of the system.

For its defenders, this eliminates duplication, solves cases that independent scripts handled poorly and provides a consistent platform.

For its critics, it creates a central layer with too broad a reach.

Both are describing real aspects.

The discussion becomes poor when one side caricatures the other. It is not true that every critic wants to return to a 1975 Unix. It is also not true that every form of integration is automatically “anti-Unix.”

Scope creep: when an init stops being just an init

The project has grown substantially since 2010.

In addition to system/service management, the systemd ecosystem maintains components related to logging, login and sessions, DNS, networking, time synchronization, devices, temporary files, mounts, containers, boot, users, credentials and home directories, among other areas.

This is where the scope creep criticism becomes stronger.

An administrator may like systemd.service and not want systemd-resolved. They may use journald and prefer NetworkManager over networkd. On many distributions, that is perfectly possible.

But the fact that components are optional does not eliminate the architectural question. The project as a whole has become one of the major infrastructure centers of Linux user space.

That brings integration gains and increases the number of decisions concentrated in the same project.

A serious criticism does not need to claim that there is a conspiracy to “dominate Linux.” It is enough to observe that concentration of responsibility increases the technical and social impact of that project's decisions.

The real problem: ecosystem dependencies

At first, the question seemed to be:

systemd vs another init

Today it looks more like:

init
login/session management
udev
D-Bus
desktop environments
service units
cgroups
packaging
libraries
distribution policies

This is the point that makes antiX and Devuan interesting.

It is not enough to replace /sbin/init.

Desktop software may expect interfaces provided by logind. Packages may install only systemd units. Upstream documentation may assume systemctl. Certain integrations may expect udev, cgroups or behavior defined by the systemd ecosystem.

Projects without systemd need to decide how to fill those gaps.

Two names appear quite often:

elogind extracts systemd's login/session management functionality so that it can be used independently of systemd as PID 1.

eudev emerged as an alternative/fork of udev for ecosystems that wanted less dependence on the systemd suite. The device-management situation varies by distribution, and some use other solutions, such as mdev on Alpine.

That is the difference between:

“not installing systemd”

and:

“maintaining a modern distribution without depending on the systemd ecosystem”

The second sentence describes ongoing integration work.

antiX: the example that brought me here

antiX

Example of an antiX desktop. Its appearance varies by version and window manager.

antiX is an especially interesting case in 2026 because it did not simply choose “the old init.”

antiX 26, released on March 21, 2026, offers five options:

runit (default)
SysVinit
dinit
s6-rc
s6-66

That says a lot about the project's intent.

The focus remains lightweight operation, older machines and user control, but the current strategy recognizes that there are modern alternatives to systemd, not just SysVinit.

Runit provides real supervision. dinit has dependencies and parallelization. s6 provides a robust supervision-tree architecture.

So when someone summarizes antiX as “they do not use systemd because it is heavy,” they miss the most interesting part.

antiX is choosing a different philosophy of composition.

Devuan

Devuan was born directly from Debian's decision to adopt systemd.

Its goal is not to pretend that the modern ecosystem does not exist. On the contrary: Devuan has to do the work precisely to provide a Debian-like system without systemd as PID 1.

The current migration documentation shows this almost didactically. When migrating from Debian to Devuan, packages such as these appear:

sysvinit-core
eudev
elogind

In other words, removing systemd requires replacing responsibilities that, on a standard Debian system, are already integrated.

Devuan presents SysVinit as the default and also works with alternatives such as OpenRC and runit.

If you want Debian without systemd, Devuan makes more sense than manually ripping systemd out of a current Debian installation, because the distribution takes responsibility for maintaining that choice.

Void Linux and runit

Void is probably one of the best arguments against the idea that “without systemd you are stuck with old technology.”

Void uses runit.

Runit is small, portable and focused on supervision. Each service has a directory and usually a run script that executes the daemon in the foreground.

On Void:

sv up nginx
sv down nginx
sv restart nginx
sv status nginx

Enabled services are linked into the supervised directory.

The runit documentation emphasizes an important point: the supervisor directly knows the process it started, avoiding some of the historical fragility of PID files and double daemonization.

The beauty of the model is that supervision is treated as the central problem, without turning the supervisor into a platform for DNS, networking, login and the bootloader.

That separation is exactly what attracts its users.

The price is that other functions need to be handled by other tools and by the distribution's integration work.

Alpine Linux and OpenRC

Alpine uses OpenRC as its default init/service management system.

OpenRC keeps an experience very close to the script tradition, but adds explicit dependency management and its own tools:

rc-service nginx start
rc-service nginx stop
rc-update add nginx
rc-status

Alpine is important evidence because it is widely used in containers and minimalist servers. Not using systemd does not prevent a Linux system from being modern, supporting cgroup v2 or running current workloads.

It also shows that the cost exists. Package documentation makes it clear that support scripts for different init systems need to be packaged. For certain software, Alpine provides -openrc packages; other alternatives may not have ready-made scripts.

Artix

Artix occupies a niche similar to “Arch without systemd.”

The project offers variants with OpenRC, runit, s6 and dinit. The idea is to provide the experience of an Arch-style rolling-release system while retaining alternative init systems.

It is a good laboratory for anyone who wants to compare models without giving up a modern desktop.

It also requires accepting that documentation written for Arch often assumes systemd. At some point, you need to translate systemctl enable --now x into the tool and model used by the variant you chose.

Gentoo

Gentoo follows a solution that fits its culture well: choice.

OpenRC is the historical and native option, while systemd is fully supported.

This coexistence is interesting because it demonstrates that both architectures can be treated as first-class options when a distribution decides to invest in maintaining both.

It is also a reminder that “without systemd” does not necessarily mean “anti-systemd.”

The alternatives

SysVinit

SysVinit is historically important and remains functional.

Its strengths are predictability, familiarity and an architecture that leaves much of the work visible in scripts.

The problem is that, on its own, it does not provide as complete a modern answer for supervision, process groups and dependencies.

Using it today usually involves combining it with other tools.

runit

Runit is small and elegant.

Its strengths are:

  • simple supervision;
  • an easy-to-understand service model;
  • automatic restart;
  • a small codebase;
  • portability across several Unix-like systems.

It is excellent when you want the service to be a supervised foreground process and prefer to build the rest of the system with independent tools.

OpenRC

OpenRC is a more natural evolution for people who like the traditional model.

It provides dependencies, runlevels and consistent management without taking on the same scope as systemd.

It is especially attractive on Gentoo and Alpine because the distribution ecosystem already does the integration work.

s6

s6 is perhaps the option that is most technically impressive among the minimalist systems.

It starts from a small and robust supervision tree. The ecosystem includes components for service management and init while preserving a philosophy of composable tools.

The problem is ergonomics. For many people, the learning curve is steeper than with runit and systemd.

This is improving with layers such as s6-frontend, but it remains a solution that rewards those who want to understand the model deeply.

dinit

dinit tries to occupy an interesting middle ground.

It is compact, but provides dependencies, parallel startup, controlled restart and service management.

In 2026 it gained additional relevance: antiX 26 offers it as an option and the project announced adoption by distributions such as KaOS.

Dinit proves that there is still practical research happening in the init/service-manager space. The discussion did not end in 2015.

What people say about systemd that is not always true

“systemd is one gigantic binary”

No.

The project is large, but it contains several separate executables and daemons. The correct criticism is about scope and integration, not about everything being compiled into a single process.

“Everything runs inside PID 1”

No.

PID 1 runs the system/service manager. journald, logind, resolved, networkd and others are separate processes when they are used.

“If journald gets corrupted, you necessarily lose all your logs”

That is an exaggeration.

Corruption is a legitimate concern for any structured storage system, but journald has its own tools and mechanisms, and traditional syslog can coexist with it.

The stronger criticism is dependence on specific tooling.

“systemd replaced all of Unix”

No.

It has taken on many infrastructure functions in modern Linux, but it still coexists with shell, cron, syslog, NetworkManager, DNS servers, containers and dozens of other tools when the distribution chooses to configure things that way.

“systemd is always slower”

There is no serious basis for that generalization.

Boot time depends on hardware, services, distribution and configuration. The architecture itself was designed for parallelization and on-demand activation.

It is also true that a minimalist system using runit may have fewer components and boot very quickly. A benchmark without context is worth little.

“systemd only exists because Red Hat forced everyone to use it”

Red Hat had enormous influence because Fedora was the first major adopter and Lennart Poettering worked there.

But Debian made its own decision after a long and contentious discussion. Arch, SUSE, Ubuntu and other projects also had their own processes.

Influence is not the same thing as centralized imposition.

“Modern Linux does not work without systemd”

antiX, Devuan, Void, Alpine, Artix and Gentoo demonstrate the opposite every day.

What is true is that maintaining a modern Linux desktop without systemd may require extra integration work.

“systemd is spyware”

There is no technical basis for that claim as a description of the project.

“systemd is insecure by definition”

No.

Complexity increases the bug surface, and that deserves discussion. At the same time, systemd provides sandboxing controls, capabilities, namespaces and cgroups that can reduce the surface exposed by services.

Security needs to be analyzed in terms of threats and configuration, not slogans.

“Anyone who dislikes systemd is nostalgic”

That is a caricature.

There are perfectly modern architectural criticisms concerning coupling, portability, replaceability and concentration of responsibility.

“Alternatives are always simpler”

No.

Runit is conceptually simple. A complete desktop system built around it may require several additional pieces, scripts and decisions.

Simplicity of a component does not guarantee simplicity of the integrated system.

The criticisms of systemd that make sense

Once the exaggerations are separated out, quite a lot of serious material remains.

1. The scope is enormous

There is no denying it.

The project covers many areas of Linux user space. This increases the number of architectural decisions that pass through the same ecosystem.

2. Coupling is increasing

Even when a component is optional, third-party software may assume its interfaces.

An alternative distribution needs to track upstream projects, maintain scripts, adapt dependencies and provide replacements.

3. Portability is not a goal

systemd is deliberately Linux-specific.

If your view of Unix values software that can be shared between Linux and BSD, that is a structural disadvantage, not a minor detail.

4. Debugging can be abstract

When everything works, systemctl status and journalctl are excellent.

When a unit enters a strange state because of a dependency, generator, override, target or cgroup interaction, you need to understand the systemd model. “It is declarative” does not mean “it is always simple.”

5. There is a concentration of responsibility

A bug or change in systemd infrastructure can affect many distributions at the same time.

That is the other side of standardization.

The strengths that also need to be taken seriously

Service supervision

systemd manages services throughout their entire lifecycle, not only during boot.

Cgroups

The ability to track every process in a unit and apply limits is excellent for servers.

Declarative units

For many services, a .service file is smaller and less ambiguous than full init scripts.

Consistent tools

systemctl status nginx
journalctl -u nginx
systemctl list-dependencies nginx

work in a similar way across a huge number of distributions.

Sandboxing

It is possible to apply isolation policies directly to the service.

User services

Per-user services are very useful for desktop applications and persistent agents.

Timers

They integrate scheduling into the same supervision, logging and security model.

Documentation and support

Mass adoption has created a huge amount of documentation, examples and available operational knowledge.

Integration with modern Linux

If you want cgroups v2, containers, resource management, sessions and services working within the same model, systemd is a very capable solution.

A slightly more hardened example

Taking the simple unit:

[Unit]
Description=Example service
After=network-online.target

[Service]
ExecStart=/usr/local/bin/example
Restart=on-failure

NoNewPrivileges=yes
PrivateTmp=yes
ProtectSystem=strict
ProtectHome=yes
MemoryMax=512M

[Install]
WantedBy=multi-user.target

Now the service manager is not merely starting /usr/local/bin/example.

It is defining a restart policy, creating a more restricted filesystem view for the process and limiting memory.

That is why saying “systemd is only for boot” stopped making sense a long time ago.

Would I manually remove systemd from a modern Debian system?

On an ordinary Debian server, no.

Not because it is impossible. Because the cost-benefit ratio is poor.

Debian tests its packages, documentation and integration assuming systemd as the default. By removing it, you become responsible for solving incompatibilities that a distribution such as Devuan has already taken on as part of its mission.

If there is a concrete need not to use systemd, I would choose a distribution built for that.

For a minimalist server, Alpine or Void can be excellent choices.

For a Debian-like system without systemd, Devuan is far more sensible.

For experimenting with different philosophies, antiX 26 has become a particularly fun laboratory.

For those who want maximum control and are willing to invest the time, Gentoo remains one of the most flexible options.

Removing systemd from Debian just to prove that it can be done tends to turn an architectural preference into unnecessary operational work.

What about servers?

On servers, systemd is usually a practical advantage.

Cgroups, resource limits, restart policies, logs, hardening and uniform administration are useful.

On hosts running Docker or Podman, systemd on the host and the container runtime operate at different levels. systemd can manage the daemon/runtime and the cgroup tree; inside small containers, there is usually no need to run a full service manager.

There is a subtlety here: every container also has a PID 1 inside its namespace. Sometimes a tiny init is used for proper signal handling and reaping. In containers that actually represent a complete system, systemd can be used as PID 1, provided cgroups and permissions are configured appropriately.

In other words, containers did not make init systems irrelevant. They merely moved part of the discussion.

What about the desktop?

The average user probably does not notice systemd directly.

They notice that the session starts, the laptop suspends, devices appear, audio works, the network comes up and user applications start.

Behind that are login/session-management components, udev, D-Bus, per-user services and desktop integrations.

That is why removing systemd from a desktop can be more work than removing it from a very simple server. The problem is not just starting nginx; it is integrating a graphical stack full of expectations.

Distributions without systemd solve this with elogind, eudev/mdev, scripts and desktop-specific choices.

Does the controversy still make sense in 2026?

Yes, but it has changed.

In 2014, the question was whether systemd should win.

In 2026, it has already won as the dominant default among the major Linux distributions.

The interesting discussion now is different: how much of Linux user space should converge around it, and how much room is worth preserving for alternative architectures?

That question remains healthy.

The fact that antiX 26 offers five init systems is almost a practical answer to the argument that the subject is settled. Void continues to show that runit is enough to build a modern distribution. Alpine demonstrates that OpenRC and cgroup v2 coexist perfectly well. Gentoo maintains two well-supported paths. Dinit continues to evolve. s6 continues to explore an extremely modular view of supervision.

At the same time, systemd has become better, more mature and harder to dismiss as “a bloated init.”

It solved real problems.

Supervision is better than hunting for PID files. Cgroups are better than guessing process trees. Declarative units are excellent for packaging. Timers, sandboxing and user services are practical tools. On a modern Debian, Fedora, Arch or Ubuntu system, there is very little operational reason to rip it out without a specific need.

But the criticisms concerning scope, coupling, portability and replaceability remain valid.

After researching the subject, my position became less dramatic than the history of the controversy tends to suggest.

I would not remove systemd from a distribution whose entire ecosystem was built and tested around it. On Debian servers, for example, it gives me more advantages than problems.

I also would not want a Linux world in which the alternatives ceased to exist.

Projects such as antiX, Void, Alpine, Devuan, Artix and Gentoo act as a form of architectural diversity. They keep different ideas about supervision, init, composition and portability alive. Some of those ideas may even influence the mainstream in the future.

That is what I did not understand when I started reading about antiX.

The question is not really “why does anyone hate systemd?”

The question is: how much integration do we want to concentrate in a central layer of the system, and how much are we willing to pay to preserve replaceable components?

The answer depends on the system we are building.

And that is much more interesting than “systemd is heavy.”


systemd

Adoption history

Distributions without systemd as the default

Alternatives

Read more

Pablo Murad pablomurad.com

Movie: The Adventures of Baron Munchausen

I rewatched The Adventures of Baron Munchausen today, many years after seeing it for the first time, and the feeling was a curious one: certain images still seemed tucked away somewhere in my memory, like fragments of an old dream I didn’t know I was still carrying with me.
What struck me most this time was precisely the film’s playful, delirious, surreal side. There is something deeply enchanting in the way Terry Gilliam treats imagination not as an escape, but almost as a form of resistance. The Baron moves through wars, gods, monsters, impossible moons, and absurd situations with the natural ease of someone who refuses to accept that the world must be only what it is.

That freedom feels even more beautiful to me now.
The film has the texture of a fable built by hand. The sets, costumes, smoke, colors, mechanisms, visual excesses — everything seems to belong to some enormous theatre that has abandoned any obligation to reality. And there is something very human about that. It is not sterile or flawless fantasy. It is messy, baroque, excessive, sometimes even awkward, but full of life.
Watching it again, I also felt the melancholy beneath the adventure much more strongly. Munchausen is an old man surrounded by a world that no longer seems to have patience for stories, exaggeration, or wonder. There is always someone ready to organize, rationalize, bureaucratize, or simply declare impossible whatever he says. And he answers by doing exactly the opposite: inventing more, exaggerating more, dreaming farther.
Perhaps that is why the film has aged so well for me. When I first saw it, what stayed with me were mainly the impossible adventures. Today, what remained was this almost stubborn defense of imagination.
There is a particular beauty in the idea that not everything has to be literal in order to be true. The Baron lies, embellishes, distorts, turns every event into an epic, yet there is a strange sincerity inside those lies. Sometimes an impossible story can say more about fear, courage, old age, friendship, or desire than a perfectly rational account of the facts ever could.
And the film is never ashamed to play. That may be what I admire most about it. It does not try to justify its fantasy, does not apologize for the absurd, and feels no need to make everything plausible. A person can travel on a cannonball, speak with the Moon, or escape from inside a sea creature because, in that universe, imagination itself is reason enough.
Rewatching The Adventures of Baron Munchausen after so long felt like rediscovering a part of childhood that had remained intact somewhere. Only now, beneath the enchantment, I could also see a certain sadness.
Perhaps every adult carries a little Munchausen inside, trying to convince the rest of the world that there are still marvelous things out there.
And perhaps the real danger is the day we stop believing him.

Read more

Pablo Murad pablomurad.com

Explaining LazyLogin

It's hard to keel a private tracker alive...

—>Two Clocks

I built a system to keep web accounts alive. The difficult part was not automating access. It was discovering that the clock that actually mattered was not the one I was feeding, and making sure the tool itself would never become the reason an account was lost.

The problem starts out as something trivial. Some services delete accounts due to inactivity. You disappear for a few weeks, an automated routine marks the account as abandoned, and something that took years to build disappears without warning. Multiply that by a few dozen accounts, each with a different tolerance window, and you get a task humans are particularly bad at: remembering to visit things at irregular intervals, indefinitely.

The solution seems obvious: a script that logs in every now and then. That is how it started. What follows is a record of what this naive version got wrong, and the decisions that remained after each mistake.

Why not use HTTP requests

The first temptation is the cheapest one: an HTTP library, a POST to the login form, a saved cookie. It works for a couple of weeks and then starts failing in ways that produce no error message.

The reason is that an HTTP client does not look like a browser at any layer. The TLS handshake fingerprint is different. There is no JavaScript engine, so any challenge that requires executing code dies immediately. Headers arrive in the wrong order, without the client hints that a real browser sends. None of this is detected by accident. It is exactly what anti-bot systems measure.

So I run a real browser. That solves an entire category of problems and creates a new one: automated browsers also announce themselves.

Headless is what gives it away

The obvious choice would be to run the browser in headless mode. I measured what that costs:

headless (default)          →  ...HeadlessChrome/150.0.0.0...
headless + --headless=new   →  ...HeadlessChrome/150.0.0.0...
headful                     →  ...Chrome/150.0.0.0...  (clean)

Headless mode writes HeadlessChrome directly into the User-Agent, and no flag removes it. I tested the newest mode specifically because of this. It is the cheapest automation signal imaginable: a string comparison.

The previous version of the system worked around this by rewriting the User-Agent and patching properties of the navigator object with injected JavaScript. I removed all of that, and this became one of the most counterintuitive decisions in the project.

A patched getter is more detectable than the value it hides. It fails a toString() test, and a manually written User-Agent has to remain consistent with a dozen properties derived from it.

The alternative is almost stupidly simple: run a real headful browser, with the window positioned at -32000,-32000. Nothing appears on the screen, and the fingerprint is authentic because nothing was forged: real User-Agent, real client hints brands, real plugin list, real compositor. Invisible by construction, not by disguise.

Inside a container, the same idea becomes even cleaner. I use a virtual display with Xvfb, and the browser is headful on a monitor that does not exist.

The leak no JavaScript patch can reach

Popular automation libraries communicate with the browser through a debugging protocol, and some calls made through that protocol are observable from inside the page. One of them, used to obtain execution contexts, leaves a trace that any serious detection system can look for.

No amount of injected JavaScript can hide this because the leak happens at a lower layer. I solved it by replacing the library with a compatible fork that removes this call and uses isolated contexts instead.

Two practical consequences came from this, both discovered painfully. First, the fork disables the console API, so page.on("console") becomes silent and debugging has to rely on error events and response codes. The second is more treacherous: the fork is a separate package with its own exception classes. An except TimeoutError imported from the original library will never match a timeout produced by the fork, turning a recoverable wait into a permanent failure without making the reason obvious. I stopped importing concrete exception types and started identifying timeouts by the class name.

The discovery that turned the project upside down

This is the finding that changed everything, and it only appeared because I read the source code of the platforms instead of assuming how they worked.

One of the platforms most commonly used by these services decides what to delete by reading a column called last_login. That column is written only during an authentication event. Browsing the site with an already valid session updates a different column, one that the deletion routine never reads.

The implication is brutal for a system like this. My architecture prioritized reusing saved sessions specifically to avoid unnecessary logins. But reusing a session keeps the site working without postponing deletion. The tool could have reported success every week, with everything green, until the account simply disappeared.

My answer was to separate two clocks for each account: one for visits and another for authentication. Frequent visits keep the session warm and satisfy platforms that count page access. A real periodic login satisfies the ones that only count authentication. Each service has its own interval, derived from the actual tolerance window of that platform.

There is also a useful asymmetry here: visiting frequently reduces the number of logins, because a session that never goes cold never needs to be recreated. Cheap traffic replaces an expensive operation.

What the system refuses to do

This is the core of the project, and the part that shaped the code more than anything else.

The greatest risk of a tool like this is not failing to visit. It is getting the account locked while trying. Failed login attempts are the currency that produces IP blocks. By reading the authentication controllers of these platforms, I found concrete limits. One blocks an IP for hours after roughly half a dozen failures within 24 hours, and for an entire day if more than one different username is attempted from the same address. Another family issues a six-hour ban after six failures, escalating eventually to a permanent ban.

Since all accounts leave through the same address, one naive behavior could lock dozens of them at once. The previous version of the code had exactly that behavior: a loop that tried username variations until one worked.

The rules that survived are:

  • One attempt per service per execution. No internal retry loop.
  • Never vary the username. The configured value is used literally, once.
  • Authentication errors are terminal. Rejected credentials, banned account, captcha blocking access, all of these stop that service for the current execution.
  • Progressive backoff. After consecutive failures, the interval grows: 6h, 24h, 72h, one week.
  • Free block probing. One platform simply does not render the login form while the IP is banned. Checking for that costs zero attempts.
  • A login ceiling per cycle. After a long shutdown, almost everything appears to need renewal at the same time. A limit spreads this across several cycles.
  • Rejected credentials stay marked. A password that the service has already rejected is not attempted again because that would be a guaranteed failure. The marker stores a fingerprint of the password and clears itself automatically when the password changes.

Knowing the platform instead of guessing

Almost all of these services run on one of roughly half a dozen known platforms, and each has its own field names, two-factor flow, and session markers. Guessing generically produced the worst kind of error: “I could not confirm the login,” without explaining why.

I started using a recipe for each platform. The differences matter more than they seem:

  • In one family, the second factor appears on a separate page, and the field submits automatically after receiving six characters. Filling it and then clicking submit as well causes a duplicate POST that repeats an already consumed code.
  • In another, the second factor is inside the same login form. The code has to be entered before the single submission, and an expired code is indistinguishable from a wrong password.
  • One platform uses uid and pwd where all the others use username and password.
  • Another includes a captcha trap: an invisible field that has to remain empty, plus a timestamp from when the page loaded. Filling every field on the page, or submitting instantly, gives the automation away.

State detection also stopped being binary. Instead of “logged in or not,” I classify each page as: valid session, login form, second factor, captcha, edge challenge, invalid credentials, attempt limit, banned account, maintenance. The reason determines the next step, and the difference between stopping and insisting.

Captcha and the connection nobody mentions

For interactive challenges, my first option is not a paid solving service. It is clicking the actual widget, inside my own browser.

That is free, but the real reason is something else. The clearance cookie issued by these systems is tied to the outgoing IP address and to the exact User-Agent that obtained it. A token obtained by an external service is born in another browser, on another machine, and is rejected on the first request. The session needs to be born in the browser that will actually use it.

The same rule governs human intervention. When something requires a person, I do not ask them to log in through their own browser and then copy the cookie. I expose the container’s own browser through a remote window, and the person logs in inside that browser. The session is born in the correct place, with no transplant involved.

Scheduling on a computer that sleeps

The system runs on a desktop, not a server. It hibernates, restarts, and sometimes stays powered off for days. A scheduler built around “sleep until the next scheduled time” loses every scheduled event that passes while the machine is offline.

So there is no scheduled sleeping. Each service stores its next visit date on disk, and every few minutes the loop asks a single question: what is overdue? A week with the computer powered off results in a recovery burst, not a week of permanently missed visits.

I added two refinements on top of this. Initial dates receive a stable offset derived from the name of each service, so one third of the fleet becomes due each day instead of everything at once. It becomes a trickle rather than a flood. Accounts that have already passed their tolerance window skip this politeness and are visited immediately. Two days of politeness are not worth a lost account.

Five incidents that were expensive

It is worth recording the errors that only appeared during execution, because four of the five would survive an ordinary code review.

An await inside a generator expression

Symptom

Every service failed with:

TypeError: 'async_generator' object is not an iterator

with no useful clue about the origin.

Cause

An await inside a generator expression turns it into an asynchronous generator. The any() consuming it called next() and exploded. A single line that compiles, imports, and looks perfectly reasonable.

Fix

I moved the await into a variable before the comprehension, then wrote a static AST checker that detects this pattern, along with coroutines created without await, which can fail in complete silence.

Windows line endings in a shell script

Symptom

The container kept dying with:

/entrypoint.sh: No such file or directory

for a file that was demonstrably inside the container.

Cause

A tool running on Windows converted the line endings, turning the shebang into:

#!/bin/sh\r

The kernel was looking for an interpreter whose name ended with a carriage return. The missing file was the interpreter, not the script.

Fix

I normalize the file and convert the line endings during the build, so the origin of the editing environment no longer matters.

The browser remembered where the window was

Symptom

Manual sessions opened, loaded, and remained invisible. The remote screen showed nothing.

Cause

The browser stores its last window position inside the profile. Since automatic visits park the window outside the screen, all profiles eventually remembered that position. The visible window was therefore born hidden, even without the positioning flag.

Fix

I explicitly force the window position in visible mode, overriding whatever the profile remembers.

Two instances fighting over the same profile

Symptom

TargetClosedError when opening the profile, immediately after a previous session ended.

Cause

The browser does not release the profile directory lock the instant the context closes. A check launched immediately afterward found the profile still locked and fell back to a disposable context, losing exactly the continuity that the persistent profile exists to provide.

Fix

I wait a few seconds and try the persistent profile again before considering the fallback.

Filling credentials was causing the failures

Symptom

Several services rejected passwords that worked perfectly when typed elsewhere.

Cause

Two things happened at the same time. The system pre-filled the fields before handing over the window. When I typed over them without clearing the values first, the strings were concatenated. And when the stored password was outdated, automatic submission generated a real failed login attempt, exactly the currency that produces IP blocks.

Fix

I never automatically fill credentials during a manual session. An explicit button writes the credentials into the DOM when requested. This also works around the remote session keyboard mapping, which can occasionally produce a different character from the one typed.

What this taught me

Three things happened often enough to become principles.

An honest fingerprint beats a forged one. I removed almost all of the “stealth” the system originally had, and it became more robust. A Linux browser saying it is Linux is safer than a fake and internally inconsistent Windows browser. A partial disguise is worse than no disguise at all.

Evidence beats assumption. The decisions that mattered most came from reading the source code of the platforms and measuring real behavior, not from accumulated reputation in forums. The discovery of the two clocks was sitting in a public configuration file that nobody had any particular reason to open.

The job of the tool is not to lose the account. Visiting is easy. All the engineering, the attempt limits, progressive backoff, error classification, and refusal to insist exists for the moment when something goes wrong. A maintenance tool that destroys what it was supposed to preserve is worse than having no tool at all.

Read more

Pablo Murad pablomurad.com

Movie: Pink Flamingos

"The Triumph of Bad Taste"...

Watching Pink Flamingos today is still a strange experience. The film is more than fifty years old, its most famous scenes have circulated for decades, and John Waters has gone from being a marginal filmmaker to something close to an American cultural institution. Even so, the movie still carries a feeling that very few films manage to preserve for that long: the sense that this thing should not exist. Not because it ought to be banned or censored, but because it feels like something that slipped through a crack in film history and reached us without asking anyone’s permission.

John Waters

Released in 1972, Pink Flamingos has a deliberately absurd story. Divine plays Babs Johnson, a criminal hiding with her family in a trailer outside Baltimore. She enjoys a very particular reputation: she is considered the filthiest person alive. Trouble begins when Connie and Raymond Marble decide to challenge her for the title. From there, Waters builds an escalating competition involving depravity, dirt, crime, humiliation, and increasingly unbelievable behavior. Describing the plot this way almost makes the film sound more organized than it really is. Pink Flamingos works less like a conventional narrative and more like a series of challenges thrown directly at the viewer.

What surprises me about the film is that its vulgarity stops feeling gratuitous once you understand the game Waters is playing. Vulgarity is the language of the movie itself. The film does not use bad taste to spice up an otherwise conventional story. Bad taste is the story, the aesthetic, and almost a philosophy. Everything that would normally be hidden, treated as shameful, or kept away from the camera is pushed to the center of the frame and presented as spectacle. Waters understood very early that one of the most effective ways to attack the codes of respectability was not to prove that his characters were secretly normal. They do not want to be normal. In fact, they would probably consider that a defeat.

That is essential to understanding Divine. Harris Glenn Milstead is not playing a character who wants to be accepted by the world around her. Divine takes up space as if that world already belongs to her. Her makeup is excessive, her eyebrows seem designed to challenge every known sense of proportion, her forehead is enlarged by the shaved hairline, and her dresses make no attempt to disguise or soften her body. Everything is exaggerated on purpose. At a time when the image of a drag queen would barely have appeared at the center of a feature film, Waters did not make Divine a side character, a joke, or a victim. She is the absolute star, and nobody in the film seems to possess enough authority to question it.

There is something remarkably modern about that choice. Many films dealing with marginalized people try to win the viewer’s sympathy by showing that, deep down, these characters share the same values as the society that rejects them. Waters does exactly the opposite. His characters seem to say that they have no interest in proving anything. If they are considered vulgar, they will become even more vulgar. If they are called degenerates, they will compete to see who can take degeneracy furthest. There is a logic of reclaiming the insult that runs through the entire film. What should produce shame becomes a source of pride.

The poverty of the production strengthens that feeling. Pink Flamingos cost around ten thousand dollars and was shot on 16 mm with a group of Waters’s friends and collaborators, many of whom became known as the Dreamlanders. The movie looks cheap because it really was cheap. The lighting is uneven, the performances are exaggerated, the framing can be strange, the sound is imperfect, and there are moments when it resembles a home movie made by people with more enthusiasm than money. Curiously, that lack of polish became one of the film’s greatest strengths. If Pink Flamingos had been technically immaculate, it would probably have lost much of its power.

Divine

Today it is common to see independent productions trying to manufacture an underground look. Digital grain is added, sound is distorted, VHS or Super 8 textures are imitated, and filmmakers deliberately chase the appearance of found footage. Waters did not need to simulate any of that. He was actually making cinema on the margins, far from the major studios, working with people from his own circle and filming in Baltimore, a city that would become almost a recurring character in his work. The material poverty is not hidden. The film seems proud of it.

It is also important to understand Pink Flamingos as a product of midnight movie culture. The film found its audience in that circuit, especially after it began screening at the Elgin Theater in New York. Midnight movies created a very particular kind of cinematic experience. People went because they had heard stories about a strange, forbidden, disturbing film, or simply something impossible to find in conventional theaters. Word of mouth was part of the experience. In a time without social media, without clips circulating instantly, and without detailed lists explaining every shocking scene before you saw it, walking into a theater to watch Pink Flamingos must have felt almost like an initiation.

The film remained in circulation for long stretches within that circuit and became a genuine cult phenomenon. That is especially interesting because it was not made to conquer a large audience. Its strength came from exactly the opposite. Waters found people who recognized themselves in that refusal of respectability. There were gay people, artists, punks before punk, bikers, freaks, students, people bored with conventional cinema, and all kinds of people who did not see themselves represented in more respectable entertainment. The theater itself became a meeting place for people who, in one way or another, also lived outside the center.

That is why I think it is too simple to call Pink Flamingos merely a shocking film. Shock is easy. Any filmmaker can show violence, sex, or something disgusting. Waters does something more intelligent because he turns shock into a method. He understands that standards of good taste are also a form of control. They determine which bodies may be shown, which forms of sexuality may be considered acceptable, which behaviors can appear without punishment, and even what a film is supposed to look like before anyone agrees to take it seriously. Pink Flamingos takes those rules and runs over them with enormous pleasure.

That does not mean everything has aged well. Some scenes are genuinely difficult to watch, and others cross lines that would be treated very differently today. There is animal cruelty, uncomfortable sexual material, and a series of provocations that do not need to be defended simply because the film is important. A worthwhile criticism of the movie should not turn every Waters excess into automatic genius. Some of the film works because it is funny, some because it is daring, some because it matters historically, and some of it is simply horrible. That mixture is part of its identity.

There is also something almost childish in Waters’s sense of humor. Behind his reputation as a great provocateur, many of the jokes in Pink Flamingos have something of a child discovering that saying the forbidden word at the dinner table makes the adults horrified. The difference is that Waters took that game much further and built an entire aesthetic around it. The pleasure lies in finding out how far a situation can be pushed before somebody leaves the room. That mischievous quality is one of the reasons the film manages to be both repulsive and very funny.

Among the most famous pieces of trivia is the fact that Divine and John Waters had been friends since they were young and developed the character together until she became an icon. Waters encouraged an image that was deliberately grotesque and monumental, very different from the polished femininity many drag queens of the period were pursuing. Divine was supposed to look larger than life. Their collaboration would continue through several films and eventually reach much more widely known productions such as Hairspray in 1988, shortly before Divine’s death.

Babs’s family also deserves attention because it perfectly concentrates Waters’s universe. Edie, played by Edith Massey, is practically obsessed with eggs and spends much of the film inside a playpen. Crackers, Divine’s son, has an equally peculiar relationship with sex and violence. Cotton, played by Mary Vivian Pearce, watches everything with a kind of elegant enthusiasm. These characters do not feel as if they were written to represent plausible people. They work almost like figures in Waters’s private circus, each one defined by a particular obsession.

And then there is the final scene, probably one of the most famous moments in underground cinema history. Divine finds freshly deposited dog feces and eats them in front of the camera. There is no trick. Waters and Divine confirmed many times that it really happened. The scene became so notorious that it practically developed an existence independent of the film itself. It is grotesque, certainly, but it also works as the logical conclusion of everything that came before. After spending roughly an hour and a half competing for the title of filthiest person alive, Divine has to prove that nobody can surpass her. Waters ends the film by doing precisely the thing the viewer may still have believed he would not dare to do.

What is curious is that the scene followed Divine for the rest of her career. Waters has recalled in interviews that journalists kept asking about it for years. There is something both tragic and funny about that. Divine was an extraordinarily charismatic performer, had an unusual screen presence, and would later demonstrate the ability to work in very different registers, but that single image remained attached to her name. It is also a demonstration of the extraordinary power a cinematic image can acquire when it goes beyond what the audience believes is possible.

The revolutionary character of Pink Flamingos lies precisely in this willingness to create its own rules. Waters was not trying to sneak into Hollywood through the back door. He was building a different house. The film showed that it was possible to make cinema with very little money, with friends, far from the traditional centers of the industry, and with characters who would never have been considered acceptable protagonists by a studio. More importantly, it showed that there was an audience for it.

Its influence can be felt across much of the queer, punk, trash, camp, and independent cinema that came afterward. Waters helped demonstrate that bad taste could be a conscious aesthetic choice rather than simply a sign of incompetence. That distinction may seem obvious today, but it became fundamental to countless artistic movements that followed. Whenever a contemporary film deliberately embraces excess, grotesquerie, vulgarity, and artificiality as part of its identity, there is a road leading back somewhere near Baltimore.

I also love the way Pink Flamingos destroys the idea that transgressive cinema has to be dark and solemn. Waters is having fun. There is joy in the chaos. Even when the movie is disgusting, it rarely feels miserable. Its characters live in an absurd world, but there is something almost celebratory about their energy. That separates it from a lot of provocative art that treats suffering and seriousness as automatic proof of depth.

Perhaps that is exactly where its greatest strength lies. Pink Flamingos does not want to teach the viewer how to become a better person. It does not want to offer a comforting moral lesson, and it makes no attempt to justify its own existence. It simply claims the right to exist exactly as it is: vulgar, cheap, obscene, funny, offensive, queer, excessive, and completely in love with its own lack of good sense.

It is a film that managed to turn everything that should have been its greatest weakness into its main strength. The miserable budget became an aesthetic. The eccentric actors became icons. Vulgarity became a language. Marginality became an identity. Even the word “filth,” which should have worked as an insult, becomes a kind of honorary title.

That is why Pink Flamingos remains so important. Not because everyone should like it, and certainly not because everything shown in it should be celebrated. Its importance lies in proving that cinema could exist outside good taste, outside respectability, and even outside what was considered minimally acceptable.

John Waters took everything that should have prevented a film from being taken seriously and turned it into the very reason we are still talking about it more than half a century later.

And perhaps that is the greatest joke in Pink Flamingos: a film made to be considered trash ended up becoming part of film history.

Read more

Pablo Murad pablomurad.com

Keep the tracker account alive

Private tracker accounts can take years to build. Invitation, ratio, history, reputation. And yet they can still disappear for something as trivial as simply not showing up for a few weeks.

Almost all of these sites run some kind of automated routine to disable or remove inactive accounts. The window varies from tracker to tracker, sometimes a month, sometimes a few months, and there is rarely any warning beforehand. The problem is not losing access to a catalog. It is losing something that took time to earn and that, in many cases, cannot simply be recovered.

When you have one or two accounts, remembering to log in every now and then is easy. When you have dozens, each with its own rules and deadlines, things change. You start relying on memory, calendars, and discipline to perform, indefinitely, a repetitive and completely uninteresting task. Exactly the kind of thing humans forget and machines do very well.

screenshot of the software

What it does

The program opens a real browser, logs into the tracker, and spends a few minutes browsing normally, just as any visitor would.

It does not simulate downloads, fake seeding, manipulate ratio, or manufacture activity that never happened. The only thing it automates is the act of showing up.

Each tracker has its own rhythm, based on the actual rules of that site, and the system keeps two separate clocks: one for visits and another for authentication.

That distinction seems minor until you look at how these platforms actually work.

By reading the source code of some of them, we found that many only reset the inactivity counter when a real login occurs. A saved session can keep working perfectly for weeks, but that does not necessarily mean the tracker considers the account active.

A tool that ignored this detail could spend months reporting that everything was working while, quietly, the deletion deadline kept getting closer.

What it avoids

The most important part, oddly enough, is not getting into the sites. It is knowing when not to try.

A failed login attempt can turn into an IP block, and when several accounts are coming from the same address, insisting is probably the worst possible strategy. A small mistake repeated dozens of times stops being small very quickly.

That is why the system does not keep experimenting.

It makes one attempt per site, never starts trying username or password variations, stops immediately when a credential is rejected, and progressively increases the delay after a failure.

If it encounters something that requires a person, such as a CAPTCHA, two-factor authentication, or an unexpected page, it simply stops and alerts me.

There is no heroic attempt to force its way through the obstacle.

The goal was never to visit every tracker at any cost. It is much simpler than that:

the program should never be the reason an account was lost.

Read more

Pablo Murad pablomurad.com

Movie: La migliore offerta (The Best Offer)

I loved The Best Offer, but not exactly for the reason I expected when I started watching it. For much of the film, I was caught up in the anticipation. There is something strange from the very beginning, a feeling that some mechanism is working behind the walls and that, at some point, all those little pieces are going to fall into place. The film knows this and plays with us constantly. A door that will not open, a woman who never appears, pieces of an old machine discovered one by one, conversations that seem to be hiding something. Everything keeps feeding that uneasy certainty that there is an answer waiting somewhere.

Virgil Oldman is a wonderful character precisely because he seems to have spent his entire life trying to eliminate any possibility of surprise. He understands the value of things, recognizes forgeries, knows how to notice details that others miss, and has turned his own existence into a kind of perfectly organized collection. Even his relationship with women exists in a safe, silent, motionless form, through those portraits hidden in his secret room. Women who cannot reject him, abandon him, or disappoint him. They simply remain there.

Then Claire appears.

And perhaps that is why the entire first half worked so well for me. It is not just the mystery of who she is or why she hides. It is watching a man who has spent his whole life protected by his own sense of control slowly begin to desire something he cannot appraise. Virgil knows how to determine whether a painting is worth millions, he can recognize the hand of a forger, he can look at a work of art for a few seconds and notice what everyone else has overlooked. But when he has to assess a person, he becomes almost childlike.

There is a cruel irony in that. He built his life around the idea of authenticity, only to end up unable to recognize what is false when it finally matters.

As I watched, I wanted answers. I wanted to know what was behind that wall, who Claire really was, why Robert seemed so willing to help him, what those mechanical pieces meant, how far Billy was involved in the whole thing. It is the kind of film that makes you start suspecting everyone while, at the same time, desperately hoping your suspicions are wrong. You notice some things, doubt others, but there is a kind of irrational hope that the film will not destroy what Virgil has finally found.

And then it does.

What struck me most about the ending was not the revelation. It was the emptiness.

When everything is over, there is none of that comfortable satisfaction of a puzzle finally solved. The pieces do fit together, yes, but what they form is something horrible. Virgil returns to that room with his portraits and finds the walls empty. That scene hit me harder than any explanation ever could. They did not just steal his collection. They stole the entire structure upon which he had built his existence.

And there is something particularly perverse about the fact that they managed to do it only after making him lower his defenses. At the beginning, Virgil is an unpleasant man, arrogant, cold, methodical. Slowly, however, we see something emerge in him that probably never existed before. He becomes ridiculous, insecure, in love, jealous, happy. For the first time, he seems truly human. And it is precisely this newly discovered humanity that allows him to be destroyed.

That is where the film stops being merely a story about a con.

If it were simply a story about people deceiving a wealthy man in order to steal his collection, it would be clever, perhaps even entertaining, but it would end with the revelation. What remains afterward is much worse: the doubt over whether everything he experienced was entirely false.

Because a lie can produce a genuine emotion.

Claire may have been playing a role. Robert may have helped construct that world. Billy may have known more than he let on. The coincidences may have been carefully manufactured. And yet, what happened inside Virgil was not an act. His love existed. His fear existed. His happiness existed. His transformation existed.

Perhaps that is the most beautiful cruelty of The Best Offer. Virgil, who spent his life distinguishing originals from forgeries, ends up discovering in the worst possible way that the two can become intertwined. A forgery can contain some truth, while something that seems absolutely genuine may have been constructed to deceive.

And then comes that ending.

Virgil waiting.

That destroyed me.

After everything, he still leaves an empty chair. There is still a small possibility inside him that Claire might appear. Maybe he knows she will not. Maybe he understands perfectly well what they did to him. But he waits.

I did not feel angry when the film ended. Nor did I feel that satisfaction of thinking, “now I understand everything.” I felt a very strange sadness, almost physical. A silence. Like walking into a house where someone lived for decades and discovering that all the furniture has been removed.

It is rare for a film to end and leave you with a feeling that is not surprise, joy, sadness, or outrage, but absence.

That is what The Best Offer left me with.

First, two hours of anticipation. The constant feeling that there was something just beyond the next door, the next conversation, the next piece to be found.

Then, finally, the answer.

And when it comes, you realize you would rather have kept waiting.

Read more

Pablo Murad pablomurad.com

Movie: Dario Argento's Opera

I just finished watching Dario Argento’s Opera in the middle of the night, and perhaps, without meaning to, I chose the perfect time to watch it. There are horror films that work under almost any circumstances, on some ordinary afternoon, playing on a television while life goes on around you. Opera does not strike me as one of them. This is a film to watch when the house has already gone quiet and there is not much left between you and the screen. Perhaps because the whole idea of the film revolves around exactly that: looking. Looking even when you no longer want to. Being unable to turn your eyes away. And Argento, of course, found the cruelest possible image to turn that idea into cinema.

The film was released in 1987 and follows Betty, played by Cristina Marsillach, a young soprano who unexpectedly takes on the role of Lady Macbeth in an unconventional production of Verdi’s opera. The leading singer has an accident, and what should have been the great opportunity of Betty’s career quickly turns into a succession of murders. A masked man begins stalking her and develops a particularly perverse ritual: he restrains Betty and fixes tiny needles beneath her eyes, so that closing her eyelids means injuring herself. She has to watch.

It is an image as simple as it is monstrous. Probably one of the most powerful images in Argento’s entire filmography. And the more I think about it, the less I believe it is there simply because it is disturbing. Betty is forced to do exactly what we willingly do while watching an Argento film. We sit down and watch people being chased, cut, pierced, crushed. We can look away, of course, but we know perfectly well that we came precisely to look. In Opera, Argento takes that escape away from us. He turns the spectator within the film into a prisoner of the spectacle itself. The British Film Institute also draws attention to this self-reflexive quality of the film, seeing it as a meditation on voyeurism, violence, cinema, and Argento’s own position as an auteur. According to the BFI’s retrospective notes, the idea of the needles was even connected to a joke Argento had made about viewers who looked away during the violent scenes in his films.

I found that brilliant because Argento never apologizes for the visual pleasure that exists in his cinema. Quite the opposite. The murders in Opera are horrifying, yet they are filmed with an almost indecent beauty. There are shots that would probably make extraordinary photographs if removed from their context. Ronnie Taylor’s camera does not behave like a polite observer. It slips through gaps, glides down corridors, moves close to eyes, crosses spaces, and constantly seems to be searching for something. At one point it even assumes the point of view of the ravens flying inside the theater. The circular movement above the audience is absurdly beautiful. Argento could simply have shown the birds searching for the murderer. Instead, he decides that for a few seconds we will become the birds. The camera flies.

It is exactly this kind of choice that makes me like him so much. Argento does not seem particularly interested in filming a story in the most efficient way possible. Sometimes I get the impression that the story exists only because he needed something to connect one extraordinary image to the next. And that should be a flaw. With many directors, it would be. Here, it almost never is. There are moments in Opera when the narrative logic becomes strange, characters make questionable decisions, and certain things happen with a rather generous degree of convenience. But five minutes later Argento presents such a wonderful visual idea that I simply stop caring. The film establishes its own logic, and it is much closer to the logic of a nightmare than that of a police investigation.

Perhaps that is why the choice of Macbeth is so perfect. The theater already feels haunted before the murderer even enters the story. There is a centuries-old superstition in the theatrical world surrounding the play, and Argento makes use of it without turning the film into a conventional supernatural story. Curiously, there is something autobiographical in all of this. The origins of Opera are connected to Argento’s own experiences with the world of opera, and the fictional director Marco, played by Ian Charleson, is himself a horror filmmaker who decides to direct Macbeth. The parallel could hardly be clearer. The BFI even considers Marco a kind of stand-in for Argento within the film itself.

I also loved the complete lack of ceremony with which the film mixes what would normally be separated into “high” culture and popular culture. We have Verdi, a grand Italian theater, monumental sets, and all the solemnity of opera. Then a heavy metal guitar comes crashing in while someone is being brutally murdered. In less confident hands, this could easily become ridiculous. Here, it feels almost like a statement of principle. The soundtrack mixes Verdi and Puccini with music by Claudio Simonetti, Brian Eno, Roger Eno, Bill Wyman, and other collaborators. There is absolutely no concern with making these things coexist politely within the same universe. Argento simply puts them together because, to him, they belong together.

There is one particular scene I doubt I will ever forget, involving a door and an eye. I do not want to turn it into an anatomical description because part of the pleasure lies precisely in seeing it without being prepared. What impressed me was the precision of its construction. Argento stretches the moment to its limit, allows the viewer to understand exactly what might happen, and then makes it happen in a way even more exaggerated than I had imagined. It is grotesque, beautiful, and funny in a very strange way. Argento’s violence often has this quality. There is something so elaborate about it that it goes beyond realism. It does not seem as though he wants to convince you that you are watching a real murder. He wants to construct an image that is impossible to forget.

And eyes are everywhere. Human eyes, eyes peering through a hole in a door, terrified eyes, animal eyes, the reflection of the theater in the eye of a raven. Once I noticed this, the entire film began to feel organized around the act of seeing. Even the ravens function as witnesses. They saw something. The murderer saw something. Betty saw far too much. We are seeing everything. Suddenly those needles stop being merely the sadistic invention of a murderer and begin to summarize the entire film.

Cristina Marsillach works extremely well precisely because Betty is not a horror heroine in the modern sense. She seems small in the face of everything happening around her. Frightened, confused, at times strangely passive. Normally I would complain about that, but here her vulnerability helps. She is someone being dragged through a nightmare whose logic she still does not understand. And Argento seems less interested in the character’s psychological growth than in her face while she watches. That matters. Betty’s face is practically a screen within the screen.

Some people consider Opera the last truly great film of Argento’s classical period. The BFI itself makes exactly that argument, placing the film as a kind of culmination of the extraordinary run that began with The Bird with the Crystal Plumage in 1970. After watching it, I completely understand why. There is something definitive about it. The fascination with animals, the obsession with looking, the gloved killer, the impossible camera, the almost ornamental violence, the aggressive use of music, and that very particular boundary between elegance and vulgarity. It feels as if several of Argento’s obsessions decided to appear in the same film one last time at full strength.

I do not think Opera is perfect, and I probably like it even more because of that. The screenplay has its peculiarities. The final explanation lacks the elegance of the best images that came before it, and the last part of the film takes a direction that will certainly divide people. But I cannot judge a film like this solely by the mechanics of its plot. That would be like complaining about the architecture of a cathedral because one of its doors squeaks. What stayed with me after the credits were images, sounds, and sensations.

Perhaps this is exactly the kind of Argento cinema I love most. It does not end when the story ends. Something remains. A corridor, a blade, a piece of music that feels out of place, the impossible movement of a camera, an eye that cannot close.

It is past three in the morning now, and I am still thinking about the needles.

I think that is enough to say the film worked.

Read more

Pablo Murad pablomurad.com

Software as Culture: Demoscene

There is a slightly annoying tendency to treat software as nothing more than a tool. One program edits a photo, another calculates a spreadsheet, another plays music, another controls a server. Within that logic, good software is useful software, fast, secure and, with any luck, does not ask you to create an account before showing you the main screen.

But computers have never been just tools. Ever since they started falling into the hands of curious people, someone has inevitably tried to find out what else could be done with them. Not because there was a client waiting, a business problem to solve or an investor asking for 30% growth next quarter. Sometimes the motivation was much simpler: "I want to see if this machine can do that."

That spirit gave birth to one of the most fascinating subcultures in the history of computing: the demoscene.

For someone who has never seen a demo, the first impression can be misleading. It looks like an electronic music video or a 3D animation accompanied by music. Except it is not a video. The file you are running is a program, and the computer is generating graphics, effects, movement, music and animation in real time. Assembly, one of the historic institutions of the Finnish scene, describes demos precisely as self-contained programs that generate audiovisual presentations while they run. (demoscene.assembly.org)

So far, fair enough. Any modern computer can render fairly impressive things. What makes the demoscene special is something else: much of this culture was built around limitations.

And when I say limitations, I do not mean "it has to run on a laptop with 8 GB of RAM."

I mean making an entire audiovisual presentation fit inside 64 KB.

Or 4 KB.

Or 1 KB.

There are people who look at a limit of 4096 bytes and conclude that there is enough room in there for a three-dimensional landscape with a soundtrack.

Those are exactly the kind of people who make me like computers.

Before demos, there were crackers

The origins of the demoscene are not in digital art schools or university computer graphics departments. They are tied to software piracy in the 1980s, more specifically to groups that removed copy protection from games and programs for home computers.

When a group cracked a game, it was common to add a small presentation before the original program. It would show the name of the group, messages, greetings to other crackers and, as the competition grew, logos, music, scrolling text and graphic effects.

These small presentations became known as crack intros, or simply cracktros.

The fun part is that groups began competing not only over who could crack a program first, but over who could put the most impressive intro in front of it. What started as a signature gradually developed a life of its own. The effects improved, music became more important, programmers began exploiting hardware-specific tricks and, at some point in the second half of the 1980s, that aesthetic competition began separating itself from cracking. Assembly's own history of the scene describes this evolution from crack intros into increasingly elaborate productions, while historical studies place the process precisely around the middle of that decade. (demoscene.assembly.org)

I find that origin especially amusing because it sounds like a story the Internet would invent afterwards.

First someone pirates a game.

Then they put their name on it.

Then they decide that just putting their name there is boring and add some music.

A rival group responds with a better graphic effect.

Another group adds animation.

Before anyone notices, the game has become the least interesting part of the whole thing.

Remove the game.

Keep the intro.

Now you have a new form of digital culture.

And some characteristics of those cracktros are still present today. The scrolltext, for example, that text moving horizontally across the screen, became almost a visual signature of the scene. There are entire studies tracing its evolution from crack intros in 1984 to much more elaborate demonstrations in the years that followed. (widerscreen.fi)

What does a demo actually demonstrate?

The name can cause another bit of confusion because we are used to "demo" meaning a limited version of a commercial program. A trial version, something you use for fifteen minutes before a BUY NOW button appears.

Not here.

In the demoscene, the demo is the finished work.

What it demonstrates, in a sense, is what its creators can squeeze out of the machine.

That changes the way you look at these productions. A Commodore 64 demo is not interesting only because of the image appearing on the screen. Part of the interest comes from knowing that the image is being produced by a computer released in 1982, with roughly 64 KB of RAM and a processor running at around 1 MHz.

This is where programming and artwork begin to merge.

The hardware stops being a neutral platform. It becomes part of the work.

Someone making a C64 demo knows the VIC-II, the SID, the memory limitations, the graphics modes and the timing peculiarities of the machine. Someone programming an Amiga knows its custom chips and spends an unreasonable amount of time inventing impolite ways of making them work harder. The fun often lies in discovering behaviors that even the original designers probably never imagined anyone would use artistically.

That is why the demoscene continues producing new work for machines that disappeared commercially decades ago. Commodore 64, Amiga, Atari ST, ZX Spectrum and Amstrad CPC are not treated merely as museum pieces. They remain creative platforms. The German commission associated with UNESCO even highlights size-coding, the practice of reducing programs to extremely small sizes, as one of the core skills of demoscene culture. (unesco.de)

That creates a relationship with the computer that I find much more interesting than simply replacing a GPU every two years.

The machine has a personality.

It has flaws, limits, tricks, strange timings and things that "should not work."

Then someone makes them work.

64K, 4K and the art of having no room

Probably the most impressive entry point into the demoscene is the world of size-limited intros.

A 64K intro has to fit within approximately 65 thousand bytes. A 4K intro gets 4096 bytes. Depending on the competition, there are categories for 1K, 256 bytes and other similarly unreasonable sizes.

Naturally, nobody is stuffing dozens of megabytes of textures into 4 KB using some magical ZIP format unknown to humanity.

The trick is not storing things ready-made.

You store ways of producing them.

A texture can be generated mathematically. A three-dimensional object can be built from functions and geometric operations. Music can be created by a tiny synthesizer during execution. Shaders generate images procedurally. Noise, fractals and mathematical functions replace data that would normally occupy huge files in a conventional project.

There is something almost absurdly beautiful about this approach because it reverses a very common tendency in modern computing. Today we have cheap storage, gigabytes of RAM and monstrous processors. It is perfectly normal to download hundreds of megabytes to install an app that, in the end, displays a to-do list.

The demoscene comes from another planet.

There, someone asks how much they can remove before the thing stops existing.

One production that became particularly important in this history was fr-08: .the .product, by the German group Farbrausch. It won the 64K Intro competition at The Party 2000 and became a landmark for its use of procedural generation and real-time sound synthesis. Demozoo even records the use of the V2 synthesis system and a procedural tool that preceded the group's famous werkkzeug. (demozoo.org)

Then there is Elevated, created by RGBA and TBC and presented at Breakpoint 2009.

Elevated shows a three-dimensional mountain landscape, with terrain, atmosphere, camera movement and music.

Maximum size for the category: 4 KB.

It won the competition. (demozoo.org)

4096 bytes.

That is the kind of number that should be printed on signs at the entrance of software development offices, purely to create a little collective embarrassment.

It is not a one-person job

There is also a huge social dimension to the demoscene. Traditionally, participants organize themselves into demogroups, groups with their own names and members performing different roles.

The coder writes the program. The graphician handles the visual work. The musician composes the soundtrack. Depending on the production, there may also be modelers, designers and people building tools, synthesizers, shaders and every kind of specialized component in between.

Members almost always use nicknames, called handles, another inheritance from hacker and cracker culture.

That is how names like Purple Motion, Skaven, Chaos, kb, ryg, Lone Starr, Travolta and many others became recurring credits in classic productions.

The group itself matters too. Future Crew, Spaceballs, Farbrausch, Kefrens, Conspiracy, Andromeda, Fairlight, Haujobb and dozens of other names developed identities of their own over the years.

There was not exactly a formal career waiting for these people. The main prize was reputation.

You made something that impressed other sceners, released it at a party, received votes, won a competition and your handle started circulating.

It is almost a primitive version of online social status, except it predates likes, followers and influencers by decades.

The point was to show skill to people who understood exactly how difficult what you had done actually was.

Personally, I think that is a much more interesting form of digital vanity.

The demoparties

If the scene had consisted only of people sending executables to one another, it probably would never have developed the same identity. A crucial part of the culture is the demoparty, physical gatherings where demos, intros, music, graphics and other productions are presented in competitions known as compos.

Imagine a LAN party meeting a digital art festival, getting drunk with a hackerspace and deciding to organize a creative programming championship.

That is more or less it.

People bring computers, spend days together, finish productions at the last possible moment, watch the entries on a large screen and vote for the best ones. In between, there is music, programming, conversation, old hardware, new projects and, judging from forty years of photographic evidence, reasonably significant amounts of beer.

Assembly, in Finland, began in 1992 and became one of the fundamental events in the history of the scene. Denmark had The Party throughout the 1990s. Norway had The Gathering. Germany later produced Breakpoint, Revision and Evoke. Evoke alone has existed since 1997, with a short interruption in the early 2000s, and still takes place in Cologne. (demoparty.net)

And this is not computer archaeology. In August 2026, as I write this, the Demoparty.net calendar shows events taking place in Germany and Russia, followed in the coming weeks by parties in Germany, Poland, Finland, Sweden and the Netherlands. Assembly Summer 2026 took place only a few days ago, from July 30 to August 2, in Finland. (demoparty.net)

The scene has aged, obviously. Many people who were making demos as teenagers in the 1980s and 1990s are now in their fifties, with children, careers and perhaps alarmingly detailed opinions about lower back pain.

But the culture continues producing new people too.

And the old machines still keep appearing on the tables.

Why Europe?

The demoscene exists worldwide, but spend even a few minutes following its history and you quickly notice that it has a very strong European accent.

Finland, Sweden, Norway and Denmark had enormous scenes. Germany is a historical powerhouse. Poland has a particularly important community, as do the Netherlands, France and several countries across Central and Eastern Europe. The current event calendar still reflects much of that geography. (demoparty.net)

There are good historical reasons for this. Home computers, particularly the Commodore 64, Amiga and Atari ST, created very strong communities in these countries during the 1980s and 1990s. Before the Internet became the nervous system of the planet, software, demos and messages circulated through floppy disks, postal mail, BBSs and physical gatherings.

The scene built its own social networks before we started calling everything a social network.

And this environment eventually had effects far beyond the demoscene itself. The European game industry inherited many people from that world. Remedy Entertainment, for example, openly discusses its roots in the Finnish demoscene. The connection is not difficult to understand: if you spent your teenage years trying to make a PC or Amiga produce impossible graphics in real time, professionally working with computer graphics and videogames is a fairly natural next step. (hackerculture.org)

A few things worth watching

It is difficult to make a list without committing some injustice because we are talking about decades of productions across dozens of platforms. Still, a few demos are referenced so often that they work well as entry points.

Second Reality, by Future Crew, is probably the classic example. It was presented at Assembly 1993, won the PC Demo competition and became one of the best-known productions in the history of the scene. It is pure DOS, unapologetically 1993 in its aesthetics and a lesson in what programmers of that period could do with hardware that today would probably be embarrassed by a supermarket calculator. (demozoo.org)

On the Amiga, State of the Art, by Spaceballs, won the competition at The Party 1992. It is very different from Second Reality. Instead of presenting a sequence of obvious technical demonstrations, it works heavily with dancing human silhouettes, quick cuts and music. It still has a very strong visual personality today. (demozoo.org)

After that, I would go to Desert Dream, by Kefrens, fr-08: .the .product, by Farbrausch, and Elevated, by RGBA and TBC.

I would not treat this as a "Top 5." The fun is precisely to start with a few landmarks and then completely lose control of the situation.

Because there is a good chance you will watch Second Reality on YouTube at eleven at night and, by two in the morning, find yourself downloading an Atari Falcon intro made by someone called Lord Helmet in 1996.

These things happen.

The Internet of the demoscene

Perhaps one of the greatest achievements of this community is how much material it has managed to preserve. Many of its websites look as if they survived from an era of the Web before anyone had heard of design systems, conversion funnels or buttons saying "Start for free," which immediately makes me feel comfortable.

If I were starting today, I would open these:

  • Pouët.net is the public square. It has productions, comments, ratings, screenshots and decades of discussions between sceners. Sometimes you find a historical masterpiece followed by someone commenting "boring." The Internet as it should be.
  • Demozoo is probably the best place for researching the history of the scene. It catalogs demos, groups, people, platforms, parties, competitions, results and credits. The amount of information is absurd.
  • Scene.org works as one of the major pieces of community infrastructure and maintains a huge archive of demoscene files. The organization is also behind, or connected to, several important services within the scene. (scene.org)
  • Demoparty.net maintains the event calendar and is the best way to discover that some obscure demoparty is happening next month in a Finnish town you have never heard of.
  • CSDb, the Commodore 64 Scene Database, is the specific rabbit hole for anyone beginning to develop a slightly unhealthy fixation on the C64.
  • Hornet Archive preserves a huge part of the PC demoscene from 1987 to 1998. For anyone interested in the DOS scene, it is practically a time capsule. (hornet.scene.org)

Interestingly, these sites also reveal something I consider important: the demoscene was never only about consuming digital art. There is an obsessive record of who did what, which group released it, at which party, what position it achieved and which machine it was made for.

Authorship matters a lot.

Perhaps because when a 4 KB program does something that looks impossible, the first natural question is: "who was the lunatic who made this?"

And what about Brazil?

There is a Brazilian demoscene, but we never had anything comparable to the scale of Finland, Germany or Poland.

There are records of Brazilian groups and productions going back to the 1990s, but events were sporadic. One particularly interesting case was Art Engine 2012, held from February 3 to 5 that year in São Paulo. According to Demozoo, it was the first demoparty held in Brazil in fifteen years. There were competitions for demos, game development, graphics, music and wild productions. (demozoo.org)

That says quite a lot about the size of our scene.

Fifteen years between two demoparties is not exactly a packed calendar.

Within Latin America, Argentina had a more visible presence, especially through Flashparty, created in the late 1990s.

I have always found it curious that Brazil never developed a larger demoscene. We have a history of computing, electronic music, piracy, BBS culture, hacking, free software, digital art and a fairly healthy number of people who take things apart simply to find out how they work.

The ingredients were here.

Perhaps what was missing was precisely a strong tradition of demoparties capable of turning isolated individuals into a scene.

A subculture does not emerge simply because there are people interested in the same thing.

They have to meet.

From pirated floppy disks to cultural heritage

The best plot twist in this story happened recently.

The demoscene began receiving official recognition as intangible cultural heritage in several European countries.

Finland opened the way in 2020. Germany followed in 2021. Poland and Switzerland recognized the scene in 2022, the Netherlands in 2023, Sweden and France in 2025. In April 2026, Norway became the eighth European country to include it in its intangible cultural heritage. (demoscene-the-art-of-coding.net)

It is worth making a distinction here because this subject is often oversimplified. This does not mean that "UNESCO declared the demoscene a World Heritage Site," as if it were the Acropolis or the historic center of Ouro Preto. These are national registrations in inventories of intangible cultural heritage aligned with the mechanisms and principles of the UNESCO convention. The Art of Coding initiative, founded in 2019, works specifically to promote the recognition of the demoscene as digital culture. (demoscene-the-art-of-coding.net)

Even with that clarification, the trajectory remains wonderful.

In the 1980s, teenagers were modifying pirated games and putting their nicknames in front of them.

Forty years later, European governments are discussing how to preserve that culture.

I doubt anyone involved in the first cracktros had exactly this plan.

Software can be culture too

Perhaps this is what interests me most about the demoscene.

Today we are surrounded by software and, paradoxically, we think very little about software as a form of cultural expression. We talk about cinema as art, music as art, architecture as art and photography as art, while programs are still treated mainly as commercial tools.

The demoscene disrupts that division.

There, code is not hidden behind the work. The code is part of the work. The way a program exploits a particular machine, generates an image or works around a limitation is part of the experience just as much as the music or visual result.

That also explains why watching a video of a demo and running the original demo are not quite the same thing.

The video shows the result.

The executable shows the entire idea.

There is something almost handcrafted about knowing that a file contains enough instructions to turn silicon into image and sound, and that someone spent nights trying to remove another twenty bytes because the executable was too large for the competition.

I do not think the lesson of the demoscene is that all software should be 4 KB. That would be a fairly stupid conclusion.

The lesson is something else.

Limitations can create language.

Knowing a tool deeply enough allows you to start using it in ways its creators never imagined. And programming does not have to exist only to automate a company, sell a subscription, serve advertising or close a Jira ticket.

Sometimes you program simply because you want to create something beautiful.

Or strange.

Or technically absurd.

Sometimes you want to find out how far a machine can go.

And there is something rather healthy about a culture that, after forty years, can still look at a computer and ask the simplest possible question:

"Can it be done?"

Bad luck for the computer when the first answer is no.

Read more

Pablo Murad pablomurad.com

Bridging ErsatzTV and Owncast

I haven’t been building anything lately, just maintaining what I already have. Watching, taking notes, and thinking.

But I’ll leave a small note about something I built in the past and have been “refining” right now, which was basically a channel using Owncast. This little adventure taught me how to understand two pieces of software: Owncast itself, and the other one was ErsatzTV.

I had always wanted to learn how to use ErsatzTV, but until then I never really had a reason to. And I have to admit, the only reason I hadn’t tried it before was because the latest news I had read said that the developer had abandoned the project. Apparently not after all...

I had already written before about how I exposed my CGNAT to the internet in an extremely functional way, which allowed me to host several applications cohesively without depending on Cloudflare. In fact, maybe someday I’ll write more about it and explain this architecture that I’m so proud of in greater detail.

My problem now was figuring out how to run a 24/7 channel (at least whenever I wanted) while keeping it lightweight on the internet. Hosted on Unraid.

On Unraid, I already had Owncast and ErsatzTV properly configured, but something was missing in between, something to push the stream. So I created a Frankenstein image that I called Owncast-Feed.

Why it exists

I have two pieces that don’t speak the same language:

ErsatzTV — creates a 24/7 “TV channel” (channel 1 = MadArabTV) and makes it available as HLS (.m3u8), which is a playback format (the player pulls the stream).

Owncast — is mine public streaming platform, but it only accepts input through RTMP, an ingest format where something pushes video into it, just like OBS does with Twitch/YouTube.

What’s missing is a bridge between the two: something that pulls the HLS stream from ErsatzTV and continuously pushes it as RTMP to Owncast. That “something” is owncast-feed: a container that does nothing but run a single ffmpeg process performing this stream conversion, with no interface, 24 hours a day while it’s running.

how it works

How it works (the ffmpeg)

The core is a single ffmpeg command that:

Reads the HLS stream from ErsatzTV (-i http://192.168.50.7:8409/iptv/channel/1.m3u8), using reconnection flags (-reconnect ...) to survive network fluctuations.

Normalizes the video using filters: fps=30 (forces a constant frame rate), scale/pad to a fixed 1920×1080 resolution (adding black bars when necessary).

Re-encodes the video as H.264 on the GPU (-c:v h264_vaapi) at 3000 kbps, and the audio as AAC with aresample=async (which corrects audio drift).

Pushes the result as FLV/RTMP to Owncast (-f flv rtmp://192.168.50.7:1935/live/<streamkey>).

The key decision: why re-encode instead of using copy?

This is the most important part of the design. Using -c copy (passing the stream through without re-encoding) would use almost no CPU, but it would break everything.

ErsatzTV switches programs all the time, and every switch creates timestamp discontinuities in the HLS stream. If those discontinuities were passed directly into RTMP, Owncast would drop every viewer whenever the channel changed videos.

Re-encoding with fps=30 (CFR) + aresample “stitches” those transitions together into a single, continuous stream with no gaps.

That’s why re-encoding is intentional, it’s what ensures that nobody gets disconnected from Owncast when the channel changes videos.

And I think, once again, that’s all...

Read more

Pablo Murad pablomurad.com

No Gods, No Kings

The other day, I was watching podcasts featuring the Brazilian writer Jan Val Ellam (the pseudonym of Rogério de Almeida Freitas). I like him a lot, despite not believing in the spiritual and cosmicist theories he explains in the form of “spiritual gossip.” However, Jan seems very lucid and confident about what he says, which makes me pay attention, even though I disagree with many things, as I have already said.

He always brings up very interesting theological and technological reflections that, in the end, would make excellent fiction books.

But I cannot deny it: reality, first, is shaped in fiction.

I am not going to go deeply into the general points discussed by Jan, but rather into factual things that are widely known throughout history: the theology of religions.

Jan claims to have studied more than 100 religions in depth, and while that is curious, it is neither impossible nor unlikely. The knowledge he expresses can be compared with and verified through the literature.

He even makes a very interesting connection between religions, stating that almost all of them have some form of the trinity. Interesting, right? And throughout the conversations, he keeps showing this. How humans recognize God and how the trinity makes itself present here and there, sometimes indirectly. And it is not even because of syncretism.

The fact is, one word caught my attention, and it was the word “all” in the phrase “all religions.”

So I began researching Western and Eastern religions, with the intention of finding one in which deities, gods, or supernatural influences in general do not exist.

And look, none of what I researched or studied was in-depth, but I started from what seemed to me to be the most sensible beginning, which was the religion of ancient Egypt (and yes, I know it is not the first documented religion).

Hehe, I should mention that it was during this research that I discovered the existence of two cities called Thebes. One in Egypt and another in Greece. And I discovered that the myth of Oedipus and the Sphinx is Greek, even though the Sphinx is Egyptian. Pretty crazy, isn’t it?

Anyway, setting aside my pauses for reflections and daydreams, I surprisingly found this culture without deities in Brazil: the Pirahã people, located in the Brazilian Amazon. These people were studied extensively by the linguist and anthropologist Daniel Everett.

The Pirahã people are widely cited as perhaps the only non-theistic culture in the world. Look how interesting: they have no creation myth, they do not believe in any supreme or creator god, they do not pray, and they have no religious hierarchy. They believe only in what they can see or in accounts from people who witnessed something directly.

Then I wondered how these people viewed death, and the answer was even more interesting: “the Pirahã people are strictly focused on empirical experience and the present; they have no mythologies about heaven, hell, or reincarnation.”

So when a person dies in the village, death is pragmatically accepted as a biological fact of the natural world.

The Pirahã people have NO kind of myth whatsoever.

It is a culture shaped through direct testimony.

I think modern human communication would be more effective if it were based on the Pirahã people.

Anyway, just a late-night reflection.

Some random data:

* Cosmicism, in the Lovecraftian sense, is basically the idea that the universe is so vast, ancient and indifferent that humanity means absolutely nothing to it. There is no promise that reality was made for us, no guarantee that it is understandable, and certainly no reason to believe that whatever exists beyond our little corner of existence would care about us. In Lovecraft, the horror often comes from discovering too much, because the closer a person gets to understanding what reality really is, the more fragile human ideas like importance, order, morality and even sanity begin to look.

The Pirahã people have an estimated population of between 800 and 900 people. They live in villages located mainly along the Maici and Marmelos rivers, in the state of Amazonas, Brazil.

Map showing the location of the Pirahã people.

That's it. Thank you.

Read more

Pablo Murad pablomurad.com

a movie to remember: Empire Records

I remember when I first watched Empire Records. It was sometime around the year 2000. I was still a teenager, and it had probably been about five years since its release. I also remember the feeling the film left me with: a sense of belonging.

Although it is technically a simple story in which a group of young people spend a day trying to save the small record store where they work, while each of them deals with their personal dramas, insecurities, and a few romances, what makes the film special is not the plot. It is the atmosphere.

For them, the place was not just a store. It was their meeting place and their refuge. It basically made them a family, surrounded by countless CDs and posters.

Nowadays, rewatching it makes me feel somewhat nostalgic, because I am forced to remember a time when, in order to discover music, you had to visit a record store, and that was, in fact, magical. I would also like to give an honorable mention here to the “Disco-briu” record store in my hometown, which possibly closed around the same time I first watched Empire Records. But the film captures a feeling shared by everyone who lived through part of the 1990s: the intimate relationship between music and identity, combined with youth.

Damn the man. Save the Empire.

Read more

Pablo Murad pablomurad.com

Ghost CMS on Debian

I haven't had much time to post. A lot has been happening in my life: losses, goodbyes, and changes (something I hate). But this morning, when I sat down in front of the PC and saw that my server had run into a small problem that prevented access to some of my sites, I fixed it right away and brought all the services back up. The last one was this site, which I stared at for about 20 minutes, frozen.

I've had a few websites built 100% by hand (and almost all of them were on this domain), and I loved it. I've always been terrible at layouts and design, which is good for me because I was constantly changing everything here on the site. It never stopped and eventually became exhausting. From complex to minimalist.

But this year, specifically this year, along with everything life threw at me, work consumed me almost completely. With that said, I needed to move to something faster to update, and since I didn't want WordPress, I chose Ghost.

I'd used Ghost before and had always liked it. I even tried other frameworks, but Ghost was by far the one that gave me the most satisfaction.

But now I had a different little problem when it came to getting this framework running, and that problem was Debian. I knew the documentation and knew Ghost had been designed for Ubuntu, but in theory it would run on Debian with one or two workarounds.

Everyone who has installed Ghost with ghost-cli knows the first frustration: the official tool only embraces Ubuntu LTS. Run ghost install on Debian and it knocks on the door, performs a stack check, sees ID=debian, and simply refuses to continue. The message is clear:

Unsupported system.

But "unsupported" doesn't mean "impossible." At its core, Ghost is a Node app with three real requirements:

  • Node 22
  • MySQL 8
  • A process manager, with the app served behind a reverse proxy with TLS

None of that is exclusive to Ubuntu.

ghost-cli only assumes Ubuntu so it can automate those pieces. If you provide each one yourself, using the proper Debian equivalent, Ghost runs smoothly.

That's exactly what I did on my server, running Debian 13 "Trixie." Here's the recipe for this little achievement.

Table of Contents

  1. Disable the Gatekeeper
  2. Node 22 from the Right Source
  3. MySQL 8 via Percona
  4. systemd Is the Part That Just Works
  5. The Split That Brings Everything Together

1. Disable the Gatekeeper

ghost-cli v1.29.3 refuses anything that isn't Ubuntu during the stack check. The key is to bypass that check and install Ghost without letting it block the process because of the operating system, while taking responsibility for the dependencies myself. From that point on, it treats the installation like a normal production instance: versioning, systemd, updates, everything.

2. Node 22 from the Right Source

Ghost 6 requires Node 22, and the Debian repository doesn't reliably provide that version. The clean solution is the official NodeSource repository at deb.nodesource.com/node_22.x. This makes /usr/bin/node exactly the 22.x version Ghost requires, with no hack and no need to compile anything.

3. MySQL 8 via Percona

This is the obstacle that defeats most people. Ghost 6 requires MySQL 8 and refuses MariaDB, while Debian offers MariaDB by default. Installing Oracle's MySQL on Debian is annoying.

The elegant way out was Percona Server 8.0, a drop-in server that is 100% protocol-compatible with MySQL 8.

4. systemd Is the Part That Just Works

This one came for free. ghost setup systemd generates a service with User=ghost, ExecStart=node ghost run, and Restart=always. Since Debian's systemd is identical to Ubuntu's, the service came up verbatim, without a single line of adjustment. It's proof that much of the "Ubuntu-only support" is more convention than technical necessity.

5. The Split That Brings Everything Together

The trick that makes all of this solid is not letting ghost-cli handle the edge. Nginx and TLS are used the way they always have been: nginx handles the reverse proxy and terminates HTTPS with a Let's Encrypt certificate, forwarding requests to Ghost at 127.0.0.1:2589. ghost-cli handles only the portable parts, the Ghost application and systemd.

The result is a clean split:

  • CloudPanel: nginx, TLS, and Percona/MySQL 8, the "Ubuntu-specific" part that causes trouble in ghost-cli
  • ghost-cli: the Ghost app and the systemd service, the OS-agnostic part

In the end, Ghost's "Ubuntu-only support" is, in practice, support for the automation, not an engineering constraint. When you break the requirement down into its real parts, each one has a legitimate replacement on Debian. The final trick is remembering to pass the stack-check bypass during updates with ghost update, and never letting ghost-cli try to touch nginx or TLS.

I think that's basically it, if memory serves.

Sorry for disappearing. I'm sorting out my life, and I'll get back to posting more.

Read more

Pablo Murad pablomurad.com

a new project is on the way

Two years ago, I worked as a director at Genmap, in a kind of interim position that combined the roles of company director and project director. It was one of the best experiences I've ever had. As someone who programs as a hobby, I learned a lot from the company's professionals.

And I learned. I learned a lot about crawlers.

After all, Genmap is a Brazilian company that specializes in sitemaps.

That time at the company was truly incredible. We built so many engines and bots that I lost count, with new features every day, all designed to find as many links as possible on a website (after all, that's what a sitemap does).

I learned about crawl depth, crawling, concurrency, and other incredible related topics that I'll talk about another time.

The Idea

Last night, I called a former coworker. We stayed on a video call for almost an hour because I couldn't get an idea out of my head.

The idea was to build a crawler for the IndieWeb.

No admin panel, dashboard, or anything else. I would use only one or two seed URLs as starting points, then let it crawl as much as it could handle.

My questions for my former coworker were things like:

•     What's the logic behind search engines?

•     How much hardware would a given task require?

•     What about bot blocking?

•     What about robots.txt?

And many others.

There really were many more questions. I needed to cut the conversation short before it ran all night.

Reverse Scope

Well, as with any other project, I start by writing down what I don't want it to be. I write down everything my project should stay away from. What remains is what it should be, what it could be, or what it could grow into.

It's more or less like saying, "This water won't be coffee..." You can understand that as, "Then it could be any kind of juice."

This way of thinking has always kept me optimistic about everything I've done in life, because if I knew where not to go, every other path was an adventure and any result was satisfying.

I had made a decision. I needed to find experienced developers to build an engine for the IndieWeb. That would take money, time, and attention. And, of course, every bit of help I could get.

From 10:00 p.m. until a little after 11:00, I thought about and wrote down everything my project shouldn't be. And look, I had the perfect reverse scope, hehe.

Finding the People

I joined my friends in the Portal IDEA channel on our private IRC network and dropped the bomb. In less than an hour, I had about four people interested. They seemed genuinely interested because we were doing it for the love of it and to learn.

I offered to cover the infrastructure. They would take care of the code.

After a few very complicated weeks in my life, I was actually pretty excited to help make this project happen.

Now We Wait

Now we'll wait a few months and see what happens...

Read more

Pablo Murad pablomurad.com

The Wayseer Manifesto

Attention, all you rule breakers, misfits, and troublemakers. All you free spirits and pioneers, all you visionaries and nonconformists. Everything the establishment told you was wrong with you is exactly what is right with you. You see things other people don't. You're wired to change the world. Unlike nine out of ten people, your mind can't be repressed, and that threatens authority. You were born to be a revolutionary. You can't stand rules because, in your heart, you know there is a better way. You have strengths the establishment considers dangerous, and it wants them eliminated. So, your entire life, you've been told that your strengths were weaknesses.

Jobs

I'm telling you the opposite.

Your impulsiveness is a gift. Impulses are your key to the miraculous. Your distractibility is evidence of your inspired creativity. Your mood swings follow the natural pulse of life, giving you unstoppable energy when you're high, then deep and moving insight when you're low. Labeling you with a disorder is society's newest way of denying its own sickness by pointing a finger at you. Your addictive personality is a symptom of your vast, underused capacity for heroic creative expression and spiritual connection.

Your complete lack of inhibition. Your wide-eyed idealism. Your utterly open mind.

Has no one ever told you? These are the strengths shared by the greatest pioneers and visionaries. Innovators, revolutionaries, procrastinators, drama queens, social activists, daydreamers, nonconformists, philosophers, outcasts, people in suits and ties, football stars and sex addicts, celebrities with ADD, novelty-seeking alcoholics, first responders, prophets and saints, mystics and agents of change.

We're all the same, you know. Because we're all touched by the wave.

We're all the same, you know. Because we're all drawn to the flame.


You know in your heart that there is a natural order. Something more sovereign than any rule or law made by human beings could ever express.

That natural order is called the Way.

The Way is the eternal substrate of the cosmos. It guides the joyful currents of time and space. Some know it as the will of God, divine providence, the Holy Spirit, the implicate order, the Tao, reverse entropy, the life force. For now, let's simply call it the Way.

The Way is reflected in you as the source of your inspiration, your passions, your wisdom, your enthusiasm, your intuition, your spiritual fire, your love. The Way takes the chaos of the universe and breathes life into it, giving it divine order. When expressed through the mind, the Way is genius. When perceived by the eyes, it is beauty. When felt through the senses, it is grace. When allowed into the heart, it is love.


Most people can't perceive the Way directly.

But then there are the wayseers, the keepers of the flame.

Wayseers have an inexplicable gift for simply knowing the Way. They feel it in their own being. They can't tell you why or how they arrived at the right answer. They just know it at their core. They can't show you how they got there, so don't ask. Their minds simply resonate with the Way. When the Way is present, so are they. While others are blind to it, and society begs you to ignore it, the Way stirs inside you.

Neurological repression blocks most people's awareness of the Way. Your prefrontal cortex, the Gestapo of the brain, censors every thought and impulse rising from the unconscious. Nothing that violates its social programming is allowed through.

But your mind is different.

Your mind was thrown wide open to the Way. Through some miraculous genetic trait, some psychotropic chemical, or perhaps even the will of your own soul, your brain's reward pathways were hijacked. Dopamine was recruited to overthrow the fascist dictatorship of your prefrontal cortex. Now your brain is free from repression. Your mind is free from censorship. Your consciousness is exposed to the turbulent seas of the unconscious. Through that open door, divine light shines into your awareness and shows you the Way.

That is what makes you a wayseer.


Ninety percent of human civilization is populated by people whose brains are closed to the Way. Their minds are programmed to enforce the social doctrine installed in them from birth. Unlike you, they can't break through that programming because they haven't yet experienced the necessary revolution of the mind.

Programmed people take social institutions and rules very seriously. Society is packed with games designed to keep people's minds occupied so they won't revolt. These games often create unhealthy fixations on peculiar protocols, power structures, taboos, and domination. They are all subtle forms of human slavery.

This particular kind of madness is tolerated by the masses.

It is demanded.

The programmed believe in the rules so fiercely that they become willing to destroy anyone who breaks them. Wayseers are the ones who expose them.

Because their minds are free to reject social programming, wayseers can see these institutions for what they are: imaginary games. Wayseers comfort the disturbed and disturb the comfortable. Helping those who are lost inside these games, even when they refuse to help themselves, is the calling of many wayseers.

Wayseers remain in contact with the original source of reality. That is why they can disrupt social conventions and even governments, forcing humanity back into alignment with the Way. They are an ancient lineage, a kind of priesthood, bearers of the flame, the ones who know.

There must always be wayseers to reform the dizzying, psychotic machinery of society, those gigantic and mindless hamster wheels that blot out the clear blue sky while keeping humanity chained inside a darkened cage.

And so wayseers are called to shine a light on society's madness, continually bringing the timeless, transcendent spirit of truth back to life.

Wayseers reveal that divine truth by giving themselves to the birth of something creative or disruptive: art and philosophy, innovations that shake industries, revolutions for democracy, blows against hypocrisy, solidarity movements, changes that leave a legacy, rebellions against policy, technology filled with spirit, moments of clarity, things that challenge barbarism, milestones of sincerity, monumental acts of charity.

We're all the same, you know, because we're all touched by the Way.

We're all the same, you know, because we're all drawn to the Way.


This is your calling, wayseer.

You've found your tribe.

Welcome home.

Read more

Pablo Murad pablomurad.com

the dawn of rss feeds

The web had a simple promise: any site could publish a feed, anyone could subscribe, and nobody in the middle got to decide what you saw. RSS made that work for twenty years. What it never had was the conversation. You read someone's post in your reader, but replying means going to that person's platform. Suddenly you're back inside the walled garden RSS was meant to avoid.

Social networks solved the conversation and threw away the rest. The feed belongs to someone else. An algorithm decides the order. Your identity is a username the platform lends you and can take back. Leaving one network means starting from nothing on another, because what you wrote and the people who followed you stayed behind.

RSS Expert wants both things at once: the openness of RSS and the conversation of social networks, without an owner standing in the middle. You read feeds as usual. When you reply, that reply is published in your own feed, with a link to the original post. Nothing is written on somebody else's server. The other side discovers the reply because it's in the feed and because the system sends a Webmention.

The conversation happens, but it remains yours, at your address.

What it is

One static binary, one SQLite file, one container.

The only JavaScript is a twenty-line island that reveals a "new post" notice. Every page works without it. There's no CSS framework, no build step for the assets, and no separate database server to bring up. That's deliberate. One person should be able to run the whole thing on a small server and understand all of it.

These ideas hold up everything else.

Provenance is first-class information

Most systems store "this post exists." This one stores "this post was seen in this form, from this source, at this time, and I chose this version for this reason."

A post arriving through two paths isn't overwritten. Both observations remain recorded, and convergence chooses a winner deterministically while showing why. The timeline separates what was written here from what arrived from elsewhere, and it never forgets where something came from.

The Where it went screen shows every feed carrying one of your posts and every notification that was sent, including the ones that failed.

Your domain is your identity

You prove that a site belongs to you using rel=me and an h-card verified in both directions. It becomes your name in the system.

It isn't an account somebody lends you.

Federation isn't optional

It's the point. Being open and alone isn't very useful. The system speaks the protocols other open networks already speak instead of inventing its own.

Who it talks to

On the RSS and IndieWeb side, everything works without anybody else having to run this same program:

  • It reads RSS 2.0, Atom, JSON Feed, h-feed, and OPML.
  • It publishes a per-user feed, a site-wide feed, and a reply feed for each post. Any reader can subscribe.
  • WebSub and rssCloud work in both directions. As a subscriber, RSS Expert discovers a feed's hub or cloud and receives posts as soon as they're published. As a publisher, it is its own hub and its own cloud, with no third-party service in between.
  • Webmention tells the other side about a reply, and Micropub lets another application publish through it.

On the fediverse side, enabled with RSS_EXPERT_ACTIVITYPUB:

  • @yourhandle@rss.expert becomes an address anyone on Mastodon can find and follow. When you publish, the post appears in their timeline.
  • Conversation crosses in both directions. A reply written on Mastodon joins the thread here, and a reply written here reaches the remote author's inbox.
  • Editing sends an Update. Removing a post sends a Delete. Likes and boosts are counted. HTTP signatures support both the newer standard, RFC 9421, and the older draft Mastodon still uses. The system remembers which one each server accepts.

What it's for, and who it's for

It's for someone who wants to read the open web in one place, publish without depending on a platform, and talk to people on other networks while keeping their identity, history, and provenance on their own side.

A blog that is also a reader and a fediverse account, without becoming three different services.

It isn't for everyone. If you only want to post something and be seen by a lot of people quickly, a large network will serve you better. RSS Expert trades reach for ownership. Fewer people will find you for free, but what's yours stays yours, and nobody in the middle decides what happens to it.
Why it's built this way

Every major choice has a recorded reason in docs/decisions/, in the ADRs. These are the big ones:

  • Small on purpose. A static binary without cgo, a FROM scratch image, and SQLite instead of a database server. It can run on almost nothing, and there are fewer things waiting to break.
  • No outside library for the sensitive parts. ActivityPub HTTP signatures were written by hand and tested against known vectors instead of inheriting an abandoned dependency. TOTP follows the same discipline.
  • Security defaults to the safe choice. Every outbound request passes through an SSRF guard, checked after DNS resolution and before connecting, on every hop. Upload types come from their bytes, files are decoded before storage, and metadata is stripped. When a setting is a security decision, its default is the safe one.
  • It can't look AI-made. The code reads like a person wrote it. The visual design follows real reference pages, with no purple gradient, glassmorphism, or emoji in the interface. Every color and size comes from one token file.

Where the ideas came from

The implementation is independent. No code was copied from another project.

But the interoperability knowledge that makes it possible came from other people's work: RSS, OPML, rssCloud, and Dave Winer's Textcasting; Ricardo Mendes's RSC, which proved the idea could work and gave this project a map; Micropub, Webmention, and the IndieWeb microformats; and ActivityPub and ActivityStreams from the W3C.

Where it is

rss.expert, version 0.0.1, in testing.

The federation loop has been proven between two instances I control and by a large test suite. One check remains, and no automated test can cover it: a real mastodon.social account following @pablo@rss.expert, with the conversation actually crossing both ways.

Until that happens, "it works" describes the code.

It doesn't yet describe the world outside.

Read more

Pablo Murad pablomurad.com

Your Recovery Codes Need a Better Home

Imagine a very bad Tuesday.

Your phone is dead. Your laptop was stolen. You try to open your email on another computer, but it asks for a code from the authenticator app that was on the phone. Fine, you think, the recovery codes are in the password manager. Then the password manager asks for the same missing second factor.

The backup file was on the laptop.

Its second copy was in cloud storage connected to the email account you can't open.

Nobody hacked you. You're still locked out.

This is the stupid side of good security. We spend time protecting accounts from strangers and then build a recovery process that depends on every device and service working normally. Of course it looks safe on an ordinary day. Recovery codes exist for the day that isn't ordinary.

The question seems simple: where should I keep these codes?

The honest answer is more annoying. There isn't one perfect place. You need a few places that fail differently, and the arrangement has to remain understandable when you're tired, worried, using an unfamiliar computer, or explaining it to someone who doesn't care about your beautiful security system.

That last part matters.

Recovery material is a key

A recovery code isn't a harmless note. Whoever has it may have a way into the account, sometimes with only one other piece of information. Treating it like a receipt in the Downloads folder is strange when you think about what it can do.
Services also use similar names for different things. Google gives you a set of single-use backup codes. Microsoft uses a 25-digit recovery code and replaces the old one when a new code is generated. Apple's recovery key is a 28-character secret with much heavier consequences. If you enable it and later lose the key along with access to a trusted device, Apple says you can be locked out permanently.

Then there are TOTP seeds, Emergency Kits, passkeys, spare security keys, and provider-specific recovery contacts. They don't behave in the same way. A one-time code can be crossed out after use. A TOTP seed can reproduce authenticator codes again and again. A hardware key sitting in a drawer is useless unless it was already registered with the account.

So the first job is identification. Write down what the item actually is, which account it belongs to, when it was created, and whether using it invalidates anything else.

Plain names help. Mysteries don't.

Look for the circle

Before buying a safe or making an encrypted container, test the dependency.

If the account disappears from your life for one hour, can you still reach its recovery material without using that account?

Google codes stored only in Google Drive fail this test. An Apple recovery key kept only in iCloud Notes fails it too. The Emergency Kit for a password manager can't live exclusively inside that password manager. An encrypted file isn't very impressive when its only passphrase is stored inside the file.

These arrangements can survive for years without showing the problem. That's why they're dangerous. The trap becomes visible at the exact moment you need the exit.

Apple tells users to print or write down the recovery key, keep it somewhere safe, and consider more than one location. The company specifically warns against leaving the only copy in Apple Passwords, iCloud Photos, Notes, or iCloud Drive. NIST's current authentication guidance also describes saved recovery codes as secrets intended to be kept offline and stored securely.

Paper, apparently, is still alive.

The paper envelope is boring and excellent

Print the critical codes or write them very clearly. Put them in an opaque envelope. Add the date, seal it, sign across the seal, and store it with documents that already deserve protection.

That signature won't stop a determined person. It can tell you that the envelope was opened, which is useful. If the seal looks wrong, enter the accounts through a normal method and regenerate the exposed codes.

The paper inside should be understandable without a tutorial. It needs the service name, account identifier, official recovery address, generation date, number of available codes, primary MFA method, and the location of another valid route. Avoid screenshots when plain text will do. Interfaces age. Text survives.

A small notice on the envelope is enough:

EMERGENCY DIGITAL ACCESS
Prepared: YYYY-MM-DD
Review after: YYYY-MM-DD
If this seal is broken unexpectedly, replace every code.

Don't write every secret you own on the same unprotected page. A password, its TOTP seed, and the recovery codes together can become a complete account takeover kit. Some family or succession plans may need all the pieces, but then the physical protection and the person holding the package become far more serious decisions.

And check the box itself. A thin metal box isn't magically fireproof because a store put the word “safe” on it. Look at its real document rating, including time, temperature, and water protection.

Paper can burn. It can get wet, become outdated, or be photographed. This is why the envelope is a fallback, not the entire plan.

The encrypted capsule

Alex Chan wrote about keeping his recovery material in a small, encrypted disk image, with offsite backups and a paper copy planned for a fire safe. The useful part of that solution is that the encrypted container can travel while the files inside remain simple.

The container might be a protected disk image, an encrypted virtual disk, or a small VeraCrypt volume. Inside it, use files that should still open years from now: Markdown, plain text, a self-contained HTML page, perhaps the original PDF supplied by a service.

No custom app. No database that requires an abandoned framework. No personal cipher based on a poem you expect your future self to remember.

Keep the container small and copy it to more than one medium. One copy can stay on the computer, another on disconnected storage, and an encrypted copy can live outside the house. Cloud storage is acceptable for the already encrypted file, provided the passphrase doesn't depend entirely on that same cloud account.

The passphrase needs its own exit. A sealed copy at home can work. A password manager plus an independent physical record can work. Hiding four characters in a photograph from 2009 is how a practical plan turns into folklore.

An encrypted USB drive is still a USB drive. It can fail quietly, disappear in a pocket, or sit unread for years. The encryption protects the contents from whoever finds it. It doesn't make the device immortal.

The password manager problem

Keeping ordinary recovery codes in a password manager is convenient. Search works. Updates are easy. It is vastly better than forgetting them in Downloads.

The problem begins when the manager contains the only recovery route for itself, the primary email account, the phone ecosystem, and every other account capable of resetting the rest. What appears to be a collection of separate protections can collapse as one object.

Password managers with emergency features can help. Bitwarden Emergency Access lets a designated contact request access after a waiting period. The 1Password Emergency Kit contains information needed to set up the account on a new device and is meant to be stored safely.

But a feature nobody configured is decoration.

The contact has to accept. They need to understand when access is allowed, where the instructions are, and what they should never send through chat or email. The password manager itself still needs a route that doesn't depend on opening the password manager.

The setup that makes sense

A three-location recovery plan with an encrypted capsule, a paper envelope in a home document box, and a separate offsite copy

For someone with personal accounts, domains, self-hosted services, and a reasonable tolerance for technical work, a layered setup is the sensible choice.

The working copy is the one available quickly. Ordinary account codes can stay in the password manager. Critical material can also live in the encrypted capsule on the computer, opened only when something needs to be read or changed.

The local physical copy is the sealed envelope in a safe or protected document box. It needs no internet connection, subscription, operating system, or healthy SSD. That's a surprisingly useful list of properties.

The offsite copy lives at another address. It may be another sealed envelope with a trusted person, or an encrypted container whose passphrase travels through a separate route. Another drawer in the same house doesn't count. Neither does a second disk permanently connected to the same machine.

Then add another authenticator where the service allows it. A spare security key is a cleaner first fallback than consuming a recovery code, but only when it was registered in advance. Yubico recommends enrolling the spare at the same time as the primary key and storing it somewhere safe and accessible.

This arrangement covers different failures without becoming a small religion. The digital copy handles routine device loss. Paper remains readable after computer trouble. The offsite copy survives the event that takes the whole house. A second authenticator may avoid the recovery process completely.

Neglect can still ruin it. An envelope full of invalid codes is a very organized way to remain locked out.

Start with the accounts that control the others

Primary email comes first. Then the password manager, phone or operating-system account, domain registrar, cloud storage, code repository, and infrastructure providers. Financial accounts follow their own official recovery rules and deserve the same attention.

These are root accounts. If one of them falls, several others may follow. Protecting a hundred minor logins while the primary email has one fragile recovery route is excellent filing and bad prioritization.

People who run servers have more roots than they think. The domain and DNS provider matter. So do the VPS panel, Tailscale or another administrative network, external backups, the source forge, transactional email, and any control panel that can reset access or destroy machines.

Don't store the only recovery vault on the server it is supposed to help recover. This sentence sounds obvious. Plenty of backup systems contain an equally obvious joke.

Recovery codes don't replace SSH key management, configuration backups, restore notes, or access procedures. Keep those systems connected in the inventory, but don't throw every secret into one convenient package.

A plain inventory is enough:

Service:
Account identifier:
Official recovery page:
Primary MFA method:
Registered alternate method:
Recovery material created:
Codes remaining:
Last checked:
Working copy:
Local physical copy:
Offsite copy:
Next review:
Notes:

The inventory can stay separate from the secrets. Its job is to tell you what exists and where, including which items were deliberately kept elsewhere.

Test while the door is still open

Don't begin with the account that controls your entire digital life.

Choose a low-risk service that provides several recovery codes. Confirm the password and another MFA method first. Open a private browser window, retrieve one code through the route you designed, use it, and mark it as consumed immediately. Then check every copy that contains the individual codes.

For a critical account, you can rehearse without entering a code. Pretend the phone and computer are gone. Can you locate the instructions? Can you obtain the container passphrase? Is the spare key actually registered? Does the official recovery page still exist?

GitHub warns that support can't restore access when two-factor credentials and every recovery method are gone. If no recovery option works, the account may be permanently lost. That's the sort of policy worth discovering during a test, with a normal session still open.

Review the system after a move, a compromised computer, a broken seal, a changed custodian, or any provider change that replaces old codes. Google and Microsoft invalidate previous sets when new ones are generated, so keeping several generations “in case” creates confusion instead of safety.

An annual check is reasonable for the whole kit. A lighter check every few months makes sense for the root accounts. Weekly maintenance would turn this into a chore, and chores have a way of being abandoned.

The first version doesn't need to be elaborate. Identify the accounts that can recover the others. Generate fresh codes through their official pages. Print and date them. Put one protected copy at home and another at a genuinely different location. Register the spare factor now, while you can still sign in normally.

Then test one unimportant account.

That's enough work for one afternoon, and the result should still make sense on the next bad Tuesday.

Sources

Read more

Load more